来源:Leveraging large language models for metabolic engineering design(Trends in Biotechnology)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
代谢工程长期依赖试错法寻找有效的基因改造靶点,效率低下。本研究构建了D2Cell平台——一个整合文献文本挖掘、代谢工程数据库与混合机器学习预测模型的系统框架。研究者利用大语言模型从科学文献中提取超过29 000条数据条目,建立了涵盖751株菌株和1210种产物的细胞工厂数据库,并开发了预测基因改造对产物产量影响的D2Cell-pred模型。该平台在酿酒酵母香叶醇生产中成功识别并湿实验验证了新型基因组工程靶点,达到技术就绪水平4级。
研究背景
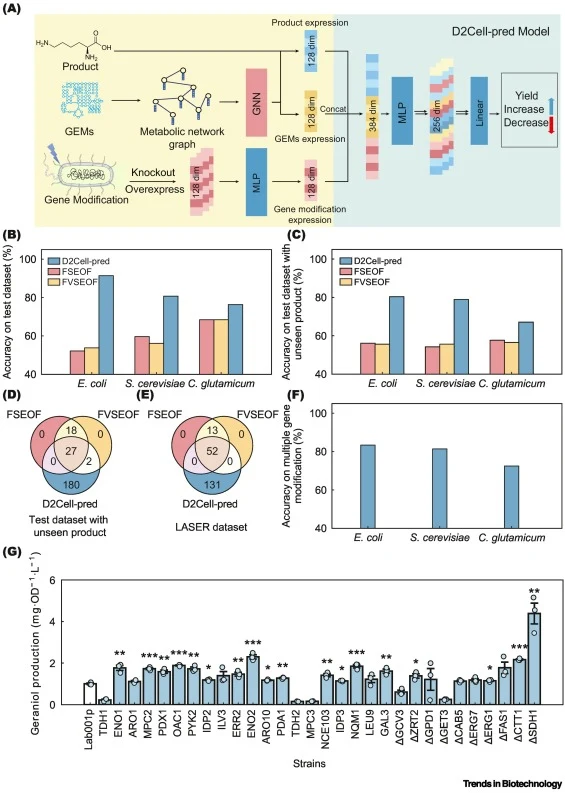
高效细胞工厂的构建是合成生物学的核心目标,旨在优化微生物和细胞系统以生产有价值的化学品、燃料和药物。然而这一过程本质复杂且高度迭代,往往需要在识别有效工程靶点上进行大量试错。基因组尺度代谢模型(GEMs)被视为代谢相关知识库,能够基于化学计量关系模拟细胞代谢,已被用于预测基因敲除、过表达和环境变化的影响。基于约束的方法如MOMA和ROOM可预测扰动响应,RELATCH通过相对最优性原则进行优化。双层优化方法如OptKnock和RobustKnock可识别下调靶点,FluxRETAP高效利用机制知识进行靶点预测。FSEOF和FVSEOF系统扫描代谢通量空间以识别基因改造靶点。尽管这些工具具有实用价值,GEMs仍面临预测精度有限等挑战。
研究方法
D2Cell数据库构建。数据来源包括从Clarivate Web of Science、美国国家医学图书馆PubMed和Scopus收集的10 000篇已发表研究论文摘要,以及手动收集的1340篇开放获取文章。这些代谢工程文献发表于2000至2023年,来自不同出版商团体(补充图2a)。研究成功识别、提取并标准化了总计29 006条数据条目。每条条目包含生物体、产物、产物滴度、基因改造、培养基设置、氧气可用性、体积和温度等详细信息。研究选取了873个涵盖不同代谢工程来源的文本片段用于NER任务,随后由多位合成生物学研究人员手动注释并交叉验证。
【数据】数据条目:29 006条;文献来源:Web of Science、PubMed、Scopus共10 000篇摘要+1340篇开放获取文章;NER标注文本:873段;文献发表年份:2000-2023年
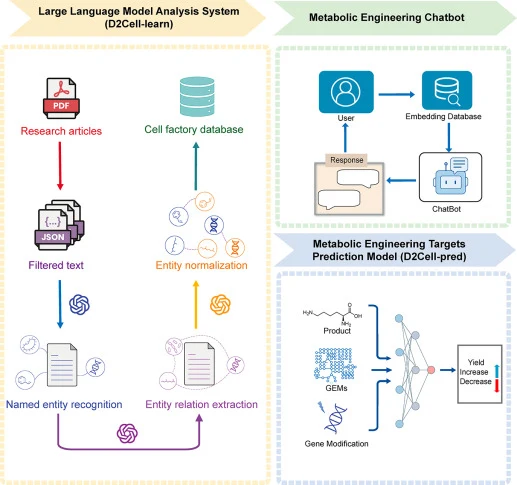
D2Cell-learn与数据提取。研究将文本挖掘工具D2Cell-learn分为三个部分:NER、RE和EN。对于开放获取文章,仅使用摘要、结果和方法部分。首先,在NER模块中,将文章分割为片段,使用Qwen1.5-Lora从研究论文片段中提取"菌株ID"和"基因"实体及相应提示。NER模块将提取的信息以JSON对象列表形式返回。尽管菌株ID在不同研究中通常缺乏标准化——通常包含作者首字母和数字如"QW101"或"SA-B4"——但研究认识到它们对于追踪同一研究中的基因改造非常重要。在此步骤中提取菌株ID实体使研究能够准确追踪基因改造关系,并确保后续关系提取步骤的精确性。在RE模块中,使用Qwen1.5-110B-Chat模型提取实体之间的关系。基于这些关系以及摘要、结果和方法部分的文本,研究构建提示以提取每条条目的实验条件,包括温度、容器、培养时间、培养基组成和碳源。此外,在EN模块中,研究使用UniProt的应用程序编程接口(API)[50]获取修饰基因的UniProt ID和GeneBank ID。同时,使用Python脚本从KEGG数据库[51]检索分类学ID、每个生物体的标准名称以及每个产物的KEGG ENTRY,随后从中获得相应的SMILES表示。对于没有KEGG条目的产物,研究查询了PubChem化合物数据库[52]——最大的化合物信息数据库——以获取相应信息。数据库托管在在线数据库网站(https://digitallifethu.com/d2cell)。本研究中使用的所有提示和代码均可在GitHub仓库中找到。
【数据】NER模型:Qwen1.5-Lora;RE模型:Qwen1.5-110B-Chat;数据库网址:https://digitallifethu.com/d2cell;提取实体类型:菌株ID、基因;提取条件:温度、容器、培养时间、培养基组成、碳源
大语言模型。由于需要处理长token和高性能,研究选择了开源大语言模型Qwen1.5 [20],能够处理多达32 768个token。考虑性能和效率,研究使用微调的Qwen1.5-14B-Chat模型提取菌株ID和基因实体。对于需要长文本输入的关系提取任务,由于硬件资源限制无法有效微调大于72B的模型,且较小模型在处理长文本时表现不佳,研究使用了未微调的Qwen1.5-110B-Chat模型。文本挖掘任务的提示见补充图16-22。研究使用LoRA(Hu, E.J.等,2022,ICLR,会议)有效微调了Qwen1.5-14B-Chat模型,该方法在显著降低计算需求的同时保持了全参数微调的大部分性能。研究使用Gemini Pro对100篇代谢工程研究论文的实体提取结果创建训练数据集,用于微调Qwen1.5模型。为减轻微调大语言模型(LLM)时的灾难性遗忘并增强模型的提取能力,研究使用IEPile数据集[53]中的20 000个样本扩充了训练集,该数据集包含多种实体的信息。模型训练10个epoch,学习率为5 × 10⁻⁵。使用Vllm(Kwon, W.等,2023,SOSP,会议)加速Qwen1.5-110B-Chat和Qwen1.5-14B-Chat的推理。作为基线模型,研究选择了广泛使用的大语言模型如GPT-4和Claude。然而,由于使用GPT-4和Claude运行D2Cell文本提取方法的成本较高,研究仅比较了不分割文本提取任务的提示与D2Cell方法。研究使用API密钥与ChatGPT和Claude交互,使用的模型版本为GPT-4o和Claude 2 Sonnet。
【数据】LLM:Qwen1.5,最大token:32 768;NER微调模型:Qwen1.5-14B-Chat;RE模型:Qwen1.5-110B-Chat;LoRA参数:alpha=4,dropout=0.1,r=8;学习率:5 × 10⁻⁵;训练epoch:10;扩充数据集:IEPile 20 000样本;基线模型:GPT-4o、Claude 2 Sonnet
微调方法。对于开源模型的微调,包括Qwen1.5-14B、Qwen3-30B和Llama3-8B-Instruct,研究采用基于低秩适应(LoRA)的参数高效微调(PEFT),以平衡计算效率与模型性能,同时避免全参数微调的高内存成本[54,55]。研究采用LlamaFactory作为LoRA实现的微调框架(Zheng, Y.等,2024,ACL,会议)。微调在Qwen1.5-14B、Llama3-8B-Instruct和Qwen3-30B上进行,使用两块Nvidia H800 80GB GPU,Qwen1.5-14B和Llama3-8B-Instruct模型耗时2天,Qwen3-30B耗时4天。PEFT超参数配置为:lora alpha=4,dropout=0.1,r=8,学习率5 × 10⁻⁵,训练5个epoch。
【数据】微调模型:Qwen1.5-14B、Qwen3-30B、Llama3-8B-Instruct;GPU:2×Nvidia H800 80GB;训练时间:Qwen1.5-14B和Llama3-8B-Instruct 2天,Qwen3-30B 4天;PEFT参数:lora alpha=4,dropout=0.1,r=8;学习率:5 × 10⁻⁵;epoch:5
D2Cell-pred数据集准备。由于GEM已广泛用于预测代谢工程靶点,纳入这些模拟可以扩展训练数据集,涵盖一系列潜在场景[2,5]。通过整合实验和模拟数据集,深度学习模型旨在实现训练数据的全面覆盖,利用GEM的预测能力增强其有效优化和预测代谢工程结果的能力。研究利用FSEOF [2]进行模拟工程靶点预测。综合来看,研究为大肠杆菌、酿酒酵母和谷氨酸棒杆菌生成了综合数据集,包括产物、基因改造如敲除和过表达,以及指示基因改造对产物生产影响的二分类标签(1表示增强,0表示无影响或负面影响)。大肠杆菌、酿酒酵母和谷氨酸棒杆菌的数据集分别包含19 777、21 021和5170条条目。为确保数据完整性,仅保留具有基因改造、产物和物种完整信息的数据库记录。文献主要记录阳性结果,导致数据集偏向阳性结果。因此,研究将文献中与增强产物生产相反的基因改造指定为阴性样本。对于每个基因改造-靶分子对,阴性样本通过将相反的基因改造应用于实验验证的阳性案例来生成。具体而言,当文献报道某基因敲除增加了目标分子的产量时,同一基因的过表达被指定为阴性样本,反之亦然。此外,未被FSEOF预测为靶点的基因被纳入阴性数据集。在数据集中,阳性样本占条目的33%,阴性样本占67%(补充图23)。数据集按80%、10%和10%的比例分为训练集、测试集和验证集。综合数据集随后被过滤,仅包含GEM中存在的基因和产物。对于GEM子模块,研究使用了大肠杆菌的iML1515模型[39]、酿酒酵母的Yeast8模型[40]和谷氨酸棒杆菌的iCW773模型[41]。
【数据】数据集条目:大肠杆菌19 777条,酿酒酵母21 021条,谷氨酸棒杆菌5170条;阳性样本:33%;阴性样本:67%;数据划分:训练80%、测试10%、验证10%;GEM模型:iML1515(大肠杆菌)、Yeast8(酿酒酵母)、iCW773(谷氨酸棒杆菌);模拟工具:FSEOF
与常用靶点预测算法FSEOF和FVSEOF的比较。研究采用FSEOF [2]和FVSEOF [13]算法结合基因组尺度模型进行比较。
【数据】比较算法:FSEOF、FVSEOF;原文未详述具体比较结果
研究结果
D2Cell设计。研究开发了基于LLM的流程D2Cell,用于设计未来细胞工厂(图1)。该流程包括三个主要组件:信息收集、信息提取和应用。为高效从文献中提取工程策略,研究将复杂任务分解为更简单的子任务[34,35],提高LLM输出准确性。提取过程分为三个阶段:命名实体识别(NER)、关系提取(RE)和实体归一化(EN)。D2Cell流程通过利用NER识别关键实体(如生物体和菌株ID)、RE链接基因改造并提取相关条件、EN确保数据库质量和一致性,有效创建了结构化细胞工厂数据库。该过程提高了知识库的准确性,并促进其与现有生物数据库的整合。
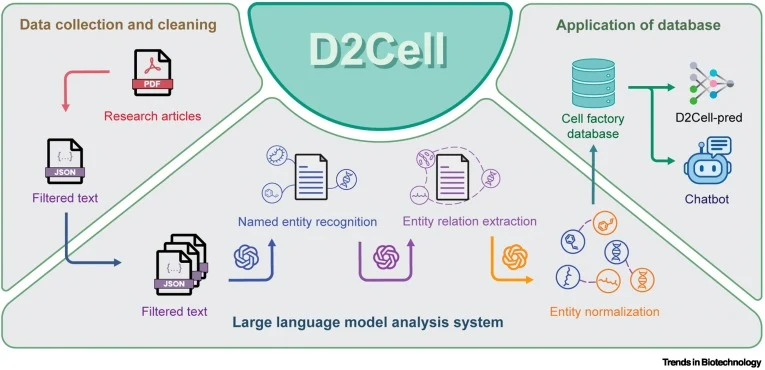
【数据】流程组件:3个(信息收集、信息提取、应用);提取阶段:3个(NER、RE、EN);实体类型:生物体、菌株ID
D2Cell开发及与LLM在文本挖掘中的比较。设计模型结构后,研究评估了各模块的多种LLM,包括GPT-4、Gemini Pro [36]、Claude-3、Llama-3 [19]、Qwen1.5 [20]和Qwen3。在缺乏适用于微生物基因和菌株ID的NER数据集的情况下,研究手动注释了873个文本的数据集以评估性能(在线补充信息文件S1)。标注数据与LLM注释结果的比较显示,GPT-4、Qwen1.5、Qwen3和Llama-3在基础LLM中具有高召回率但低精确率(在线补充信息图S1a),这表明这些模型能有效识别广泛的相关实例(高召回率),但也包含大量错误或不相关信息(低精确率)。另一方面,Gemini Pro [36]虽然不够全面,但显示出高精确率。为增强LLM性能,研究手动验证了Gemini Pro和GPT-4的数据以微调Qwen1.5-14B-Chat、Qwen3-30B-A3B和Llama3-8B-Instruct,得到Qwen1.5-Lora、Qwen3-Lora和Llama3-Lora。微调模型在基准测试中表现出显著的性能提升,与原始模型和其他模型相比,准确率和F1分数均有大幅提高(在线补充信息表S1)。Qwen1.5-Lora模型达到了最高精确率(85%)和F1分数(86%),并保持了高召回率(86%),表明Qwen1.5-Lora模型既准确又全面。Qwen1.5-Lora仅用27分钟处理了873个文本,是最快的模型之一(在线补充信息图S1b)。由于保持数据提取正确性是确保进一步预测性能的主要目标,Qwen1.5-Lora被选为D2Cell-learn中NER任务的模型,GPT-4也作为比较可用。
【数据】评估LLM:GPT-4、Gemini Pro、Claude-3、Llama-3、Qwen1.5、Qwen3;手动标注数据集:873个文本;Qwen1.5-Lora精确率:85%;F1分数:86%;召回率:86%;处理时间:27分钟
研究从NER任务中选择了表现最佳的基座模型——Qwen1.5-110B-Chat(开源)、Qwen3-30B-A3B(开源)和GPT-4(商业)——用于RE任务。由于难以将RE任务与NER组件分开评估,研究评估了D2Cell-learn的整体性能,包括两个任务。研究选取了100篇代谢工程论文进行性能分析。三个版本的D2Cell——D2Cell-Qwen1.5-110B(默认)、D2Cell-Qwen3-30B和D2Cell-GPT-4——以及其他LLM被用于从这些出版物中提取相关数据。随后,研究对提取的数据进行人工验证以评估其准确性(在线补充信息文件S2)。总体而言,D2Cell方法分别达到了55%、74%和79%的准确率(图2A)。按论文评估时,D2Cell-Qwen1.5-110B和D2Cell-GPT-4的中位准确率接近100%(在线补充信息图S1c)。D2Cell-Qwen1.5-110B和D2Cell-GPT-4在两个指标上均优于直接使用Qwen1.5和GPT-4提取。这凸显了将任务分为NER和RE的好处。此外,D2Cell模型大幅增加了提取数据的数量,与直接方法相比数据提取量增加了50-100%(图2A)。数据提取数量的显著增加凸显了该方法从复杂文本来源全面提取信息的增强能力。虽然D2Cell-GPT-4表现略好,但成本更高(图2A)。研究评估了D2Cell-Qwen1.5-110B各模块的执行时间(图2B)。结果表明RE模块是D2Cell工作流中最耗时的组件。显著的时间成本由RE模块中大量任务和每个任务的复杂性驱动,因为它们需要处理大量信息并产生更详细的输出。因此,RE模块的时间需求显著更高(约为NER模块的十倍,ER模块的四倍),其性能对整体性能有关键影响。
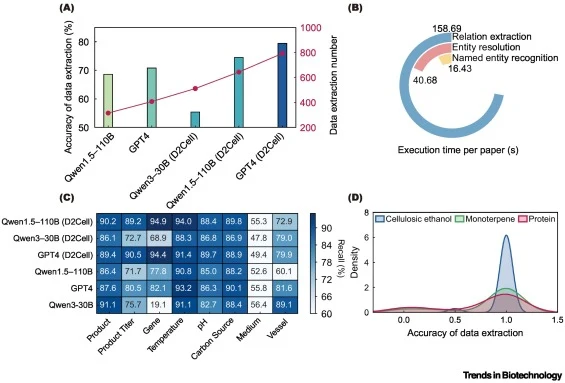
【数据】评估论文:100篇;D2Cell准确率:D2Cell-Qwen1.5-110B 55%、D2Cell-Qwen3-30B 74%、D2Cell-GPT-4 79%;中位准确率:接近100%;数据提取量增加:50-100%;RE模块时间:约为NER的10倍、ER的4倍
讨论与解读
本研究提出了一种利用LLM从科学文献中提取广泛代谢工程知识的分步文本挖掘方法。通过利用Qwen1.5和GPT-4等LLM的先进能力,克服了传统手动数据提取和常规NLP模型的局限。D2Cell-learn工作流通过将文本挖掘分解为更简单、更易管理的子任务来优化该过程。该方法显著增强了LLM从研究文章中准确提取相关数据的能力,改善了实体识别和关系数据提取的精确性。综合评估展示了这些LLM在构建高质量代谢工程知识数据库方面的有效性。所得细胞工厂数据库包含超过29 006条条目,涵盖751株菌株和1210种独特产物。它提供了微生物、产物和基因改造的广泛详细信息,是研究人员和训练深度学习模型的宝贵资源[29]。为进一步增强可访问性,研究使用RAG技术开发了聊天机器人。该聊天机器人高效检索和呈现数据库信息,为用户查询提供精确且上下文相关的响应,确保准确性和可追溯性。多个AI平台如SynBioGPT [48]、GPT-5 Pro和Perplexity-Pro已展示了在合成生物学中的能力。
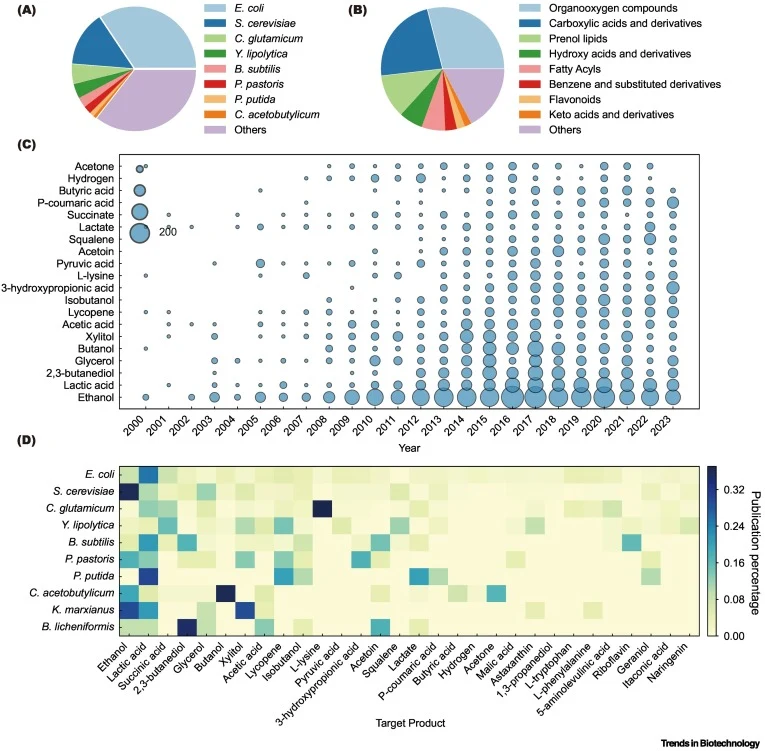
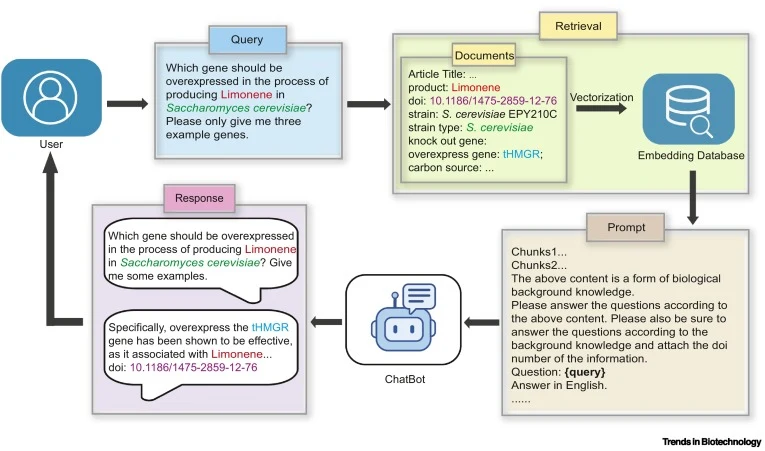
编译者解读
D2Cell的核心价值在于将LLM文本挖掘与代谢模型预测串联为闭环——从文献中提取的29 006条数据不仅构建了知识库,还直接服务于D2Cell-pred的训练与靶点预测,最终在酿酒酵母香叶醇合成中完成湿实验验证。这一"挖掘-预测-验证"范式为合成生物学中数据稀缺问题提供了务实解法。局限同样明显:RE模块耗时占比过高、提取误差尚未系统校正、不确定性量化缺失,且当前框架仅覆盖大肠杆菌、酿酒酵母和谷氨酸棒杆菌三种宿主。向更多工业底盘扩展时,GEM质量与文献覆盖度将成为新的瓶颈。
参考来源
期刊:Trends in Biotechnology, 2026
DOI: 10.1016/j.tibtech.2026.03.026
DOI: 10.1016/j.tibtech.2026.03.026