来源:Exploring differences across pangenome-graph representations using Escherichia coli O157:H7 as a model(Genomics)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
泛基因组图已成为表征细菌群体尺度遗传多样性的重要工具,但不同构建方法基于根本不同的表示范式,其输出结果及对组装质量的敏感性尚缺乏系统量化。本研究以重复序列丰富的大肠杆菌O157:H7为模型,系统调查了微生物泛基因组图构建工具,并对跨越基因簇、压缩着色de Bruijn图、混合方法和多序列比对四种策略的七种代表性工具进行了基准测试。结果显示,图拓扑结构由表示策略决定,组装碎片化是图结构的一阶决定因素,且基于基因簇的工具无法可靠纠正多拷贝基因区域的组装伪影。
研究背景
泛基因组图通过将共享和可变序列整合到单一结构中来表示群体尺度的基因组多样性。图中同源序列元件表示为节点,基因组间的邻接和变异定义边,个体基因组对应图中的路径。这种统一表示支持基因内容分析和结构变异表征等任务,并随着数据集扩展至数千个基因组而被广泛采用。此外,在统一表示中保留局部基因组上下文,为利用邻域结构的下游分析提供了天然基础,包括利用图拓扑或路径结构建模基因型-表型关系的新兴机器学习方法。
构建泛基因组图的计算策略多种多样,反映了对同源性和变异表示分辨率的不同假设。当前方法可归为三大范式:(1)直系同源基因簇方法,在推断的基因家族上构建图,产生可解释的基因中心摘要;(2)压缩着色de Bruijn图方法;(3)多序列比对方法。不同范式对组装质量的敏感性差异尚未被系统量化,尤其是在重复序列丰富的基因组中,短读长组装恰恰在评估致病潜力最关键的区域容易出现错误。
研究方法
4.1 泛基因组图构建方法的调查
通过PubMed数据库检索调查可用的泛基因组构建方法,精确检索策略见补充方法S1。2024年11月1日,检索标准返回223篇文献,经人工筛选识别出与本基准测试相关的软件工具。初步筛选确定41个候选工具。其中27个因不符合纳入标准被排除。最常见的排除原因是工具不构建图作为输出(n=19)。其他工具因需要不合适的输入、针对非微生物应用、产生的输出超出本基准测试范围或缺乏安装说明而被排除。被排除的工具及具体原因列于补充表S9。剩余14个工具被认为是合格的泛基因组图构建方法,并根据其底层图构建策略分组:三个依赖将同源基因聚类为COG,五个使用ccDBG,四个采用MSA,两个结合COG识别与ccDBG构建(补充表S8)。从中选择七个工具进行下游比较:Roary(COG)、Panaroo(COG)、PPanGGOLiN(COG)、ggCaller(ccDBG + COG)、Bifrost(ccDBG)、Cuttlefish2(ccDBG)和Pangraph(MSA)。工具选择理由的详细描述见补充方法S1。
【数据】数据库:PubMed;检索日期:2024年11月1日;返回文献数:223;候选工具数:41;排除工具数:27;排除原因最多:不构建图输出(n=19);合格工具数:14;COG方法:3个;ccDBG方法:5个;MSA方法:4个;混合方法:2个;选定基准工具:7个
4.2 从公共数据库获取大肠杆菌O157:H7完整基因组和短读长序列
使用NCBI-genome-download v0.2.10下载截至2023年10月30日所有标记为“完整基因组”的大肠杆菌序列(n=2980)(https://github.com/kblin/ncbi-genome-download/)。使用ECTyper v1.0进行计算机血清分型。使用mlst v2.23.0确定序列型(STs)(https://github.com/tseemann/mlst)。使用VirulenceFinder v2.0.4确定毒力基因含量。使用Entrez-utilities v13.9检索和解析分离株的元数据。以BioSample ID为输入,使用SRA Tools v3.0.9下载与完整基因组对应的Illumina原始读长(https://github.com/ncbi/sra-tools)。
【数据】下载工具:NCBI-genome-download v0.2.10;下载截止日期:2023年10月30日;完整基因组数:2980;血清分型工具:ECTyper v1.0;ST分型工具:mlst v2.23.0;毒力基因工具:VirulenceFinder v2.0.4;元数据工具:Entrez-utilities v13.9;读长下载工具:SRA Tools v3.0.9
4.3 短读长数据质控和基因组组装
使用Trim Galore v0.6.10去除接头污染和phred分数低于20的碱基(https://github.com/FelixKrueger/TrimGalore)。使用Fastqc v0.12.1对修剪前后样本进行质控。使用Unicycler v0.5.0以默认参数进行基因组组装。通过使用QUAST v5.2.0将短读长组装与对应完整基因组比对来评估组装质量。错误组装和未比对contig比例大于4.0%的基因组被移除(n=4)。使用CheckM2 v1.10评估剩余基因组(n=175)的质量,所有基因组的完整性均高于99.0%,污染率小于1.0%。
【数据】修剪工具:Trim Galore v0.6.10;phred阈值:20;质控工具:Fastqc v0.12.1;组装工具:Unicycler v0.5.0;组装评估工具:QUAST v5.2.0;错误组装阈值:>4.0%;移除基因组数:4;质量评估工具:CheckM2 v1.10;剩余基因组数:175;完整性:>99.0%;污染率:<1.0%
4.4 基准数据集分析
生成基于k-mer的全基因组相似性树以呈现分析中包含的大肠杆菌分离株的多样性背景。研究时RefSeq中所有可用的大肠杆菌完整基因组使用Mashtree v1.4.6处理,该方法计算成对Mash距离并从所得距离矩阵构建邻接树,使用默认参数。所得系统发育树上传至Microreact用于可视化并与血清型、stx谱和质粒元数据整合。树的交互版本公开于:https://microreact.org/project/stec-benchmark。基准数据集中的质粒使用mge-cluster v1.1结合现有大肠杆菌质粒模型分配至簇,模型可访问:https://doi.org/10.6084/m9.figshare.21674078.v1。使用Jellyfish v2.3.1获得所有分离株的k-mer计数。对每个基因组,使用jellyfish count命令计数规范k-mer(k=21)。使用jellyfish stats函数提取汇总统计量,报告(i)唯一k-mer数(恰好出现一次的k-mer),(ii)不同k-mer数(k-mer集合的基数,不考虑多重性),(iii)观察到的k-mer总数,包括所有重复实例。这些定义遵循Jellyfish文档,可访问:https://github.com/gmarcais/Jellyfish/blob/master/doc/Readme.md。
为量化每个基因组的重复负担,我们计算了重复k-mer实例的分数,定义为基因组中所有k-mer出现中来源于重复区域的比例。对于给定基因组i,该指标按eq. 1计算。(1) TotalFractionofRepeatedkmers i = Total i − Unique i Total i。Total(i):k-mer观察总数。Unique(i):多重性恰好为1的k-mer数。由于eq. 1中的分母对应于来源于基因组中出现不止一次序列的所有k-mer实例,指标“重复k-mer的总分数”代表在k-mer尺度上由重复元件组成的基因组比例。较高值表示重复序列丰度更高的基因组。该指标提供了全基因组范围的重复性估计,对于评估泛基因组图构建具有信息价值,因为重复元件通常导致图碎片化和结构复杂性。
【数据】系统发育工具:Mashtree v1.4.6;可视化平台:Microreact;质粒聚类工具:mge-cluster v1.1;k-mer计数工具:Jellyfish v2.3.1;k-mer大小:21;指标定义:重复k-mer总分数 = (Total − Unique) / Total
4.5 选择样本创建混合数据集(包含完整基因组和草图基因组)
构建五个数据集,每个包含175个基因组,以评估基因组碎片化对泛基因组图结构的影响。这些数据集仅在完整基因组与草图组装的比例上不同:0%、11%、50%、89%和100%(分别对应0、20、88、156和175个完整基因组;计数四舍五入至最近整数)。为在每个混合数据集中选择完整基因组,并模拟只有部分分离株可优先进行长读长测序的现实场景,我们遵循Arredondo-Alonso等人描述的策略。简言之,从草图组装的Panaroo基因存在-缺失矩阵计算Jaccard距离。使用t-SNE嵌入距离并对2-D嵌入应用k-means聚类,设置“k”等于该数据集预期的完整基因组数。对每个簇,将最接近质心的基因组指定为完整基因组;其余基因组作为草图组装纳入。鉴于该程序最多识别20个簇,仅将其应用于指导11%数据集的完整基因组选择(补充图S5)。89%数据集则构建为互补条件:11%数据集中选为完整的20个基因组改为草图组装纳入,其余155个基因组作为完整基因组纳入。50%数据集中的完整基因组随机选择。所有完整和草图基因组组合的完整列表见补充表S10。
【数据】数据集数:5个;每个数据集基因组数:175;完整基因组比例:0%、11%、50%、89%、100%;对应完整基因组数:0、20、88、156、175;距离度量:Jaccard距离;嵌入方法:t-SNE;聚类方法:k-means;最大簇数:20;11%数据集完整基因组数:20;89%数据集完整基因组数:155;50%数据集选择方式:随机
4.6 泛基因组图构建和数据解析
所有泛基因组图构建工具在高性能计算集群上以默认参数执行。构建的泛基因组图包含每个基因组的染色体和质粒序列。对于需要基因组注释文件作为输入的工具,注释文件使用Bakta v1.9.1创建,数据库版本5.0,确保所有基于COG的分析中注释标准化。泛基因组图的解析和分析使用Python v3.9.18中的igraph v0.10.13和NetworkX v3.4包进行,使用内部脚本。
【数据】执行环境:高性能计算集群;参数:默认;包含序列:染色体和质粒;注释工具:Bakta v1.9.1;数据库版本:5.0;分析工具:igraph v0.10.13、NetworkX v3.4;Python版本:v3.9.18
研究结果
2.1 使用完整基因组时不同方法的图结构差异
我们选择了七个代表性泛基因组图构建工具,涵盖基于COG(Roary、Panaroo、PPanGGOLiN)、混合(ggCaller)、基于压缩de Bruijn图(Bifrost、Cuttlefish2)和基于MSA(Pangraph)的方法。所有工具应用于175个完整大肠杆菌O157:H7基因组的基准数据集。这些分离株的基因组特征见补充结果S1。图大小在各方法间差异显著。节点数从1667(Pangraph)到117,196(Cuttlefish2),边数从2192到157,027(表1)。基于COG的方法产生的图大体相当。Roary比Panaroo、PPanGGOLiN和ggCaller产生更多节点和边,但四者显示几乎相同的节点长度分布(图1A;补充表S2)。PPanGGOLiN未产生短于100 bp的节点,与其基因家族推断策略一致,而Roary、Panaroo和ggCaller保留了较短元件。碎片化差异更大:ggCaller产生582个子图,最大组件包含75.9%的节点,而Roary、Panaroo和PPanGGOLiN分别仅产生7、6和4个子图,每个的最大组件均含>99%的节点(图1B;补充表S3)。基于unitig的方法产生最大的图。Cuttlefish2产生的节点和边数超过Bifrost的两倍,尽管其节点长度分布几乎无法区分(图1A)。最大节点长度不同(53,319 bp vs 45,273 bp),碎片化模式相反:Bifrost产生324个子图,而Cuttlefish2仅2个。然而在两种情况下,>98%的节点位于最大组件中,表明碎片化主要局限于小的外围子图。Pangraph产生最紧凑的图和最宽的节点长度范围(16–103,993 bp),反映其基于比对的保守和可变区域表示。它产生322个子图,最大组件包含73.9%的节点(各方法中比例最低),累积子图大小分布接近线性(图1B;补充表S3)。
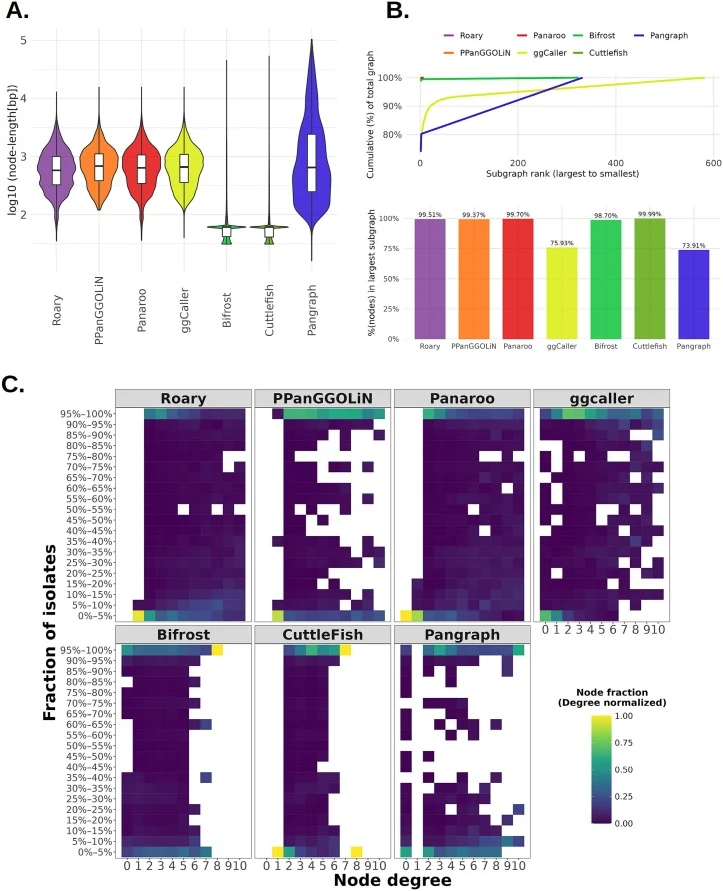
【数据】工具数:7;基因组数:175;节点数范围:1667(Pangraph)–117,196(Cuttlefish2);边数范围:2192–157,027;ggCaller子图数:582;ggCaller最大组件节点占比:75.9%;Roary子图数:7;Panaroo子图数:6;PPanGGOLiN子图数:4;COG方法最大组件节点占比:>99%;Cuttlefish2节点/边数:>2×Bifrost;Bifrost最大节点长度:45,273 bp;Cuttlefish2最大节点长度:53,319 bp;Bifrost子图数:324;Cuttlefish2子图数:2;unitig方法最大组件节点占比:>98%;Pangraph节点长度范围:16–103,993 bp;Pangraph子图数:322;Pangraph最大组件节点占比:73.9%
2.2 节点度数编码基因组变异的差异
节点度数分布提供了各方法如何编码基因组变异的见解。在所有图中,>97%的节点度数≤10,度数-2节点在每个工具中占主导(补充图S2)。Bifrost和Cuttlefish显示度数-3和度数-4节点的相对富集,而Bifrost、ggCaller和Pangraph显示孤立(度数-0)节点比例升高,与其较高的子图数一致。为区分节点度数如何与核心和辅助基因组表示相关,我们检查了在每个度数内标准化的度数-流行度热图(图1C;补充表S4)。在大多数基于COG的图中(PPanGGOLiN、Panaroo、ggCaller),度数-2节点强烈富集高流行度片段(≥95%的基因组),表明线性路径主要表示核心基因组结构。Roary显示相反模式:53.8%的度数-2节点编码存在于<5%基因组中的辅助区域,而39.2%编码核心区域。在更高度数,PPanGGOLiN和ggCaller在度数3–7保持这种核心偏向,表明分支点也频繁编码广泛共享的序列。相比之下,Roary和Panaroo在更高度数显示更平衡的分布,与基因家族根据基因组上下文更大程度的分裂一致。值得注意的是,PPanGGOLiN产生两个极高度数节点(398和437),各代表几乎所有基因组中存在的多拷贝基因家族(总计>3400个基因实例)。针对NCBI非冗余数据库的BLASTN搜索将这些簇鉴定为IS3家族转座酶(IS3411和IS1203)。基于unitig的图显示不同模式。在Bifrost中,度数2–4编码稀有和核心片段的比例大致相等,表明节点度数的使用相对均匀。相比之下,Cuttlefish优先使用度数-2节点表示低流行度辅助片段,而将更高度数(≥3)保留给核心样unitig,揭示了度数使用的清晰功能分层。Pangraph展示了另一种编码策略。度数-2节点偏向低流行度片段,而中间度数(3–4)更多与核心相关。更高度数(5–7)再次转向稀有片段,表明复杂分支结构越来越多地表示分离株特异性比对块。最后,度数-0节点在各工具间差异显著。Roary和Cuttlefish不含孤立节点,Panaroo仅含两个,且均为稀有。相比之下,ggCaller、Pangraph和Bifrost保留了大量孤立片段,包括不可忽略比例的高流行度序列。这表明在这些图中,部分核心基因组未完全整合到主导连通组件中。
【数据】度数≤10节点占比:>97%;度数-2节点:各工具中占主导;Roary度数-2节点辅助区域占比:53.8%(<5%基因组);Roary度数-2节点核心区域占比:39.2%;PPanGGOLiN最高度数节点:398和437;极高度数节点总基因实例:>3400;鉴定结果:IS3家族转座酶(IS3411和IS1203);Roary孤立节点数:0;Cuttlefish孤立节点数:0;Panaroo孤立节点数:2
2.3 基因组碎片化对支持草图组装工具的影响
#### 2.3.1 全局图结构和连通性
为评估基因组碎片化的影响,我们从完整和草图组装的混合中重建泛基因组图,并将所有指标表示为相对于100%完整基线的百分比变化(图2;补充表S5)。Pangraph被排除,因为它无法在草图组装上可靠运行。碎片化对图大小产生范式依赖的影响。在基于COG的工具中,增加组装碎片化通常降低图复杂性。Panaroo显示最强的收缩,在完全草图数据集中边数减少约40%,节点数减少约20%。在Roary中观察到类似的图缩减,使用全部草图组装作为输入时缺失37%的边和20%的节点。PPanGGOLiN相对稳定,节点数变化极小,边数适度减少(≤10%)。ggCaller表现出中间行为,边数中度减少(约15%),节点数仅有微小变化。相比之下,基于unitig的工具在碎片化下显示膨胀。Bifrost显示节点和边数的适度增加(<10%),而Cuttlefish表现出显著更强的膨胀(完全草图数据集中约20–30%),随着完整基因组比例增加而逐渐降低。碎片化也显著影响图连通性。子图数随着草图组装比例上升而逐渐增加(图2)。Panaroo和PPanGGOLiN特别敏感,在完全碎片化数据集中子图分别从6增至145(约+2300%)和从4增至66(约+1550%)。Bifrost和ggCaller显示更温和的增加,分别从324增至498(约+54%)和从582增至723(约+24%)。Cuttlefish尽管起始仅两个子图,增加至六个(约+200%)。跨工具来看,碎片化一致促进图断开,但效应大小因方法而异。
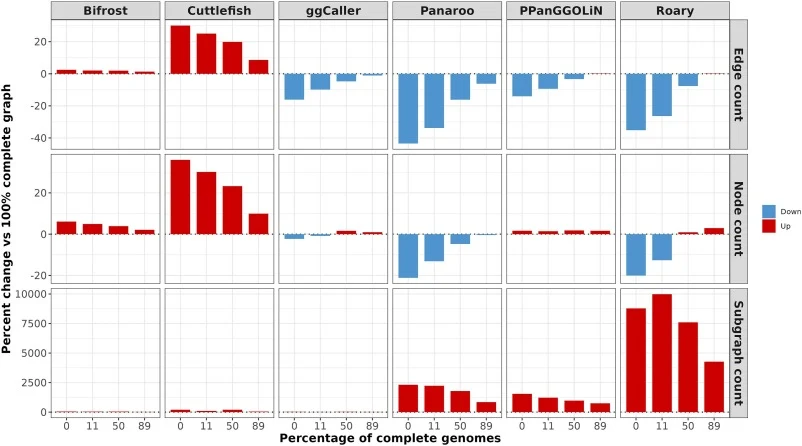
【数据】Panaroo边数减少:~40%(完全草图);Panaroo节点数减少:~20%;Roary缺失边:37%;Roary缺失节点:20%;PPanGGOLiN边数减少:≤10%;ggCaller边数减少:~15%;Bifrost节点/边增加:<10%;Cuttlefish膨胀:~20–30%;Panaroo子图变化:6→145(~+2300%);PPanGGOLiN子图变化:4→66(~+1550%);Bifrost子图变化:324→498(~+54%);ggCaller子图变化:582→723(~+24%);Cuttlefish子图变化:2→6(~+200%)
#### 2.3.2 节点度数使用与核心vs辅助表示
我们通过对比完全完整和完全草图数据集,检查碎片化如何重新分配图质量 across 节点度数(补充图S3)。在基于COG的图中,碎片化通常将质量从较高度数节点转向较低度数节点。在Panaroo和ggCaller中,度数-0和度数-1节点增加,度数-2显示最大富集,而度数≥3持续耗竭。Roary显示类似的低度数偏移,富集最强在度数1,度数2和3增加较小,随后在更高度数节点中耗竭。PPanGGOLiN也显示富集集中在度数1,度数0仅有微小增加。
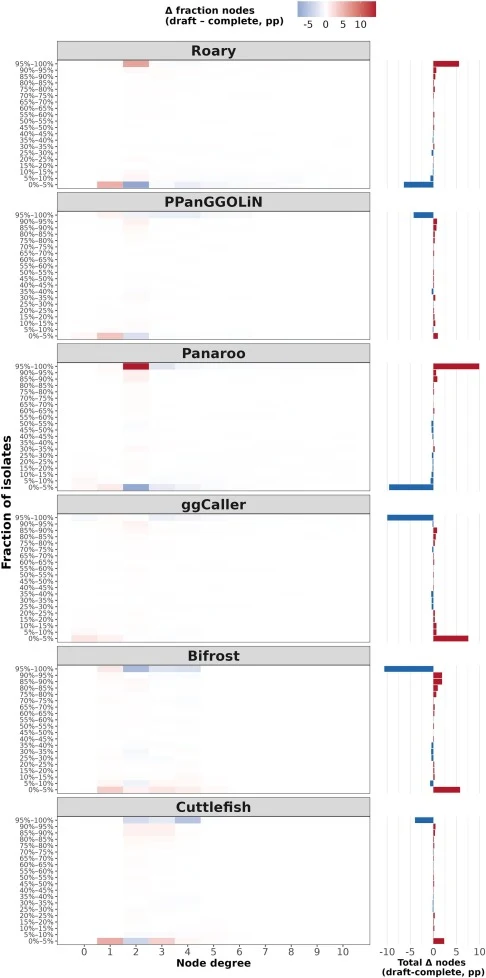
【数据】Panaroo/ggCaller:度数-0和-1增加,度数-2最大富集,度数≥3耗竭;Roary:度数1富集最强,度数2/3增加较小,更高度数耗竭;PPanGGOLiN:度数1富集,度数0微小增加
2.4 计算成本
总CPU时间和峰值内存使用随完整基因组比例变化(图4)。计算成本反映了上述图结构变化,并强烈依赖于完整性组成。在基于COG的工具中,CPU时间通常随碎片化增加而增加,其中Panaroo和Roary在完全草图输入下显示最明显的增加。基于unitig的工具显示不同的计算特征:Bifrost的CPU时间相对稳定,而Cuttlefish2在完全草图输入下表现出显著的运行时间惩罚。峰值内存使用模式类似,Cuttlefish2在完全草图数据集中显示最高的峰值内存。
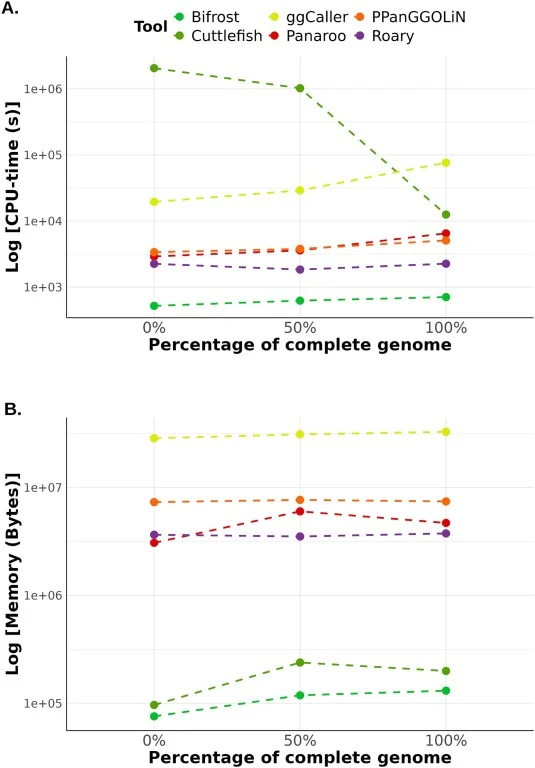
【数据】CPU时间:随碎片化增加(COG工具);Panaroo/Roary:完全草图输入下CPU时间最明显增加;Bifrost:CPU时间相对稳定;Cuttlefish2:完全草图输入下显著运行时间惩罚和最高峰值内存
2.5 位点水平准确性:Shiga毒素基因座检测
我们评估了各工具在检测Shiga毒素操纵子亚基A和B时的精确率和召回率,按短读长组装中stx基因座的组装状态分层(Collapsed、Complete、Fragmented)(图5)。精确率和召回率随数据集中完整基因组比例的增加而变化。基于基因簇的工具在挑战性多拷贝基因区域的组装伪影纠正方面表现不一致,性能因位点而异。具体而言,泛基因组水平的协调不能可靠地纠正组装伪影,且各工具在不同stx基因座上的性能存在差异。
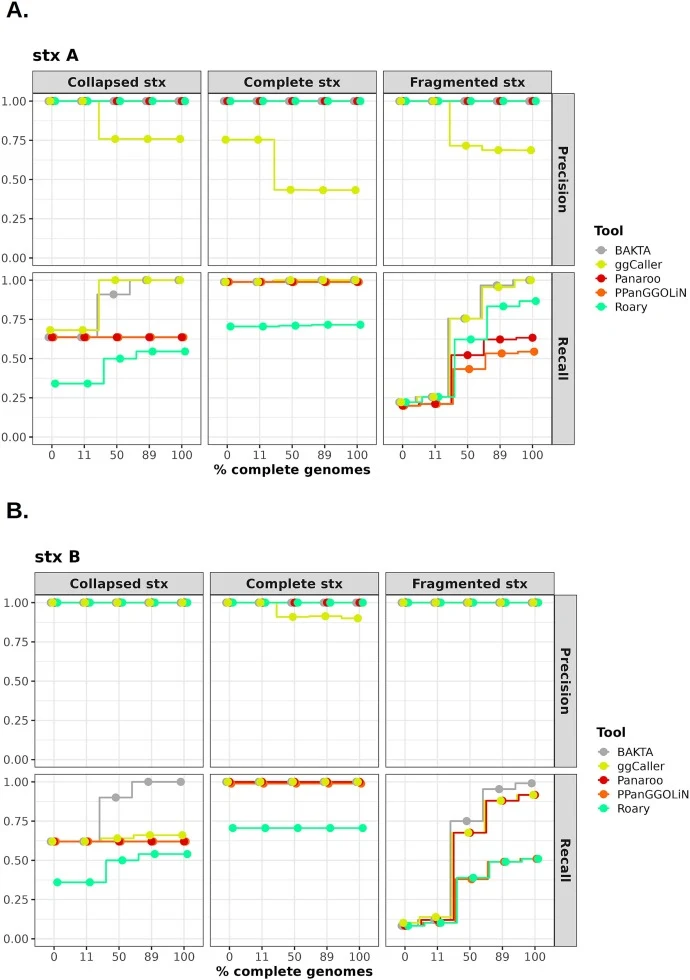
【数据】评估目标:Shiga毒素操纵子亚基A和B;分层:Collapsed、Complete、Fragmented;指标:精确率和召回率;变量:完整基因组比例;结果:各工具性能因位点而异,泛基因组水平协调不能可靠纠正组装伪影
讨论与解读
本研究识别了不同的泛基因组图构建方法并比较了七种代表性工具,涵盖基于COG和ccDBG、混合及一种基于MSA的实现。工具间的差异不应仅被解释为实现细节,它们反映了对同源性、变异和基因组上下文的不同操作定义,这些定义约束了下游推断。近期在克隆细菌中的基准测试支持这一框架:即使真实基因内容多样性有限,泛基因组大小估计也可能因注释行为和组装特征而在COG流程间显著变化。
我们围绕一个严格且实际相关的设置设计评估:一个重复序列丰富、临床重要的STEC谱系,其中短读长组装预计恰好在评估致病潜力和临床相关决定因素最关键的区域失败。我们的O157:H7数据集以ST11为主,减少了系统发育异质性,同时保留了谱系内大量辅助基因组变异。升高的重复含量、频繁的多变异毒素携带以及关键决定因素集中在移动、重复密集的区室(包括前噬菌体和其他辅助元件),创造了一个场景,其中图方法必须应对重复和镶嵌性,同时仍支持临床相关基因的位点水平真值。
编译者解读:该研究以重复序列丰富的O157:H7为模型,系统揭示了泛基因组图构建中表示策略对结果的一阶影响——同一输入下图大小可差数十倍,碎片化可导致COG图收缩而ccDBG图膨胀。这提示合成生物学应用中选择泛基因组图工具时,不能仅看默认输出,必须考虑组装质量和重复区域。局限在于仅测试了一个物种谱系,且Pangraph无法在草图组装上运行,MSA类方法的碎片化敏感性仍属空白。
DOI: 10.1016/j.ygeno.2026.111309