来源:Machine learning-assisted broad-spectrum aptamer discovery and intelligent detection of neonicotinoid pesticides(Biosensors and Bioelectronics)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
新烟碱类农药(NEOs)在食品和环境样品中常以多种同类共存,传统检测方法依赖大型仪器、难以现场快速筛查。本研究开发了一套机器学习辅助的计算策略,从随机DNA序列库出发,经结构聚类、多靶标分子对接、结合口袋重叠分析和定向单核苷酸突变,从头发现靶向多种NEOs的广谱适配体。最优适配体NEO 3_4的解离常数达1.48 μM。结合MIL-88(Fe)-NH2@PtIr纳米酶纸基比色平台与智能手机RGB提取及人工神经网络分析,该方法实现了0.05-100 nM线性检测和26.68 pM检出限,蔬菜样品回收率98.95-102.75%。
研究背景
新烟碱类农药是现代农业生产中用量最大的一类杀虫剂。其应用范围广、环境持久性强,对传粉昆虫和人类等非靶标生物具有潜在毒性,已引起全球关注。NEOs水溶性高、化学性质稳定,残留可在环境和农业系统中累积,造成土壤、水体和食品污染。多个国家和监管机构已重新评估或限制部分NEOs的使用。
食品和环境样品中往往同时存在多种NEOs,因此亟需能够同时检测这类污染物的快速广谱分析策略。液相色谱-质谱联用(LC-MS)和酶联免疫吸附测定(ELISA)等传统方法灵敏度高、准确性好,但通常需要精密仪器、繁琐的样品前处理和专业人员操作,难以满足快速现场检测需求。适配体作为农药传感的分子识别元件受到关注,但其高亲和力与广谱性往往难以兼得——这正是本研究试图用计算方法突破的瓶颈。
研究方法
筛选适配体的实验评估
为验证计算机模拟预测结果,采用等温滴定量热法(ITC)评估了三条适配体(图3a–c)的结合亲和力。如图3e–g所示,三条适配体对受试NEOs均表现出广谱识别能力,NEO 1的Kd值为7.61 μM,NEO 2为6.64 μM,NEO 3为2.72 μM。其中NEO 3展现出最强的整体结合亲和力。这一实验趋势与基于对接的结合能分析结果一致(表S6)。基于其优异且一致的结合性能,NEO 3被选用于后续优化。
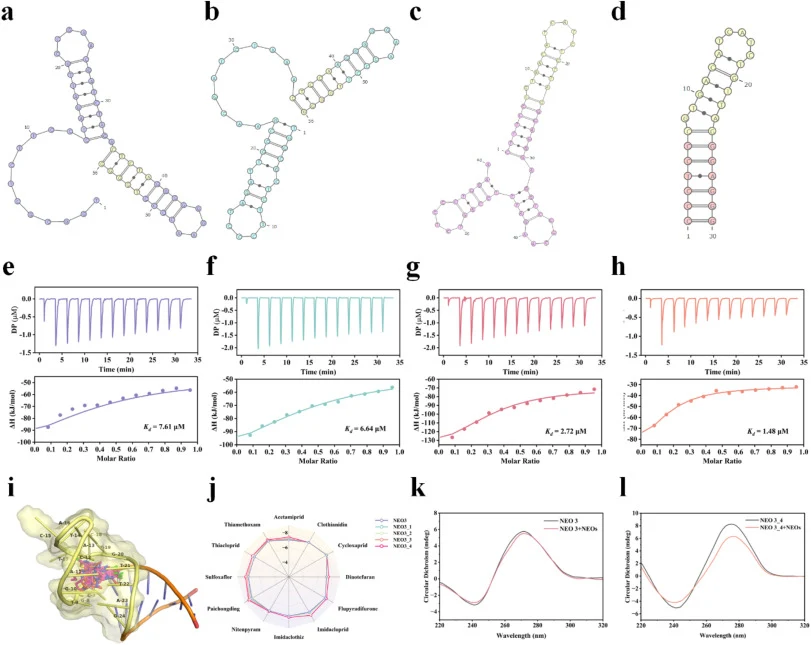
【数据】方法:等温滴定量热法(ITC);适配体:NEO 1、NEO 2、NEO 3;Kd值:NEO 1为7.61 μM,NEO 2为6.64 μM,NEO 3为2.72 μM;结合能分析:与对接结果一致(表S6)
研究结果
初始库的构建
通过Python的random模块获得了一个包含50,000条ssDNA序列的初始适配体库(40-60 bp,GC含量40-60%),该库在保持良好折叠潜力的同时具有高度序列多样性。随后进行二级结构预测,提取了十个与拓扑结构相关的描述符,包括茎、环和分支点的数量,最长茎和环的长度,短环和长环的计数,以及碱基配对比例、GC含量和最小自由能(MFE)。这些描述符共同为每条序列的结构特性提供了定量、多维的表征。
为考察库内结构多样性的全局分布,使用t-SNE将高维特征矩阵投影到二维空间。如图1a所示,t-SNE图呈现出序列池的非均匀组织,多个分离区域对应不同的二级结构拓扑。这一模式反映了库内显著的结构异质性,表明随机生成的序列跨越了广泛的折叠构象,而非收敛于有限的基序集合。基于标准化结构特征矩阵,随后应用K-means聚类将库划分为结构一致的组(图1b–c)。
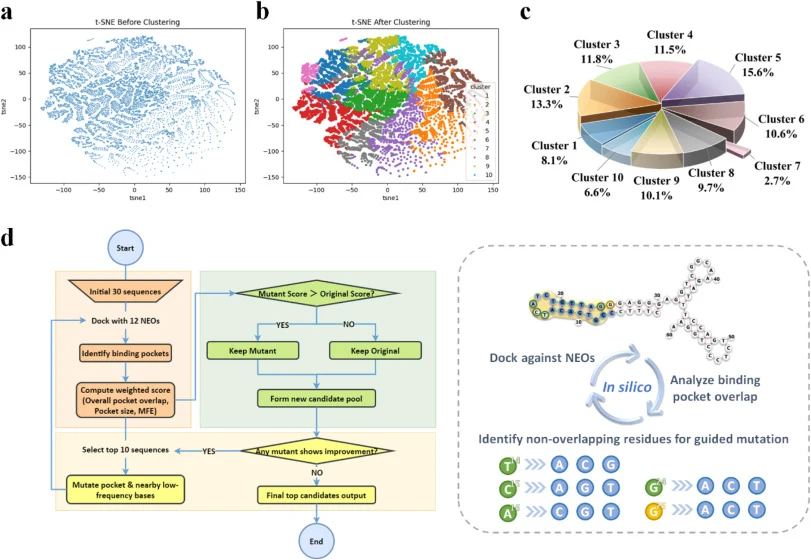
为确定最佳聚类数,在k = 1-20的聚类范围内进行了Gap Statistic分析(图S1)。Gap值随k增大而逐步升高,表明增加聚类数持续改善了结构特征空间的划分。然而,Gap值的增量改善(ΔGap)随聚类数增加而逐渐减小,说明聚类性能的提升在递减。特别是当k = 10之后,ΔGap值持续保持在较低水平(一般< 0.02),表明进一步细分主要引入冗余划分,而非结构区分度的实质性提升。因此,综合考虑聚类分辨率、结构多样性与避免过度分割之间的平衡,选择k = 10作为后续结构聚类分析的最佳聚类数。
据此,初始序列库被划分为十个聚类(Cluster 1-10)。每个聚类代表库内一个主导的二级结构类别,具有高簇内结构相似性和清晰的簇间分离。在每个聚类内,序列按MFE排序,选取MFE最低的三条序列作为代表性序列,共获得30条序列构成初始库。这些代表性序列的MFE值范围为−13.0至−29.6 kcal/mol,长度在45至60个核苷酸之间,表明具有良好的热力学稳定性。聚类间的结构差异主要与发夹环的数量和空间排布、茎的连续性与分支、以及内部环、凸起和单链连接片段的位点特异性插入有关,而同一聚类内的序列共享一致的结构框架(图S2)。因此,所构建的初始库为后续三维建模、分子对接和迭代计算筛选以鉴定高亲和力广谱适配体提供了结构全面的基础。
【数据】初始库:50,000条ssDNA序列;长度:40-60 bp;GC含量:40-60%;描述符:10个拓扑相关描述符;聚类范围:k = 1-20;最佳聚类数:k = 10;代表性序列:30条;MFE范围:−13.0至−29.6 kcal/mol;序列长度:45-60个核苷酸;ΔGap:k = 10后一般< 0.02
NEOs广谱适配体的迭代计算筛选
所构建的初始库由无监督聚类分析得到的30条代表性序列组成(表S1),将其分别与全部十二种NEO靶标进行独立对接(图S3)。在对接结果中(图S4),我们发现相当比例的序列-靶标复合物表现出相互作用位点空间收敛的明显趋势,配体接触优先定位于序列二级结构的受限区域。此外,约70%的序列在多种NEOs间显示出收敛的结合区域。这种反复出现的接触收敛提示存在能够容纳结构相关NEOs的共享结合口袋,启发我们设计了一种口袋引导的迭代定向突变策略以实现广谱识别(图1d)。即定向单核苷酸突变针对共享结合口袋内部及周围的弱相互作用核苷酸,同时保留高频接触残基以维持整体折叠和口袋完整性。该策略在最小化破坏关键结构结合区域风险的同时,实现了配体-适配体相互作用的局部优化。
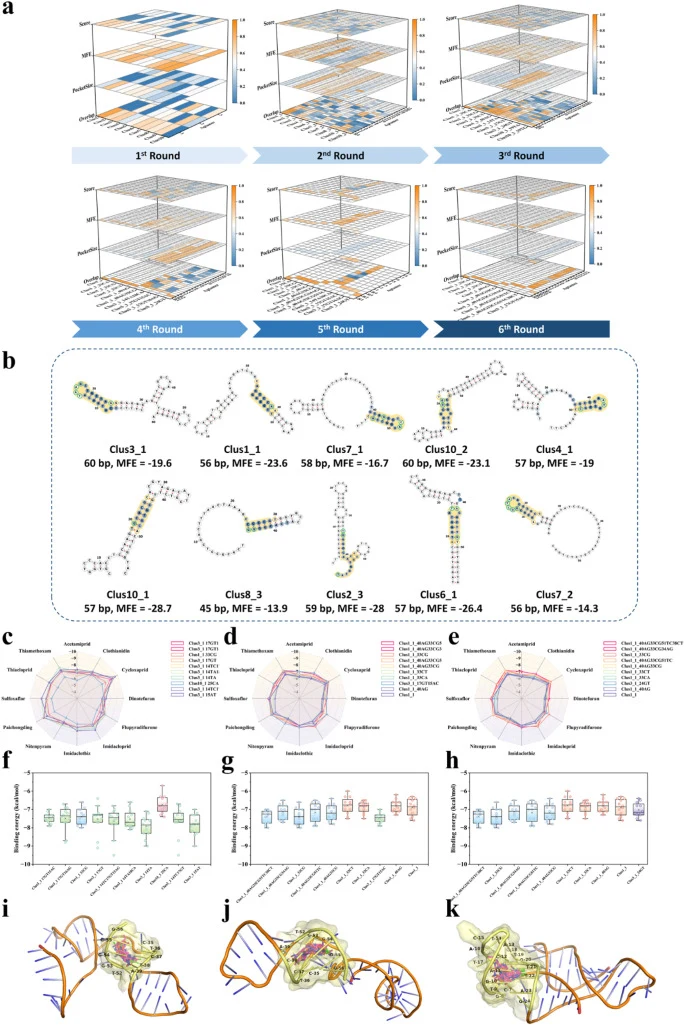
在此原则指导下,进行了多轮迭代突变和筛选,每个新生成的序列池均经过相同的对接和评估流程。为在迭代筛选中定量指导候选序列选择,采用方法部分定义的S值作为主要选择标准。简言之,该评分函数通过三个归一化参数(E1、E2和E3)整合了结合一致性、口袋覆盖率(Liu et al., 2024)和构象稳定性(Zhao et al., 2022)。为评估权重方案对筛选行为和收敛性的影响,系统比较了三种代表性参数集(α:β:γ = 5:4:1、6:3:1和7:2:1)。S值越高表明适配体的空间一致性越优、结合口袋覆盖率越广、结构稳定性越强。
在第一轮筛选中,使用不同权重方案下的S值评估了30条序列与十二种NEOs的对接结果(表S1)。以6:3:1权重方案为例(图2a),对接构象分析显示配体相互作用主要集中于茎和发夹相关区域,为口袋引导的突变策略提供了结构支持。基于这些结果,选择排名前十的序列进行定向突变(图2b)。在低频相互作用位点进行靶向单核苷酸替换,生成了159个突变体,与其亲本序列共同构成第二轮候选池,共169条序列。类似地,在5:4:1(图S5a–b)和7:2:1(图S6a–b)权重方案下,分别生成了159和156个突变体,产生第二轮文库分别为169和166条序列。
在后续筛选轮次中,仅保留S值高于其亲本序列的突变体用于进一步优化,较差的变体被系统性丢弃(图2a–S5c-d和S6c-e)。定向单核苷酸突变反复应用于保留序列,突变位点限于各自共享结合口袋内。随着筛选推进,S值的改善逐渐减小。当新生成的突变体未能获得相对于亲本序列的正向得分增益(ΔS ≤ 0)时,表明筛选轨迹已收敛,迭代筛选过程终止。在5:4:1权重方案下经过五轮突变达到收敛(图S5e和表S2),而6:3:1(图2a和表S3)和7:2:1(图S6f和表S4)方案均需要六轮。尽管三种策略最终均获得十条能够识别十二种NEOs的适配体,但其结合一致性差异显著。5:4:1方案衍生的适配体在靶标间性能变异性明显,对cycloxaprid和paichongding结合较强,但相互作用较弱。
【数据】初始库:30条代表性序列;靶标:12种NEOs;序列收敛比例:约70%;权重方案:5:4:1、6:3:1、7:2:1;第一轮突变体数:6:3:1方案159个,5:4:1方案159个,7:2:1方案156个;第二轮文库规模:6:3:1方案169条,5:4:1方案169条,7:2:1方案166条;收敛轮数:5:4:1方案5轮,6:3:1方案6轮,7:2:1方案6轮;最终适配体数:每种方案10条
讨论与解读
本研究开发了一种机器学习辅助的结构引导计算策略,用于从头发现和迭代优化靶向多种NEOs的广谱适配体。与传统的模板依赖方法不同,该策略整合了无监督结构聚类、多靶标分子对接、结合口袋重叠分析和定向单核苷酸突变,以探索序列和结构空间并鉴定多种NEOs间的保守识别特征。通过迭代计算筛选,优化后的适配体NEO 3_4表现出改善的广谱结合能力,Kd为1.48 μM。进一步开发的MIL-88(Fe)-NH2@PtIr纳米酶辅助纸基比色平台实现了0.05-100 nM的线性范围和26.68 pM的检出限,在蔬菜样品中具有满意的回收率。受当前计算资源限制,适配体-NEO复合物的动态稳定性和详细结合机制将在未来研究中进一步探讨。总体而言,这项工作为从头广谱适配体发现和便携式NEO检测提供了计算引导策略。
编译者解读:该研究的核心价值在于用"结构聚类+口袋引导突变"替代了传统SELEX的随机筛选,将适配体从头发现的计算化程度推进了一步。50,000条随机序列经t-SNE和K-means压缩到30条代表序列,再通过多靶标对接的S值评分驱动迭代突变,这条路线在方法论上具有可迁移性——任何需要针对多靶标家族设计广谱识别元件的场景都可借鉴。但需注意,S值中口袋覆盖率和构象稳定性的权重系数(5:4:1、6:3:1、7:2:1)对最终适配体的靶标间一致性影响显著,说明评分函数的参数选择仍是经验性的,缺乏理论指导。此外,NEO 3_4的Kd为1.48 μM,相比单靶标高亲和力适配体(nM级)仍有差距,广谱性与亲和力之间的权衡尚未完全解决。纸基平台与ANN的结合则展示了从计算发现到现场检测的完整闭环,这是该方法真正的落地价值所在。
参考来源
期刊:Biosensors and Bioelectronics, 2027
DOI: 10.1016/j.bios.2026.119243
DOI: 10.1016/j.bios.2026.119243