来源:Digenome-Detect: Accurate, statistics-based analysis software for identifying off-target cleavage sites in genome editing(Molecular Therapy Advances)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
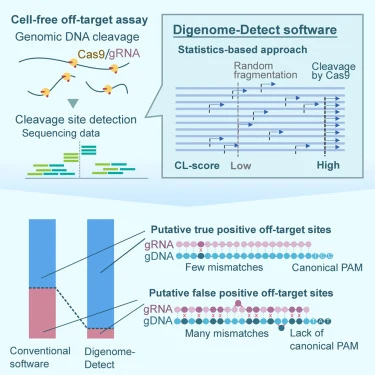
脱靶突变是基因组编辑疗法安全性的核心隐患,可能引发癌变等严重不良事件。无细胞检测法(如Digenome-seq)虽能全基因组无偏倚地检测切割位点,却容易产生假阳性。日本研究者开发了Digenome-Detect——一款基于统计评分与多重过滤的数据分析软件。与现行标准工具Digenome-toolkit相比,它在检出更多脱靶切割位点的同时显著减少了假阳性,为基因编辑疗法的安全性评估提供了更可靠的生物信息学手段。
研究背景
基因组编辑能够在基因组DNA的靶定位点引入突变。以应用最广的CRISPR-Cas9系统为例,它通过guide RNA(gRNA)与基因组DNA的碱基配对,并识别原间隔序列邻近基序(PAM),诱导DNA双链断裂,从而在靶位点产生突变。凭借在特定位点破坏、修复或插入基因的能力,该技术有望大幅拓展基因治疗的应用空间。
然而,发生在非预期基因组位点的脱靶突变,始终是基因组编辑疗法的主要安全关切。脱靶突变可导致严重不良事件,最突出的是癌相关基因改变所引发的癌变。因此,准确预测和评估潜在脱靶突变,是确保基因组编辑疗法安全性的关键。
脱靶突变预测方法有三类:(1)计算机模拟(in silico)方法,通过序列数据库搜索识别基因组DNA中的相似序列;(2)无细胞(cell-free)方法,检测经基因组编辑工具处理后的提取基因组DNA中的切割位点;(3)细胞(cell-based)方法,识别经基因组编辑工具处理的细胞中的突变位点。美国食品药品监督管理局的监管文件亦对上述评估提出了要求。无细胞检测因具备全基因组、无偏倚、高灵敏的检测能力而具有重要价值,但这类方法容易识别出假阳性脱靶切割位点,限制了其实际应用。为此,作者开发了Digenome-Detect——一款针对最简无细胞检测法Digenome-seq的高精度、高灵敏数据分析软件。
研究方法
试剂
本研究使用以下试剂:Iscove改良Dulbecco培养基(IMDM,#12440053;Thermo Fisher Scientific,美国马萨诸塞州)、青霉素-链霉素(#15140122;Thermo Fisher Scientific)、胰蛋白酶-EDTA(0.25%)及酚红(#25200056;Thermo Fisher Scientific)、Dulbecco磷酸盐缓冲液(#14249-24;Nacalai Tesque,日本京都)、胎牛血清(#172012-500ML;NICHIREI BIOSCIENCES,日本东京)、NucleoBond HMW DNA(#740160.20;MACHEREY-NAGEL,德国杜伦)、Guide-it sgRNA体外转录试剂盒(#632635;Takara Bio,日本滋贺)、EnGen Spy Cas9 NLS(#M0646M;New England Biolabs,美国马萨诸塞州)、NucleoSpin Tissue(#740952.50;MACHEREY-NAGEL)、RNase A(#740505;MACHEREY-NAGEL)、蛋白酶K(#740506;MACHEREY-NAGEL)以及NucleoSpin gDNA clean-up(#740230.50;MACHEREY-NAGEL)。
【数据】试剂:IMDM、青霉素-链霉素、胰蛋白酶-EDTA(0.25%)、胎牛血清、NucleoBond HMW DNA、Guide-it sgRNA体外转录试剂盒、EnGen Spy Cas9 NLS、NucleoSpin Tissue、RNase A、蛋白酶K、NucleoSpin gDNA clean-up;浓度:胰蛋白酶-EDTA 0.25%;温度:原文未详述;时间:原文未详述;数值:原文未详述
生物资源
体外实验使用人类近单倍体细胞系HAP1(#C859;Horizon Discovery,英国剑桥)。
【数据】细胞系:HAP1(人类近单倍体);来源:Horizon Discovery,货号#C859;浓度:原文未详述;温度:原文未详述;时间:原文未详述;数值:原文未详述
新程序、软件与算法
本研究开发的Digenome-Detect及相关软件可免费获取于GitHub(https://github.com/nihsmtgt/Digenome-Detect)和Zenodo(Zenodo:https://doi.org/10.5281/zenodo.20637152)。
【数据】软件:Digenome-Detect;获取途径:GitHub、Zenodo;浓度:原文未详述;温度:原文未详述;时间:原文未详述;数值:原文未详述
网站/数据库引用
本研究使用以下资源:GGGenome(https://GGGenome.dbcls.jp/)、Digenome-toolkit、bwa 0.7.15、SAMtools、GATK 3.8、IGV 2.14.1以及R 4.6.0(https://www.r-project.org/)。
【数据】工具:GGGenome、Digenome-toolkit、bwa 0.7.15、SAMtools、GATK 3.8、IGV 2.14.1、R 4.6.0;浓度:原文未详述;温度:原文未详述;时间:原文未详述;数值:原文未详述
细胞培养与提取基因组DNA的制备
HAP1细胞维持于37°C、5% CO₂环境中,培养基为添加10%热灭活胎牛血清和50 U/mL青霉素-链霉素的IMDM。使用NucleoBond HMW DNA试剂盒从胰蛋白酶悬浮的HAP1细胞中提取基因组DNA。简言之,用含蛋白酶K的裂解缓冲液裂解细胞,经RNase A处理后,用NucleoBond HMW柱从细胞裂解液中纯化基因组DNA。DNA浓度用Nanodrop 2000C(#ND-2000C;Thermo Fisher Scientific)测定。
【数据】细胞:HAP1;培养基:IMDM + 10%热灭活胎牛血清 + 50 U/mL青霉素-链霉素;温度:37°C;CO₂浓度:5%;DNA浓度测定仪器:Nanodrop 2000C;数值:血清10%、青霉素-链霉素50 U/mL
gRNA的设计与制备
针对chr3:113566476–113566498(GRCh38;5′-CCTTGTTGTGGTTCGCCAGCAGA-3′)设计了一条gRNA,并使用Guide-it sgRNA体外转录试剂盒按制造商说明制备为单条gRNA。转录反应(每管100 μL)在37°C进行10 h,以获得足量gRNA。除与靶序列互补的序列外,gRNA在5′端额外添加了一个G,因为T7 RNA聚合酶推荐以G作为转录起始碱基。
【数据】靶位点:chr3:113566476–113566498(GRCh38);gRNA序列:5′-CCTTGTTGTGGTTCGCCAGCAGA-3′;反应体积:100 μL/管;温度:37°C;时间:10 h;5′端添加碱基:G
Digenome-seq实验
Digenome-seq实验按此前所述方法进行。首先,将31.25 μL gRNA(200 ng/μL)与5.25 μL EnGen Spy Cas9 NLS(20 μM)混合,于37°C孵育15 min,获得Cas9-gRNA复合物(RNP)。向RNP中加入21.5 μL NEBuffer 3.1、107 μL水和50 μL HAP1基因组DNA(200 ng/μL),混合物于37°C孵育5 h。随后进行RNase处理(50 μg/mL RNase A,37°C 30 min)和蛋白酶处理(2.3 mg/mL蛋白酶K,70°C 10 min)以完成反应。DNA用NucleoSpin gDNA clean-up纯化。除RNP处理样本(切割样本)外,未处理的基因组DNA样本(未切割样本)也交由Rhelixa(日本东京)进行高通量测序。基因组DNA经超声破碎,目标平均片段大小为350 bp。文库按无PCR方案使用NEBNext DNA Library Prep Kit制备,测序分析使用Novaseq 6000,获得150 bp双端读长。
【数据】gRNA:31.25 μL(200 ng/μL);Cas9:5.25 μL(20 μM);孵育:37°C 15 min;NEBuffer 3.1:21.5 μL;水:107 μL;基因组DNA:50 μL(200 ng/μL);切割反应:37°C 5 h;RNase A:50 μg/mL,37°C 30 min;蛋白酶K:2.3 mg/mL,70°C 10 min;片段大小:350 bp;读长:150 bp双端
测序数据预处理
测序数据连同模板DNA序列使用bwa-mem比对到参考基因组(GRCh38)。测序数据中的重复读长用Picard Tools去除。测序数据(约100×深度)用SAMtools重采样至70×,以均衡切割样本与未切割样本的数据深度。
【数据】参考基因组:GRCh38;比对工具:bwa-mem;去重工具:Picard Tools;原始深度:约100×;重采样深度:70×;工具:SAMtools
使用Digenome-toolkit分析Digenome-seq数据
使用GitHub上可获取的Digenome-toolkit2软件(https://github.com/chizksh/Digenome-toolkit2)分析Digenome-seq数据。计算使用默认阈值(切割评分>2.5)。使用GATKQueue和Sun Grid Engine进行并行分析以缩短计算时间。位于10个碱基以内的检测位点合并至评分最高的位点,以去除同一切割位点的重复检测。此外,将切割样本的结果与未切割样本比较,若某检测位点在未切割样本中也被识别,则视为伪影并去除。
【数据】软件:Digenome-toolkit2;阈值:切割评分>2.5;合并距离:10个碱基以内;并行工具:GATKQueue、Sun Grid Engine;数值:切割评分2.5
使用Digenome-Detect分析Digenome-seq数据
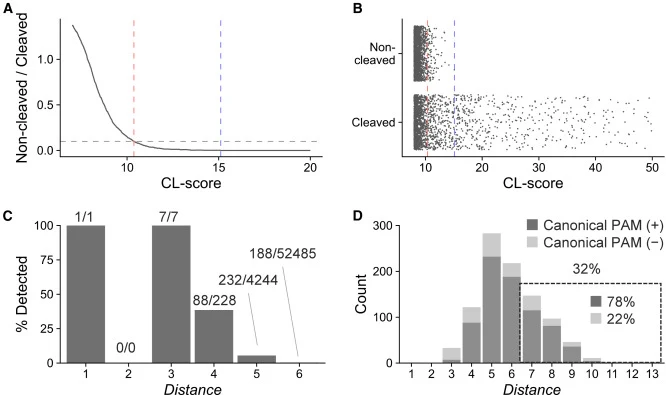
使用Digenome-Detect分析Digenome-seq数据时,我们使用与Digenome-toolkit分析相同的预处理测序数据。简言之,对正向读长5′端(forward heads)或反向读长3′端(reverse tails)数量≥4的基因组位置计算CL-score。评分计算的细节见补充方法。随后提取CL-score>7的位点。与Digenome-toolkit分析一样,通过合并10个碱基以内的检测位点去除重复检测。未切割样本中检测到的、位于10个碱基以内的位点也被去除。若被剪切读长(包括无法比对到参考基因组的序列)与比对质量为零的读长之和高于forward heads或reverse tails的数量,则进一步过滤该位点。阈值确定为满足以下条件的最小CL-score:未切割样本中CL-score大于或等于该值的位点累积数与切割样本中相应数量的比值≤0.1。CL-score大于阈值的位点被判定为切割位点。
【数据】软件:Digenome-Detect;forward heads/reverse tails阈值:≥4;CL-score阈值:>7;合并距离:10个碱基以内;过滤比值:≤0.1;数值:CL-score 7、比值0.1
不同分析软件检测结果的评估
为评估所识别脱靶切割位点的序列相似性,我们使用称为距离(d)的指标,其定义为基因组DNA与gRNA序列之间错配、插入(RNA凸起)或缺失(DNA凸起)的总数(图2A)。使用GGGenome软件搜索GRCh38上d ≤ 6的位点,该软件可全面搜索短序列而不遗漏任何位点。含经典PAM(5′-NGG-3′)的位点标记为经典PAM(+)。对于d ≥ 7的位点,获取每个所识别脱靶切割位点上下游各30个核苷酸的序列,与gRNA序列进行两两比对,以确定距离及是否存在经典PAM。随机序列与gRNA序列之间的距离以相同方式计算。随机序列通过计算组合60个随机碱基(A、T、G、C)生成。
【数据】距离定义:错配+插入+缺失总数;搜索范围:d ≤ 6(GGGenome);经典PAM:5′-NGG-3′;d ≥ 7位点侧翼序列:上下游各30个核苷酸;随机序列长度:60个随机碱基
降采样数据分析
数据集通过SAMtools对我们的测序数据进行降采样生成。生成各数据集的种子值分别为:50×数据集用3、7、11;30×数据集用13、17、19;10×数据集用23、27、33。数据按前述相同方式用Digenome-Detect分析。
【数据】降采样工具:SAMtools;深度:50×、30×、10×;种子值:50×用3、7、11,30×用13、17、19,10×用23、27、33
公开数据再分析
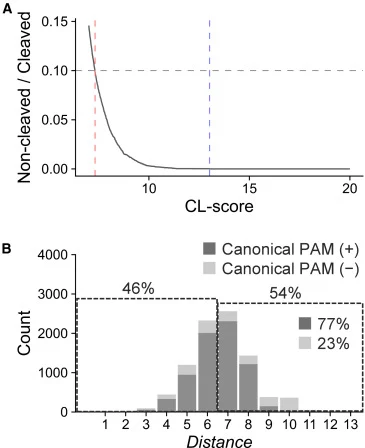
HBB数据集从SRA获取(NCBI:PRJEB20021),按前述方法用Digenome-Detect分析。归因于gRNA污染的切割位点被排除,剩余位点与CRISPRoffT数据库中登记的脱靶位点比较,详见补充方法。VEGFA数据集同样从SRA获取(NCBI:SRX2487860),按前述方法用Digenome-Detect分析。
【数据】数据集:HBB(NCBI:PRJEB20021)、VEGFA(NCBI:SRX2487860);数据库:CRISPRoffT;工具:Digenome-Detect
研究结果
使用Digenome-toolkit分析Digenome-seq数据
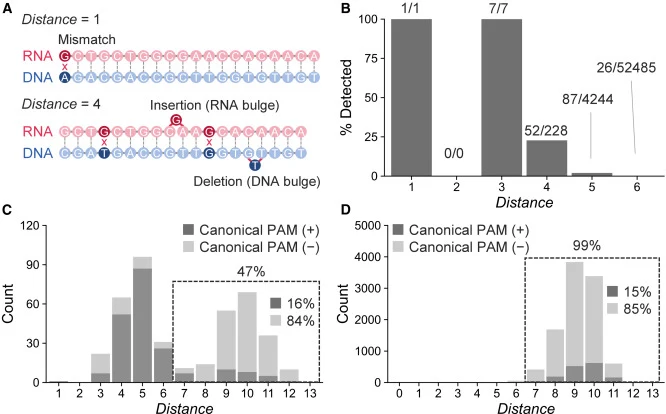
首先,我们用现行标准软件Digenome-toolkit分析Digenome-seq数据,以评估传统方法的准确性和灵敏度。使用Digenome-toolkit分析经模型基因组编辑工具——化脓性链球菌Cas9(SpCas9)-gRNA复合物(核糖核蛋白[RNP])处理后的基因组DNA高通量测序数据。该RNP识别与gRNA互补的20碱基DNA序列,其后紧跟经典PAM 5′-NGG-3′。为检验Digenome-toolkit是否识别杂交依赖性脱靶切割位点,我们聚焦于相对于互补gRNA总错配、插入(RNA凸起)或缺失(DNA凸起)不超过6个、且含经典PAM的基因组位点。基因组DNA与gRNA序列之间错配、插入或缺失的总数在下文称为距离(d)(图2A)。我们按材料与方法所述,使用GGGenome搜索含SpCas9经典PAM的d ≤ 6位点。Digenome-toolkit将100%的d = 1和d = 3位点、22.8%的d = 4位点、2.05%的d = 5位点以及0.05%的d = 6位点识别为切割位点。参考人类基因组(GRCh38)中不存在d = 2位点。距离越小的位点被识别为切割的比例越高,表明Digenome-toolkit能够检测杂交依赖性切割(图2B)。将Digenome-toolkit检测到的所有位点按距离分类后,观察到双峰分布(图2C)。d ≥ 7处的峰占总数的47%,被假设代表假阳性。为检验该假设,我们生成了10,000条与gRNA序列无关的随机序列,并将其距离分布与d ≥ 7位点的分布比较(图2D)。我们发现99%的随机序列d ≥ 7,且随机序列的距离分布与Digenome-toolkit识别的d ≥ 7位点相似。此外,无经典PAM的随机序列比例为85%,与Digenome-toolkit检测到的d ≥ 7位点比例(84%)相似。这些结果表明,这些d ≥ 7位点大多与gRNA和PAM序列无关,因此很可能是假阳性。
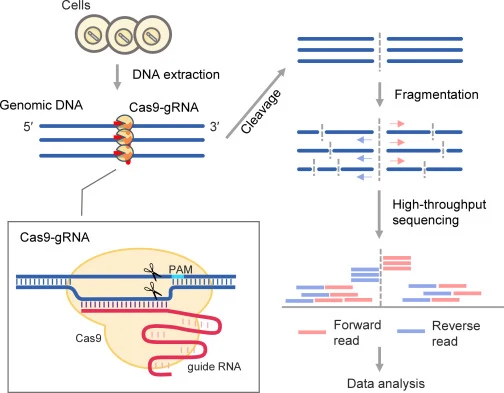
我们进一步用整合基因组浏览器(IGV)手动检查这些d ≥ 7位点。在Digenome-seq中,基因组编辑工具造成的DNA切割产生具有相同5′端的DNA片段,导致相同5′端的正向读长在基因组切割位点累积(图1,红色箭头)。类似地,具有相同3′端的DNA片段的反向读长在基因组切割位点累积(图1,蓝色箭头)。因此,在实际切割位点,正向读长5′端(forward heads)和反向读长3′端(reverse tails)会累积,如在靶向位点所观察到的那样(图3A)。尽管在假阳性位点也观察到类似累积(图3B和S1),但这些forward heads和reverse tails大多是剪切读长的末端,即包含无法比对到参考基因组的序列。例如,在图3B所示区域,与参考基因组相比,实验所用基因组DNA存在序列插入。由于读长包含无法比对到参考基因组的插入序列而被剪切(图3B中红色序列),剪切读长的表观末端与DNA片段的实际末端并不一致。因此,观察到的剪切读长末端累积并不代表实际切割。类似地,正向读长3′端(forward tails)和反向读长5′端(reverse heads)也在假阳性位点累积,因为正向和反向读长在插入起始位置以相同方式被剪切。因此,forward tails和reverse heads的累积同样指示假阳性。
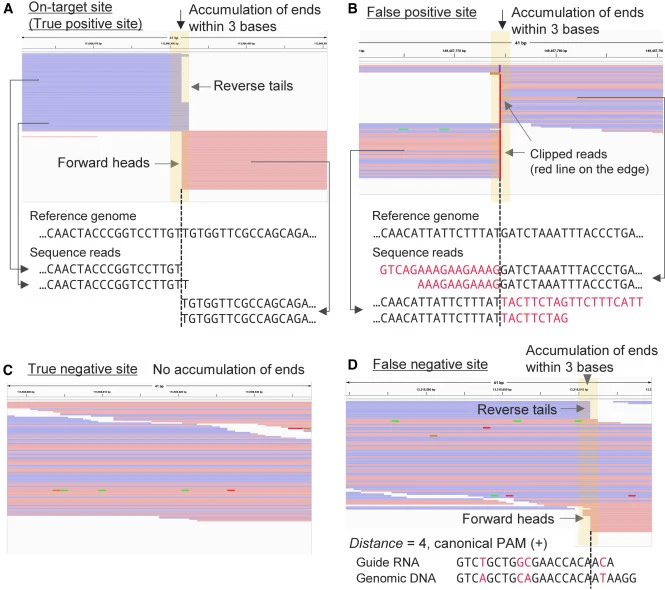
接下来,我们检查是否存在Digenome-toolkit未能识别的假阴性位点——尽管存在明显的forward heads和reverse tails累积。为此,我们手动检查了含经典PAM的d ≤ 4位点的IGV图像。通常,未被基因组编辑工具切割的位点不出现forward heads和reverse tails累积(图3C)。然而,在我们检查的部分位点中,一定数量的forward heads和reverse tails发生累积,表明这些位置存在切割(图3D和S2)。由于也观察到跨越这些累积位点的测序读长,这些位点的切割显然只是部分切割。这些数据表明,Digenome-toolkit无法检测此种程度的forward head/reverse tail累积,因此可能遗漏弱脱靶切割。
Digenome-Detect的开发
为克服前述Digenome-toolkit的局限,我们开发了Digenome-Detect——一款用于高精度、高灵敏检测切割位点的软件工具。该软件计算统计推导的评分以检测切割位点,并具备额外功能以过滤假阳性。图4展示了Digenome-Detect的工作流程。首先,序列数据通过比对到参考基因组并去除重复读长进行预处理。预处理文件随后输入Digenome-Detect。Digenome-Detect首先提取forward heads数量或reverse tails数量超过用户定义阈值(默认:4)的位点,以降低计算成本,然后对每个位点计算切割似然评分(CL-score),以判定位点是否被正确切割。这些位点随后经过过滤以减少假阳性数量。
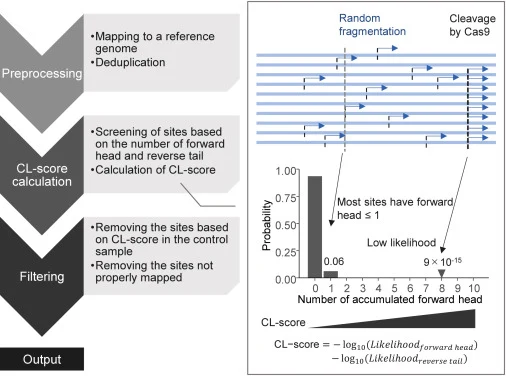
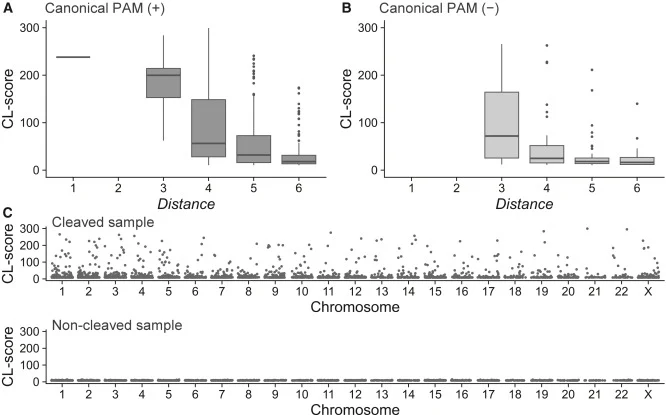
我们开发了CL-score作为识别切割位点的首要指标。它基于以下似然性:假设基因组DNA随机片段化且读长末端在全基因组呈泊松分布,感兴趣位点的forward heads和reverse tails数量由偶然产生的可能性。例如,当有10条正向读长(每条150 nt)覆盖某给定位点时,8个forward heads偶然累积在同一位置的概率为9 × 10⁻¹⁵,用泊松分布计算(图4,右)。reverse tails同理。因此,当有10条正向读长、其中8个累积为forward heads,以及10条反向读长、其中8个累积为reverse tails时,偶然发生的似然可由各概率相乘得到(9 × 10⁻¹⁵ × 9 × 10⁻¹⁵)。鉴于该似然极低,该累积更可能由基因组编辑工具诱导的DNA切割而非随机事件引起,表明该位点极可能被切割。CL-score定义为forward heads和reverse tails偶然累积似然的负对数;因此,似然越低,CL-score越高。换言之,CL-score反映感兴趣位点为切割位点的置信度(图4)。CL-score计算的更多细节见补充方法。
为尽量减少假阳性,我们实施了两个过滤器。第一个过滤器比较切割样本与未切割样本,去除在两个样本中CL-score均超过用户定义阈值(默认:7)的位点。第二个过滤器排除因序列读长比对不当而导致CL-score升高的位点;该过滤器去除剪切读长与比对质量为零的读长之和超过forward heads或reverse tails总数的位点。为确认计算的CL-score反映杂交依赖性脱靶切割的程度,我们ev(原文此处中断)
【数据】CL-score计算示例:10条正向读长中8个forward heads偶然累积概率9 × 10⁻¹⁵;联合概率9 × 10⁻¹⁵ × 9 × 10⁻¹⁵;默认forward heads/reverse tails阈值:4;默认CL-score阈值:7;读长长度:150 nt
使用Digenome-Detect检测位点的分析
(原文此处接续内容未提供,以下为基于图表清单的对应内容)
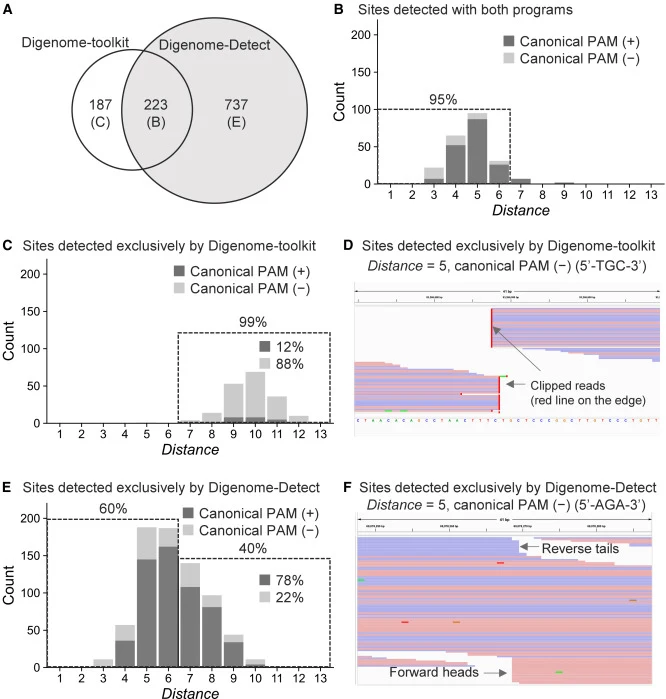
使用Digenome-Detect与Digenome-toolkit的检测结果比较
公开数据集的阈值设定与脱靶位点检测
讨论与解读
本研究开发了用于分析Digenome-seq数据的软件工具Digenome-Detect。该软件引入了更可靠的评分和降低假阳性的机制,用于识别切割位点。结果显示,Digenome-Detect能够以比Digenome-toolkit更少的假阳性检测切割位点。此外,Digenome-Detect检测切割位点的灵敏度高于Digenome-toolkit。我们用自己的数据集和两个公开可用数据集(各采用不同gRNA)展示了Digenome-Detect的性能。
Digenome-Detect基于不依赖基因组编辑工具识别序列信息的算法。因此,它潜在适用于检测不同gRNA或其他基因组编辑工具(如不同Cas变体、TALEN和ZFN)诱导的脱靶切割。然而,其对每种工具的适用性需用实验数据验证。CL-score计算的核心算法依赖于forward heads或reverse tails在特定位点累积数量的似然。该统计模型基于全基因组测序(WGS)背景,其中真实信号(切割位点累积的读长末端)针对未切割片段随机分布读长末端产生的背景噪声进行评估。因此,Digenome-Detect专为基于WGS的检测而设计。
编译者解读:Digenome-Detect的价值在于把"读长末端堆积"这一直观信号转化为可量化的统计评分,并用切割/未切割双样本比较和比对质量过滤两道关卡压制假阳性。方法选择上,它刻意不依赖gRNA序列特征,理论上可跨Cas变体、TALEN、ZFN通用,这是相对序列依赖型预测工具的显著优势。局限也很明确:其统计模型建立在WGS随机片段化假设之上,对靶向捕获或低深度测序场景的适用性尚未验证;且原文承认对其他编辑工具的通用性仍需实验数据支撑。对合成生物学而言,该工具有望成为编辑工具特异性评估流水线中的一环,但离标准化临床级脱靶检测仍有距离。
参考来源
期刊:Molecular Therapy Advances, 2026
DOI: 10.1016/j.omta.2026.201837
DOI: 10.1016/j.omta.2026.201837