来源:Discovery of a novel natural USP25 inhibitor via an integrated deep learning-guided screening strategy with molecular dynamics validation(European Journal of Medicinal Chemistry)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
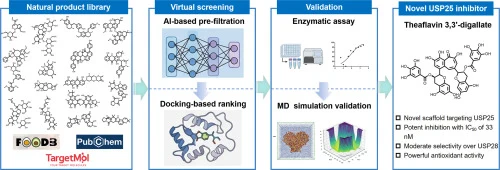
USP25是一种与炎症、神经退行性疾病和肿瘤信号通路密切相关的去泛素化酶,但结构多样的小分子抑制剂极为稀缺。本研究构建了一套AI活性预测与分子对接相结合的集成筛选流程,从149,378个天然产物中挖掘USP25抑制剂。经体外酶学验证,茶黄素-3,3′-双没食子酸酯(TF)被鉴定为高效USP25抑制剂,IC50达33 nM,对其旁系同源物USP28的选择性约为8.5倍。100 ns分子动力学模拟与MM-PBSA热力学分析证实了TF与USP25结合的稳定性,为缺乏共晶结构的靶点提供了经济高效的早期药物发现范式。
研究背景
USP25由人类染色体21q11.2上的USP25基因编码,通过切割不同泛素连接类型来调控底物蛋白的稳定性、定位和信号功能。其结构由N端调控区、含独特UCID插入片段的催化USP结构域和C端功能域组成。与同源物USP28不同,USP25在催化活性二聚体和自抑制四聚体之间动态切换——四聚体构象阻断底物进入催化口袋,抑制酶活性。除经典去泛素化活性外,USP25还参与蛋白-蛋白相互作用和调控性结合事件。
大量证据表明USP25功能异常与多种人类疾病密切相关,包括肿瘤、心血管与代谢紊乱、器官纤维化、炎症性疾病和神经发育缺陷,使其成为有前景的治疗靶点。在癌症中,USP25扮演双重角色:通过稳定致癌底物、重编程糖酵解代谢和塑造免疫抑制性肿瘤微环境发挥促肿瘤效应;但在某些情境下也表现出相反功能。
然而,目前已报道的USP25抑制剂数量极为有限,且大多数为核心骨架相似的合成小分子。这种结构多样性化学探针的匮乏严重阻碍了靶向USP25的机制研究和药物开发。天然产物具有丰富的骨架多样性和良好的类药性,是补充现有抑制剂化学空间的重要来源。本研究旨在建立一套集AI活性预测与分子对接于一体的集成工作流,从天然产物库中高效挖掘新型USP25抑制剂。
研究方法
3.1 TF抗氧化活性测定
#### 3.1.1 羟自由基清除实验
基于经典Fenton反应体系评估TF的羟自由基清除能力。实验前,将TF溶解于含0.1% DMSO的预煮沸超纯水中以确保完全溶解。制备浓度梯度EGCG(0.1–1.6 μM)作为抗氧化验证的阳性对照。反应体系在96孔板中构建,含50 μM番红T、10 μM EDTA-Fe²⁺络合溶液,然后加入稀释的TF样品。通过向每个反应孔中引入0.3% H₂O₂触发羟自由基产生。组装好的反应混合物在25 °C、避光条件下孵育60 min,以促进充分的自由基生成和清除反应。孵育后,在520 nm处检测各体系的吸光度。根据样品组、空白组和对照组之间的吸光度差异计算羟自由基清除率。
【数据】试剂:番红T 50 μM;EDTA-Fe²⁺ 10 μM;H₂O₂ 0.3%;DMSO 0.1%;阳性对照:EGCG 0.1–1.6 μM;温度:25°C;时间:60 min;检测波长:520 nm;原文未详述TF浓度梯度
#### 3.1.2 氧自由基吸收能力实验
采用基于荧光的氧自由基吸收能力(ORAC-FL)实验评估TF的过氧自由基清除潜力。与上述抗氧化实验条件一致,TF样品溶解于含0.1% DMSO的预煮沸超纯水中。采用EGCG溶液(5 μM)作为抗氧化定量比较的参考标准。将各样品溶液与150 nM荧光素钠工作液混合,在37 °C预孵育15 min以达到体系稳定。通过加入12 mM AAPH溶液启动过氧自由基链式反应。每3 min记录一次荧光强度变化,总持续时间500 min,激发和发射波长分别设为485 nm和535 nm。所有测试在整个数据采集过程中维持37 °C。最终过氧自由基清除能力通过计算荧光衰减曲线下积分面积确定,TF的抗氧化效力相对于EGCG标准曲线进行归一化和定量。
【数据】荧光素钠:150 nM;AAPH:12 mM;EGCG:5 μM;DMSO:0.1%;预孵育温度:37°C;预孵育时间:15 min;检测间隔:每3 min;总时长:500 min;激发波长:485 nm;发射波长:535 nm
3.2 USP25抑制活性测定与BLI实验
USP25(货号BP12842-00A,Biortus USA)活性使用泛素-罗丹明110(Ub-Rh110)作为荧光底物测定。USP25切割泛素C端Gly76与Rh110之间的酰胺键,释放荧光Rh110。使用酶标仪在激发波长485 nm和发射波长535 nm下监测反应。所得荧光强度用于定量USP25活性并评估待测化合物的抑制效果。
BLI实验用于检测TF与USP25的结合动力学和亲和力。使用Genemore生物素化试剂盒(货号:G-MM-IGT,Genemore,南京,中国)以1:1的摩尔偶联比(MCR)对USP25蛋白进行生物素化,按照制造商说明操作。室温孵育60 min后,通过试剂盒提供的脱盐柱(MWCO 5000 Da)去除多余生物素。各样品蛋白浓度用PBS缓冲液稀释至5–10 μg/mL,生物素化蛋白进一步与超链霉亲和素生物传感器(ForteBio Inc.,上海,中国)在30 °C下连接5 min。进行固化测试以评估蛋白生物素标记质量,空白对照传感器组在缓冲液(25 mmol/L Tris pH 7.5、150 mmol/L NaCl和0.05% DMSO)中活化。数据分析采用ForteBio数据分析软件进行双重参考扣除(样品和传感器参考)。
【数据】USP25货号:BP12842-00A;底物:Ub-Rh110;激发波长:485 nm;发射波长:535 nm;生物素化MCR:1:1;孵育时间:60 min;孵育温度:室温;脱盐柱MWCO:5000 Da;蛋白浓度:5–10 μg/mL;传感器连接温度:30°C;连接时间:5 min;缓冲液:25 mmol/L Tris pH 7.5、150 mmol/L NaCl、0.05% DMSO
3.3 天然产物库的构建与逐步预处理
天然产物原始分子条目从公开化合物库获取:FOODB、TargetMol和PubChem,初始清单包含149,378条原始SMILES字符串。所有结构整理操作使用RDKit 2023和自定义Python脚本实现。采用顺序多级过滤流程去除低质量、化学不适当或冗余结构,每个处理层级后记录分子数量。第一阶段清洗和碎片化去除无机反离子、结晶溶剂和含金属子结构;少于八个重原子的分子也被丢弃。二级结构过滤排除含过长线性脂肪族片段、磷酸骨架和非天然杂环骨架的分子。所有剩余结构通过规范化SMILES匹配进行重复去除,以消除重复骨架。最终理化质量过滤器仅保留分子量在200至1000 Da范围内的分子,生成包含80,185条标准化天然产物SMILES的筛选库用于后续DTA预测。
【数据】初始分子数:149,378;数据来源:FOODB、TargetMol、PubChem;软件:RDKit 2023;重原子阈值:≥8;分子量范围:200–1000 Da;最终筛选库:80,185条SMILES
3.4 虚拟筛选
两个独立的深度学习DTA模型被直接并行使用以完成针对USP25的结合亲和力排序。采用双模型筛选策略以整合其互补的特征提取逻辑,减少单一模型单方面预测偏差导致的假阳性命中。首先,内部PLM-CAFT-DTA框架由本研究组独立开发,在多种蛋白和配体数据集上展现出稳健的泛化性能,完整源代码发布于https://github.com/tsun10003/PLM-CAFT-DTA。该模型简要利用ChemBERTa结合GAT捕获天然产物的拓扑和语义子结构特征,基于ESM2的蛋白Transformer从USP25氨基酸序列中提取全长上下文嵌入,交叉注意力模块融合配体-蛋白配对潜在表征以生成连续结合亲和力评分。PSICHIC被选为公开可用的预测器,其开源仓库可访问https://github.com/huankoh/PSICHIC,其开发和预测有效性已在已发表研究中充分验证。与PLM-CAFT-DTA不同之处在于,它通过PNA图神经网络提取配体物理描述符,整合残基理化常数和ESM2序列嵌入进行蛋白编码,并采用双边交互核在亲和力回归前建模配体-残基成对接触指纹。为确保统一预测条件,标准化的USP25 UniProt序列和完整的80,185条整理后天然产物SMILES作为两个模型的相同输入数据,所有默认超参数保留,预测期间不进行额外微调。并行亲和力评分后,所有分子分别由PLM-CAFT-DTA和PSICHIC基于预测结合亲和力值排序,仅同时落入两个模型排名输出前20%的化合物被保留为初步候选命中,以有效消除单个模型单方面特征偏差诱导的假阳性,共产生7,142个共享候选分子用于后续基于结构的分子对接重评分。
【数据】模型1:PLM-CAFT-DTA(ChemBERTa+GAT+ESM2+交叉注意力);模型2:PSICHIC(PNA-GNN+ESM2+双边交互核);输入数据:80,185条SMILES + USP25 UniProt序列;筛选阈值:两个模型前20%;共享候选分子:7,142个
3.5 基于AutoDock Vina对接的结构过滤
双模型筛选的候选物导入RDKit生成优化的三维构象PDB文件。对于USP25受体蛋白结构(PDB: 6HEL),去除冗余结晶水和无关杂原子基团,随后进行完整氢原子添加和部分原子电荷分配以制备蛋白对接模板。活性口袋以残基Ser264为中心,坐标参数设为center_x = −29.958, center_y = 0.034, center_z = −26.083;立方搜索框尺寸定义为size_x = 20.0, size_y = 20.0, siz……
【数据】受体蛋白:USP25 PDB 6HEL;活性口袋中心残基:Ser264;中心坐标:center_x = −29.958, center_y = 0.034, center_z = −26.083;搜索框尺寸:size_x = 20.0, size_y = 20.0(原文此处截断)
研究结果
2.1 双模型筛选工作流与PLM-CAFT-DTA性能验证
构建了多步骤计算与实验筛选工作流以发现天然产物来源的USP25抑制剂(图2a)。原始分子条目从FOODB、TargetMol和PubChem汇总,然后进行标准化结构整理以构建最终化合物库。基于互补的编码逻辑和预测优势,采用两个结构不同的深度学习DTA模型进行联合亲和力评分。自主设计的PLM-CAFT-DTA作为主要筛选核心。图2b总结了其基准性能,包括损失、MAE、RMSE、R²收敛、预测相关性和消融分析,验证了其回归能力和模块级合理性。它结合ChemBERTa和图注意力网络(GAT)捕获结构多样天然产物的细粒度拓扑和语义特征,配合ESM2蛋白Transformer提取USP25的全长序列上下文信息;交叉注意力模块桥接配体和蛋白嵌入以建模残基-子结构相互作用模式。作为成熟模型,PSICHIC被引入以抵消潜在的单模型偏差。该架构通过PNA-GNN编码分子物理描述符,整合残基级理化常数和ESM2蛋白嵌入;其双边交互核专注于成对接触指纹,从纯几何特征角度预测结合效力。由于两个模型通过独立的特征范式提取配体-蛋白信息,被两种工具同时排名在前20%的重叠命中可有效过滤单方面特征偏差产生的假阳性。通过双模型交集筛选的化合物进入三个顺序验证工作流:AutoDock Vina对接重评分用于基于结构的二次过滤、体外酶抑制活性测定和GROMACS分子动力学模拟用于结合稳定性评估。
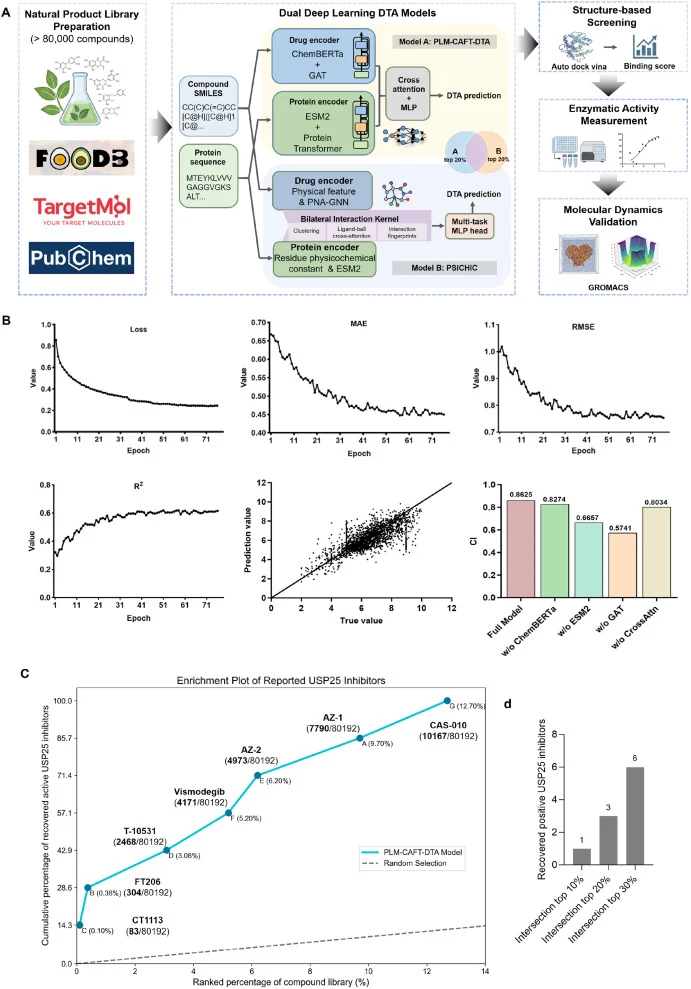
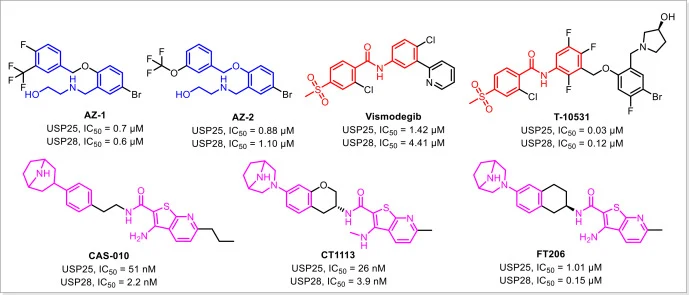
通过将七种已报道的USP25抑制剂(图1)纳入整理库进行富集分析,以评估内部PLM-CAFT-DTA模型的预测性能(图2c)。每个数据点旁的排名标签记录了每个阳性命中在全部80,192个化合物池中的全局位置。两个最易富集的活性分子CT1113和FT206分别出现在排名库的前0.10%和0.38%。七种参考抑制剂中有六种在前10%排名窗口内被回收,而AZ-1在12.70%截断处被检索到。模型的富集曲线在绘制范围内始终远高于对角线随机选择基线,反映了强的早期富集能力。这种优先排序真正活性配体的能力有效减少了不必要的湿实验验证工作量,支持了其适用于USP25靶向虚拟筛选。
为合理化双模型交叉筛选的阈值,使用七种已报道USP25抑制剂作为阳性对照进行阈值消融分析(图2d)。比较了三个交集截断值(前10%、前20%和前30%)。前10%交集过于严格,仅回收一种阳性抑制剂。相比之下,前30%交集检索到六种阳性分子,但会产生更大的候选池,假阳性风险和实验工作量大增。最终选择前20%交集,因为它在活性化合物召回和下游实验验证的实际筛选规模之间取得了有利平衡。需要指出的是,由于已验证的USP25抑制剂数量有限,富集分析和阈值消融分析被视为探索性的,而非PLM-CAFT-DTA模型泛化性和稳健性的决定性证据。这些比较主要有助于在当前化合物库和可用活性数据集下选择实用的筛选截断值。
【数据】参考抑制剂:7种;最易富集分子:CT1113(前0.10%)、FT206(前0.38%);前10%回收:6/7种;AZ-1排名:12.70%;筛选阈值:前20%;总化合物池:80,192个
2.2 计算筛选流程与命中候选物的USP25抑制
包含149,378个分子的原始天然产物池经过分级标准化预处理以消除结构缺陷和低质量条目(图3a)。初步清洗和碎片化去除含金属分子、有害子结构和超短原子片段,将库存缩减至133,291个化合物。后续结构过滤排除有问题的脂肪链、磷酸骨架和非天然侧基,产生126,709个结构。二次重复消除进一步将数据集压缩至122,123个非冗余分子。最终分子量限制在200–1000 Da范围内产生80,185条目的确定性筛选库。
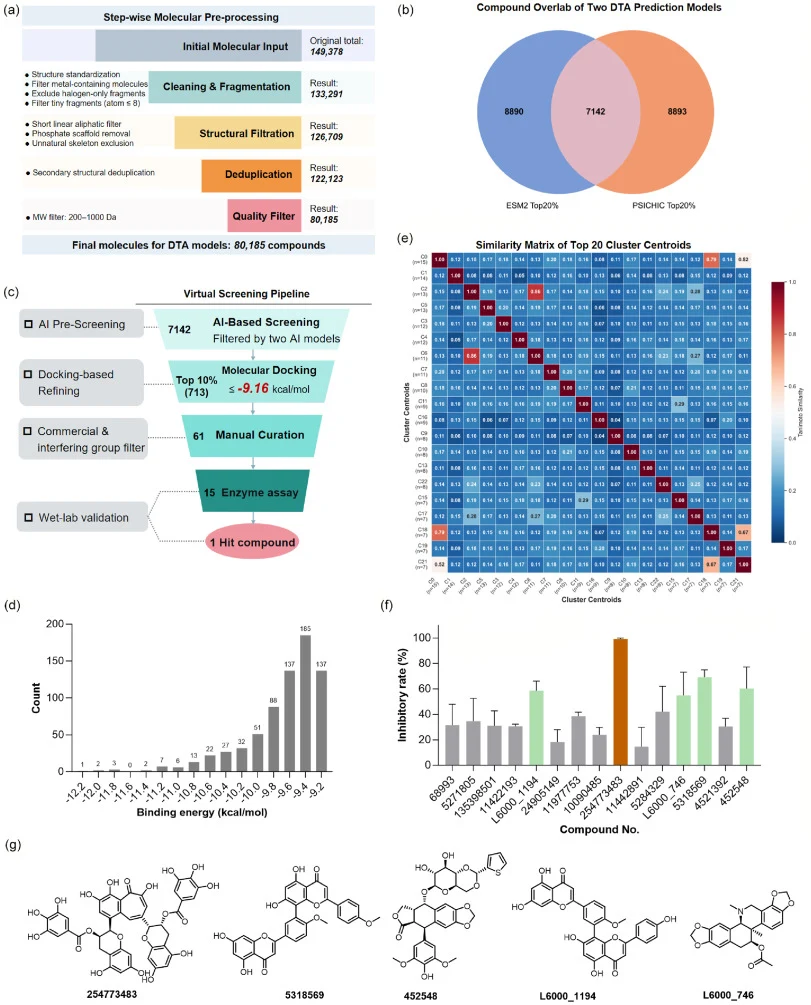
图3b中的Venn定量了PLM-CAFT-DTA和PSICHIC前20%排名输出的候选交集,保留7,142个化合物作为共享命中用于下游对接评估。中等重叠水平与我们先前的设计预期一致:两种架构之间不同的特征提取规则筛除了模型特异性假阳性,同时未丢弃结构多样的有前景骨架。候选数量通过每个连续过滤门持续缩减(图3c)。7,142个跨模型共享命中经过对接精修,其中713个分子(前10%)结合能≤ −9.16 kcal/mol被保留。进一步人工整理排除商业不可获得物质和含明显破坏性官能团的化合物,将候选名单缩小至61个化合物。初步优先排序后,15种代表性物质进入USP25酶抑制测试,最终产生一个经验证的活性命中化合物。
结合能直方图(图3d)显示保留候选物的对接分数主要聚集在−10.2至−9.2 kcal/mol之间;峰值样本数出现在−9.6 kcal/mol的区间,确认大多数优先配体在USP25结合口袋内形成有利相互作用。前20个聚类中心的成对相似性热图(图3e)显示大多数骨架组的跨簇结构相似性较低。聚类候选物中有限的重复化学骨架反映了多轮过滤后保留的良好骨架多样性,降低了发现具有冗余抑制机制的类似物的风险。
15种测试候选物在25 μM单一固定浓度下的体外USP25抑制筛选结果如图3f所示。大多数化合物在此浓度下表现出中等USP25抑制活性。除顶级命中(ID: 254773483)具有近100%抑制效率外,其他几种候选物包括L6000_1194、L6000_746、452548和5318569也显示出超过50%的USP25抑制率(图3g)。测试化合物表现出广泛的抑制效力范围。该结果证实了我们的多步骤计算流程能够从天然产物库中高效富集实验活性候选物,极大促进了湿实验验证。
【数据】原始分子池:149,378;清洗后:133,291;结构过滤后:126,709;去重后:122,123;最终筛选库:80,185;跨模型共享命中:7,142;对接精修保留(结合能≤−9.16 kcal/mol):713个(前10%);人工整理后:61个;进入酶抑制测试:15个;最终活性命中:1个;对接分数主要区间:−10.2至−9.2 kcal/mol;峰值:−9.6 kcal/mol;测试浓度:25 μM;顶级命中ID:254773483(近100%抑制);>50%抑制候选物:L6000_1194、L6000_746、452548、5318569
2.3 TF的生化表征:USP25抑制效力与抗氧化活性
进一步定量表征了TF(化合物ID: 254773483,茶黄素3,3′-双没食子酸酯)对USP25的抑制活性。拟合TF对USP25酶活性的剂量-反应曲线以计算其IC50值。如图4a所示,TF表现出强效的USP25抑制,IC50值为33 nM,与参考抑制剂CT1113(IC50 = 38 nM)相当。TF对同源USP28的IC50为280 nM,显示出对USP25约8.5倍的选择性……
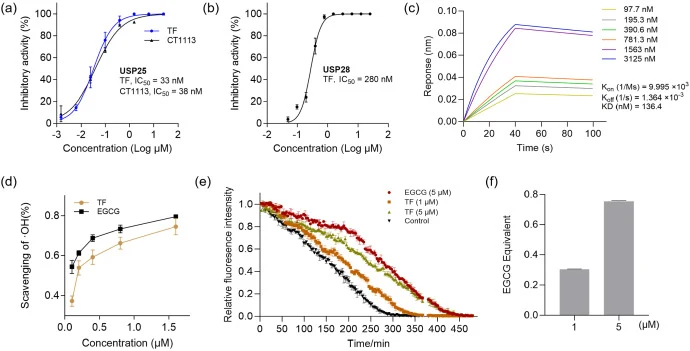
【数据】TF(ID: 254773483)对USP25 IC50:33 nM;CT1113对USP25 IC50:38 nM;TF对USP28 IC50:280 nM;选择性倍数:约8.5倍
讨论与解读
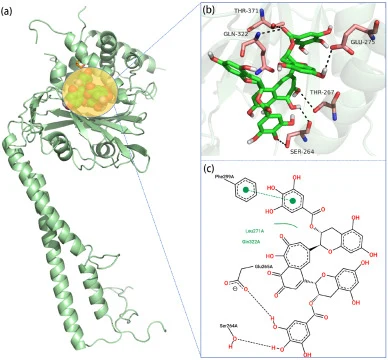
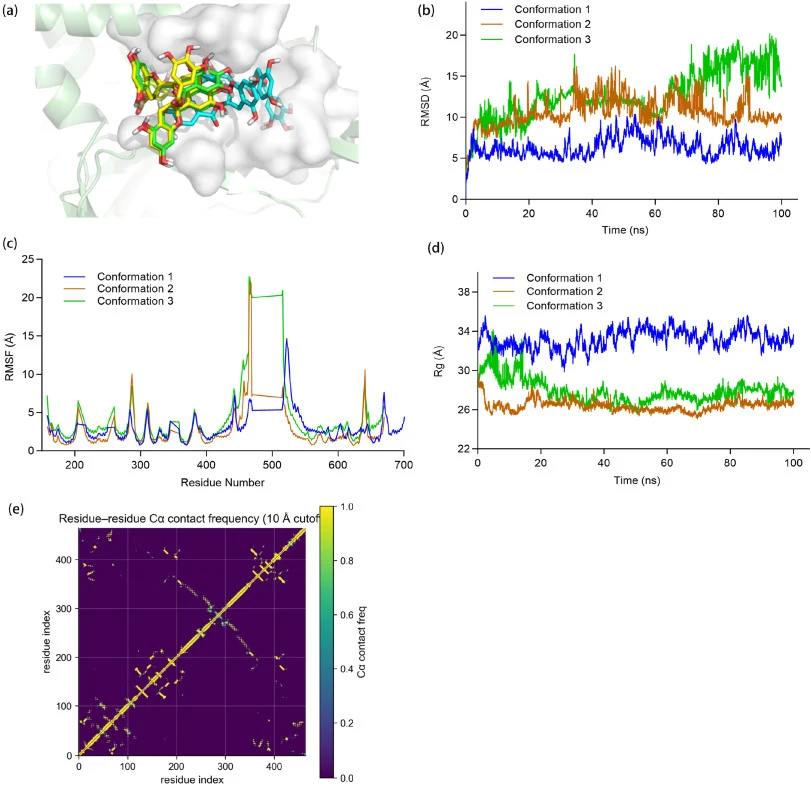
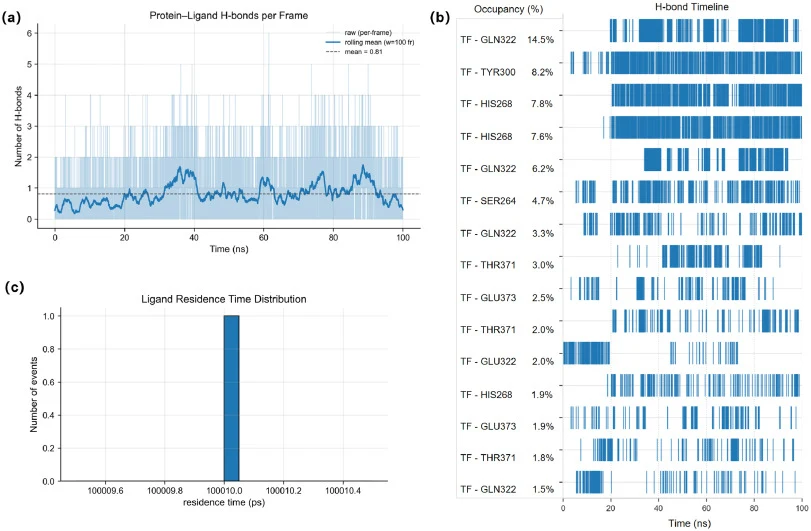
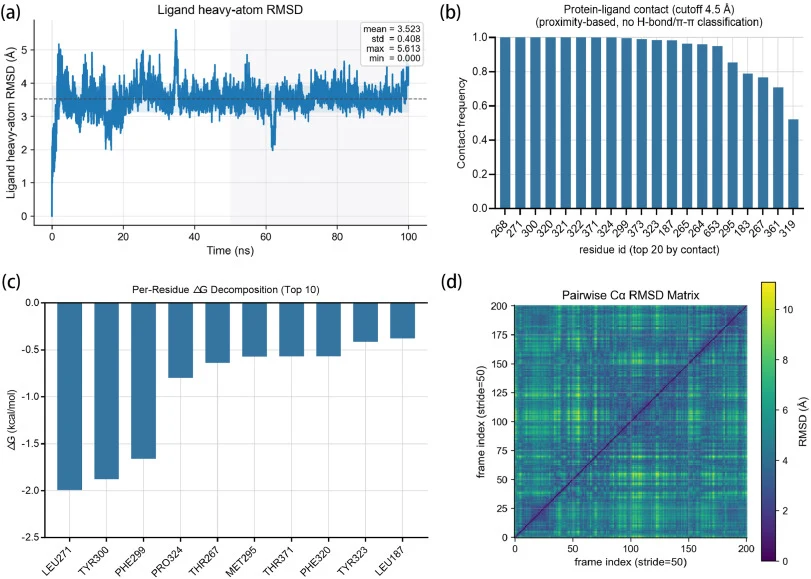
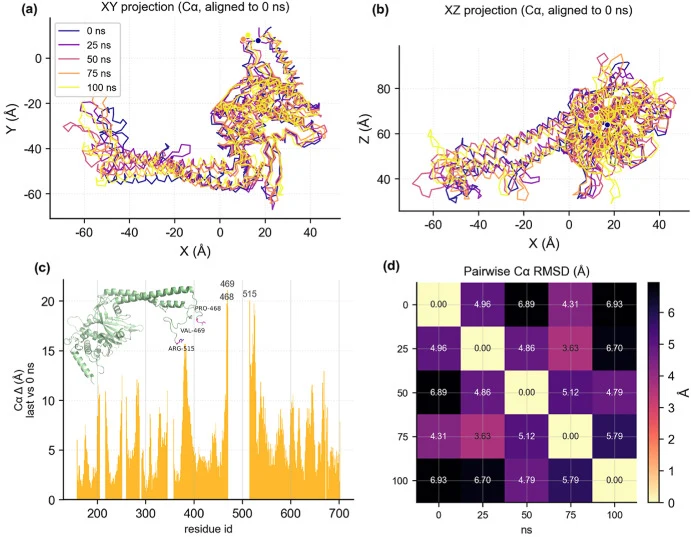
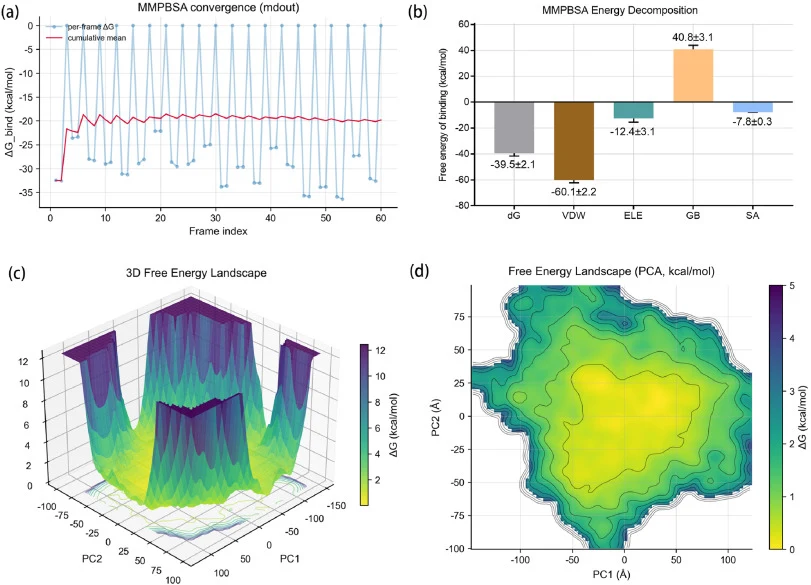
目前报道的USP25抑制剂数量仍然非常有限,大多数现有化合物是核心骨架相似的合成小分子。这种结构多样性化学探针的缺乏阻碍了靶向USP25的进一步机制研究和药物开发。为弥补这一不足,本研究构建了集AI活性预测和分子对接于一体的集成筛选工作流。利用该流程,多个具有USP25抑制活性的天然产物候选物在计算上被优先排序。其中,TF被实验验证为强效命中化合物,IC50值为33 nM。生化实验证实TF对USP25相对于其旁系同源物USP28具有8.5倍选择性,同时具有强的羟自由基和过氧自由基清除抗氧化能力。静态分子对接预测了TF与USP25之间的关键分子间接触,包括结合口袋内广泛的氢键网络和芳香π-π堆积。随后的100 ns MD模拟确认了TF-USP25复合物的结构稳定性:结合口袋在整个模拟过程中保持刚性几何构型。热力学分解揭示范德华相互作用是复合物形成的主要驱动力。自由能景观分析进一步表明USP25与TF结合时采用低能量、类天然亚稳态构象,未观察到能量紧张的蛋白构型。
编译者解读
该研究的核心价值在于方法学范式——用双深度学习DTA模型交叉筛选替代传统高通量筛选,将80,185个天然产物压缩至15个实验验证候选物,命中率达1/15。TF作为天然茶黄素类化合物,IC50 33 nM且具8.5倍选择性,兼具抗氧化活性,为USP25化学生物学提供了结构新颖的探针。局限在于:富集分析仅基于7种已知抑制剂,统计效力有限;MD模拟虽验证结合稳定性,但缺乏突变实验验证关键残基;TF的多酚类结构可能带来泛靶点脱靶效应,需后续选择性谱系评估。整体而言,该工作为缺乏共晶结构的去泛素化酶靶点提供了可复用的经济型筛选模板。
参考来源
期刊:European Journal of Medicinal Chemistry, 2026
DOI: 10.1016/j.ejmech.2026.119337
作者:Zhonghua Li
DOI: 10.1016/j.ejmech.2026.119337