来源:A machine learning framework for biorefinery pretreatment design(Journal of Energy Chemistry)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
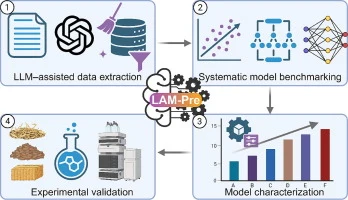
木质纤维素生物炼制是循环经济的重要支撑,但预处理优化长期受制于高成本和经验试错。本研究提出 LAM-Pre 框架,将大语言模型(LLM)辅助的文献数据提取、系统化机器学习基准测试与实验验证整合为一体,构建了覆盖 305 种生物质、1473 种预处理策略和 6 种酶的 Pret-Glucose 数据集。经 16 种监督模型对比,梯度提升决策树(GBDT)表现最优。虚拟筛选 1092000 种工艺条件组合,发现氢氧化钠-过氧化氢预处理可实现 96% 葡萄糖产率;在混合生物质体系中,实验产率较单一原料提升达 34.8%。
研究背景
木质纤维素生物炼制以低成本非粮原料生产燃料和绿色化学品,是循环经济的关键环节。生物质主要由纤维素、半纤维素和木质素构成,来源丰富,但其复杂超微结构导致天然抗降解性强,直接转化效率低。有效预处理因此成为提升生物质可及性和下游加工效率的必要步骤。
然而,预处理优化至今仍依赖经验性试错,成本高、周期长。大多数研究仅关注单一生物质类型,预处理策略在不同原料或混合原料间的泛化能力尚属未解难题。已开发的预处理手段涵盖物理法、化学法和物理化学法,但预处理联合酶水解的优化需要捕捉工艺条件与生物质特性之间复杂的非线性关系。传统实验设计方法——析因设计、空间填充法、响应面法等——依赖预设采样策略,难以高效覆盖高维设计空间。
研究方法
2.1 材料
从中国某农场采购了 24 种生物质,包括玉米秸秆、稻壳、甘蔗渣等。所有化学试剂购自 Takara(南京,中国)、Sigma-Aldrich Chemie(施泰因海姆,德国)、Sangon Biotech(南京,中国)和 Macklin(南京,中国)。纤维素酶(Cellic Ctec3)由北京高瑞森科技有限公司提供。
【数据】生物质种类:24 种;生物质来源:中国某农场;试剂供应商:Takara(南京)、Sigma-Aldrich Chemie(施泰因海姆,德国)、Sangon Biotech(南京)、Macklin(南京);酶:Cellulase (Cellic Ctec3),北京高瑞森科技有限公司
2.2 基于 ChatGPT 的数据收集与制表
从 Web of Science 数据库检索相关文献,关键词组合包括“biorefinery”“biomass conversion”“pretreatment”“enzymatic hydrolysis”和“glucose yield”。初步筛选仅考虑发表在影响因子(IF)大于 5 的期刊上的同行评审文章。为确保数据质量和相关性,仅纳入报告了明确处理条件和结果的研究,排除缺乏必要实验细节或仅含定性描述的研究。此外,实验条件须描述充分以保证可重复性。经上述标准筛选后,保留 2010 至 2023 年间发表的 800 篇文献,其中大多数集中在近年(2016–2023),反映了该领域的快速增长(图 S7)。随后通过结构化文本解析与人工校订相结合的方式从所选文献中提取数据。PDF 文档使用 fitz(PyMuPDF)库处理以提取相关文本。定义停用关键词(如致谢、参考文献)以排除非相关章节。每篇文章的关键章节如“Methods”和“Results”被标记和分段,确保每段满足指定长度约束。对每个章节应用定制化提示词以提取特定特征。使用 OpenAI 的 API(即 ChatGPT4)根据各提示词对提取内容进行审查、总结和制表。
【数据】数据库:Web of Science;关键词:biorefinery、biomass conversion、pretreatment、enzymatic hydrolysis、glucose yield;期刊影响因子阈值:>5;保留文献数:800 篇;发表年份范围:2010–2023;主要集中年份:2016–2023;PDF 处理库:fitz (PyMuPDF);LLM:ChatGPT4 (OpenAI API)
2.3 数据预处理
随后对数据集进行系统性预处理。第一,删除缺失值超过半数的数据条目。第二,基于领域知识识别并排除异常值(如处理温度合理范围 10–300 °C、反应时间 0 小时–30 天、产物产率 0–100%)。第三,执行冗余去除步骤以消除数据集中的重复条目(见 GitHub 链接中的 Biomass_dataset.xls:https://github.com/XiaojiuZhang/LAM-Pre.git),确保每条记录(由生物质类型、生物质组成、预处理条件等定义)唯一。为解决不同研究间的不一致性,进行了特征标准化。非数值文本特征(如生物质名称、化学试剂)使用 TF-IDF 编码,分类变量使用独热编码表示。尽管该编码策略增加了名义特征维度,但基于树的模型(如 GBDT)在训练过程中固有地执行特征选择,使模型能够聚焦于信息量大的变量,同时减少冗余特征的影响。具体而言,生物质类型根据其多样性分为六组,包括农业残余物、木材与木片、草类与植被、水生与海洋生物质、食品加工副产物以及园艺与果园副产物。数值变量(如温度和时间)转换为一致单位(如 °C 和小时)。此外,通过 API 从 PubChem 数据库检索化学试剂的理化性质以丰富特征表示。部分不完整条目中的缺失值使用 K 近邻(KNN)方法插补,仅应用于缺失有限的特征以最小化潜在偏差。最终数据集中的所有特征被系统组织为八个类别,包括生物质类型变量、生物质组成变量、预处理条件变量、物理过程变量、化学试剂理化性质变量、酶相关变量、酶水解条件变量和评价变量。所有变量的全称、缩写和详细描述见表 S2。预处理后共获得 1762 条数据条目。为确保完全透明和可重复性,完整数据集已在 GitHub 上公开(链接:https://github.com/XiaojiuZhang/LAM-Pre.git)。
为评估 ChatGPT 辅助数据提取的可靠性,采用分层抽样策略随机选取 20 条数据条目构建人工校订子集。从原始文献中独立提取关键变量,并与 ChatGPT 提取结果进行比较。对分类变量计算提取准确率。对连续变量使用平均绝对误差(MAE)、平均绝对百分比误差(MAPE)和 Pearson 相关系数(r)评估一致性。所有数值变量在比较前转换为一致单位(表 S7)。计算公式如下:
(1) MAE = (1/n) Σ|x_i^GPT - x_i^manual|
(2) MAPE = (1/n) Σ|(x_i^GPT - x_i^manual)/x_i^manual| × 100%
(3) r = Σ(x_i^GPT - x̄^GPT)(x_i^manual - x̄^manual) / √[Σ(x_i^GPT - x̄^GPT)² Σ(x_i^manual - x̄^manual)²]
(4) Accuracy = N_correct / N_total
【数据】异常值排除范围:温度 10–300 °C、时间 0 h–30 天、产率 0–100%;生物质分组数:6 组;最终数据条目数:1762 条;人工校订子集:20 条;编码方法:TF-IDF、独热编码;缺失值插补:KNN;特征类别数:8 类
2.4 模型设置
13 种机器学习方法包括岭回归、Lasso 回归、弹性网络回归、贝叶斯岭回归、支持向量回归、决策树、Bagging、随机森林、Extra Trees、梯度提升决策树(GBDT)、XGBoost、LightGBM 和 AdaBoost。所有机器学习模型使用 sklearn v.1.4.2 实现,除贝叶斯岭回归外,其他模型均使用 sklearn 库的 GridSearchCV 函数进行超参数调优以确定各模型的最优超参数设置。MLP 模型由三个全连接层组成:fc1 具有 202 个输入特征和 128 个输出特征,fc2 具有 128 个输入特征和 64 个输出特征,fc3 具有 64 个输入特征和 1 个输出特征。fc1 和 fc2 之后接批归一化、ReLU 激活和 Dropout 层以防止模型过拟合。本研究采用三层一维 CNN 架构,每个卷积层后应用批归一化、ReLU 激活和最大池化。第一卷积层将输入通道数从 1 增至 16,第二层增至 32,第三层增至 64。卷积层之后使用三个全连接层进行回归预测:fc1 具有 64×25 个输入特征和 256 个输出特征,fc2 具有 256 个输入特征和 64 个输出特征,fc3 具有 64 个输入特征和 1 个输出特征。fc1 和 fc2 之后应用批归一化、ReLU 激活和 Dropout 以减少过拟合。最终生成标量输出作为预测结果。本研究采用的循环神经网络(RNN)架构由 202 个特征的输入层和三个堆叠的 RNN 层(128 维隐藏层)组成。RNN 的输出通过两个全连接层进行回归预测:fc1 具有 128 个输入特征和 64 个输出特征,fc2 具有 64 个输入特征和 1 个输出特征。fc1 之后接批归一化、ReLU 激活和 Dropout 层以增强正则化并防止过拟合。训练过程中使用 AdamW 优化器,学习率为 0.001,损失函数为均方误差。批次大小设为 32,训练全程应用早停策略。所有深度学习模型使用 PyTorch 实现。
【数据】机器学习方法数:13 种;模型框架:sklearn v1.4.2;超参数调优:GridSearchCV;MLP 结构:fc1 202→128、fc2 128→64、fc3 64→1;CNN 结构:3 层 1D 卷积(通道 1→16→32→64),fc1 64×25→256、fc2 256→64、fc3 64→1;RNN 结构:输入 202 特征,3 层堆叠 RNN(128 隐藏维度),fc1 128→64、fc2 64→1;优化器:AdamW;学习率:0.001;损失函数:均方误差;批次大小:32;早停:是
研究结果
3.1 应用 LAM-Pre 的 LLM 辅助数据收集建立数据集
高质量数据准备是开发可靠预测模型的基础。我们首先建立了一个自动化流程,从已发表文献中提取和标记相关章节,如 Methods、Results 和 Discussion——这些章节最可能报告生物质预处理和水解条件,从而加速下游分析。应用提示词工程引导 ChatGPT 进行准确的信息提取。基于生物炼制领域知识(表 S1),实施了三项关键原则:(i)幻觉控制,通过明确指示模型在信息缺失或不确定时返回“N/A”实现;(ii)注释驱动提示,使用章节特异性提示词提取预定义变量(如从 Methods 中提取生物质组成);(iii)结构化输出强制,使用固定模板确保一致性并便于后续数据处理。所得数据集进一步整理以确保与机器学习兼容。非数值文本使用 TF-IDF 嵌入编码,分类变量进行独热编码,数值特征(如温度和处理时间)在专家辅助下进行单位标准化。最终 Pret-Glucose 数据集包含 305 种生物质类型、1473 种预处理策略和 6 种酶,可直接适用于监督式机器学习工作流。
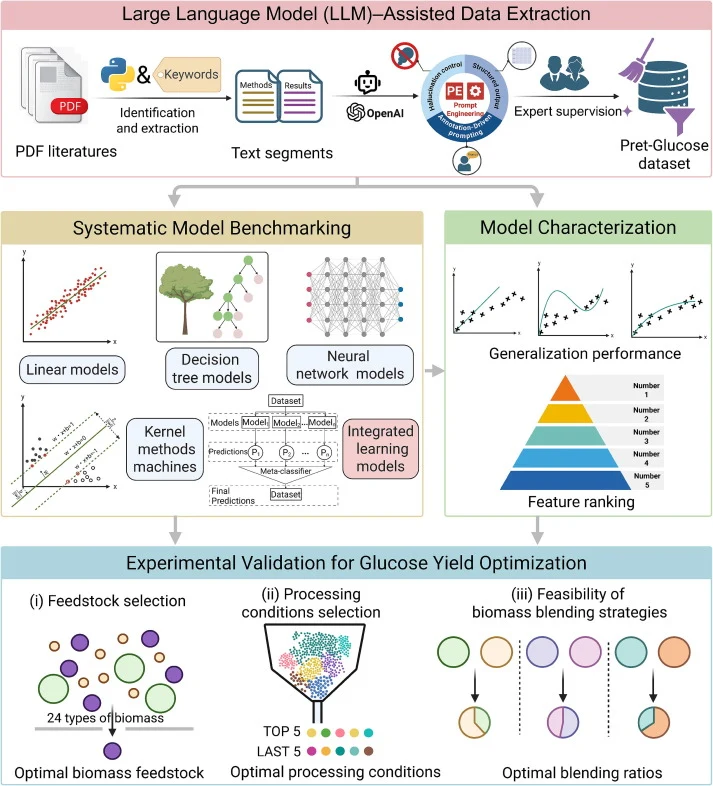
【数据】生物质类型:305 种;预处理策略:1473 种;酶:6 种;数据提取原则:3 项;编码方法:TF-IDF、独热编码
3.2 机器学习模型用于葡萄糖产率预测的基准测试
为确定葡萄糖产率预测的最优模型,我们对 16 种监督学习算法进行了基准测试,涵盖 4 种线性模型、1 种基于核的方法、2 种决策树模型、3 种深度学习架构(MLP、CNN 和 RNN)以及 6 种集成方法(图 2)。在留出测试集上的评估显示,线性模型表现不佳(如岭回归,R² = 0.341),反映了其捕捉非线性关系的能力有限。相比之下,基于 Bagging 和 Boosting 的集成模型取得了显著更好的预测性能(Extra Trees,R² = 0.652;XGBoost,R² = 0.650),其中 GBDT 在所评估模型中表现最佳(R² = 0.672)。深度学习模型表现出中等预测能力(MLP,R² = 0.652;RNN,R² = 0.626;CNN,R² = 0.547),但未超过集成方法(图 S1–S3)。在 RMSE、PCC 和 MAE 等其他评价指标上观察到一致趋势,进一步证实了 GBDT 模型相对更优的性能(图 2a–d)。图 2(g) 展示了 GBDT 框架的架构,其中顺序训练的决策树集成逐步校正残差误差。集成模型的优越性源于葡萄糖产率预测的内在非线性和多变量特性——其取决于生物质组成、预处理参数和酶水解条件。鉴于数据集规模相对有限(约 2000 个样本),深度学习模型容易过拟合[42,43],而集成方法对噪声和异质特征分布表现出相对更好的容忍度。这一观察也反映了文献来源生物质数据集中模型复杂度与数据规模之间的固有权衡——过度的模型灵活性可能导致过拟合而无益于泛化。预测值与实验值的奇偶图(图 2(e) 和图 S1–S3)显示 GBDT 预测紧密聚集在 y = x 线附近,95% 置信区间较窄。虽然观察到训练(R² = 0.883)与测试(R² = 0.672)之间的性能差距,但仅此差距不一定表明过拟合,特别是在有限、嘈杂和异质的实验数据集背景下。在诸如本研究这样的实验数据集中,固有噪声、测量变异性和有限样本量可自然导致测试性能下降,即使对预测模型也是如此。重要的是,我们未观察到典型的过拟合特征,如训练过程中训练和验证曲线之间的快速发散。尽管如此,测试性能保持稳定并与交叉验证结果一致,表明模型在当前文献来源数据集中捕捉到了相对稳定的趋势级关系。测试集样本按真实葡萄糖产率排序并分为三个区间:高(0.8–1.0)、中(0.2–0.8)和低(0–0.2)。对应的平均绝对误差分别为 0.172、0.080 和 0.146。因此,该误差分析表明预测性能在样本密集的中等产率区间(0.2–0.8)相对更稳定,而在分布两端出现较大偏差。这可归因于低产率和高产率两端的数据稀疏性。低产率数据可能因发表偏倚而代表性不足,而高葡萄糖产率(>0.8)对大多数生物质类型而言因结构抗降解性和工艺限制更难实现,仅有少数研究充分的底物在优化条件下例外。此外,许多研究聚焦于比较或参数分析,导致中等产率区间样本密度更高。这种偏态分布在文献来源数据集中很常见,可能导致极端值处预测精度降低(图 2f)。总体而言,这些结果表明 GBDT 在当前文献来源数据集中提供了相对更稳定的趋势级预测性能。尽管 R² 值中等,但与异质文献来源生物质数据集的预期一致,并得到强相关指标(如 PCC)和实验结果的进一步支持,表明具有中等但一致的趋势级预测能力。
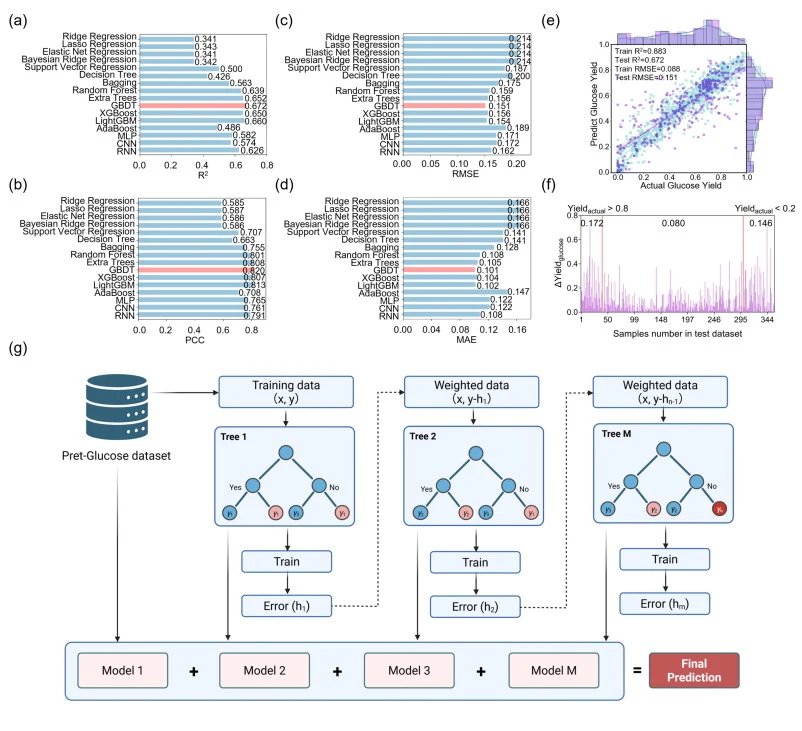
【数据】基准测试模型数:16 种;岭回归 R² = 0.341;Extra Trees R² = 0.652;XGBoost R² = 0.650;GBDT R² = 0.672;MLP R² = 0.652;RNN R² = 0.626;CNN R² = 0.547;GBDT 训练 R² = 0.883,测试 R² = 0.672;高产率区间(0.8–1.0)MAE = 0.172;中等产率区间(0.2–0.8)MAE = 0.080;低产率区间(0–0.2)MAE = 0.146;数据集规模:约 2000 个样本
3.3 外部泛化评估与特征重要性分析
为评估模型在新发表研究间的迁移能力,我们构建了一个独立基准,包含从 2024 至 2026 年发表文献中提取的 50 个样本,确保与模型开发数据集完全分离。训练阶段表现最优的五个模型(GBDT、LightGBM、XGBoost、MLP 和 RNN)在该外部数据集上使用 R²、PCC、RMSE 和 MAE 进行评估(图 3a)。其中 GBDT 表现出最佳整体性能,PCC 达 0.694,R² 为 0.468,同时 RMSE 和 MAE 值相对较低。相比之下,深度学习模型对异质外部数据集的迁移能力有限,表明模型复杂度的增加不一定转化为此类表格数据集上的性能提升。预测值与实验值葡萄糖产率的比较进一步表明 GBDT 能够捕捉未见数据上的整体趋势级关系,尽管在极端情况下仍观察到精度降低(图 3b,图 S8)。这些结果表明,虽然在异质外部数据上的绝对预测精度仍然中等,但模型在识别不同工艺条件间的相对性能趋势方面保留了实用价值。为解释模型行为,应用了 SHAP 分析。如图 3(c) 所示,预处理相关特征(39.6%)和酶水解相关特征(38.8%)对葡萄糖产率预测的贡献相对较大,其次是生物质组成相关特征(约 20%),这是在当前数据集和特征表示框架下的结果。虽然这一层级与已有实验认识大体一致[44,45],但 SHAP 分析不应被解释为对生物质特性内在重要性的严格机理量化,特别是因为某些……
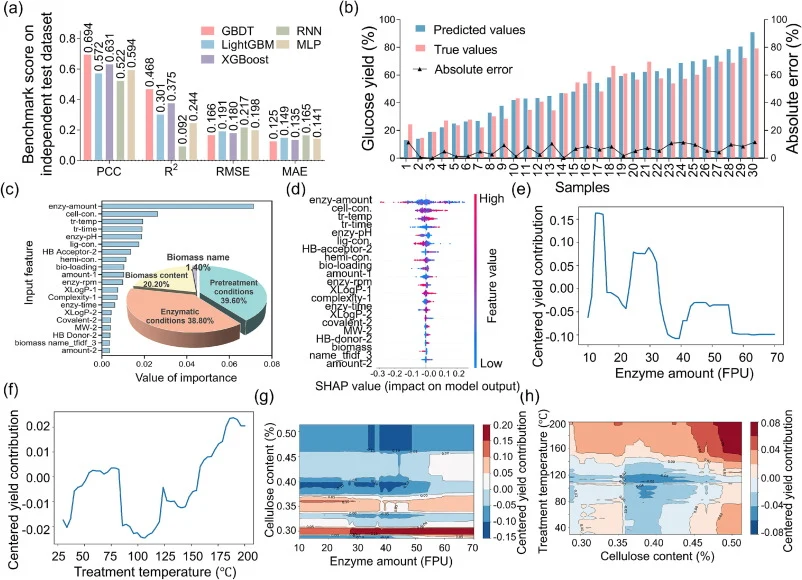
【数据】外部基准样本数:50 个;文献发表年份:2024–2026;GBDT 外部验证 PCC = 0.694,R² = 0.468;预处理特征贡献:39.6%;酶水解特征贡献:38.8%;生物质组成特征贡献:约 20%
3.4 针对多重挑战的 LAM-Pre 验证
为验证 LAM-Pre 在多种挑战场景下的实用性,选取了六种类型的 24 种生物质进行验证(图 4a)。类型 I 为农业残余物,包括玉米秸秆、稻壳、高粱壳和高粱秆。类型 II 为木材与木片……
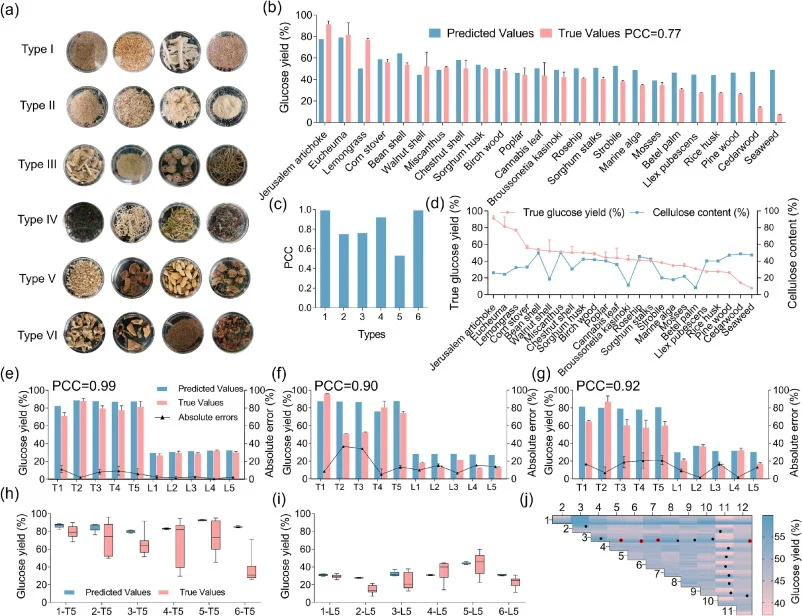
【数据】验证生物质数:24 种;生物质类型数:6 种;类型 I:玉米秸秆、稻壳、高粱壳、高粱秆
讨论与解读
LAM-Pre 建立了一个实用的数据驱动框架,用于跨多种木质纤维素原料、预处理策略和酶水解条件的葡萄糖产率趋势级预测与探索性优化。通过整合 LLM 辅助数据提取、系统化机器学习基准测试和实验验证,该工作解决了生物炼制工程中的一个核心瓶颈:缺乏可扩展的数据驱动工具来在现实约束下导航高维工艺设计空间。LAM-Pre 能够快速筛选原料、预处理化学和操作条件,从而支持初步实验优先级排序,促进潜在有利工艺条件的探索。混合生物质体系的评估能力对工业部署尤为重要——原料异质性、季节性供应和供应链变异性在工业场景中不可避免。通过识别高产率工艺窗口和非直觉性预处理组合,LAM-Pre 可支持更灵活的生物炼制工艺探索,提升经济可行性。未来,将 LAM-Pre 与技术经济分析(TEA)、生命周期评估(LCA)和过程模拟工具整合,将实现超越葡萄糖产率的生物质转化系统整体优化。然而,当前框架仍受限于……
编译者解读:该研究的核心价值在于用 LLM 打通了文献数据到机器学习模型的自动化通路,1762 条数据的规模虽不算大,但覆盖 305 种生物质和 1473 种预处理策略的广度在同类工作中少见。GBDT 在异质表格数据上击败深度学习模型的结果符合领域直觉——小样本、高噪声场景下,集成树的鲁棒性优于神经网络。混合生物质产率提升 34.8% 是亮点,提示原料复配可能成为绕过单一原料预处理瓶颈的实用策略。局限同样明显:R² 仅 0.672(测试集)和 0.468(外部验证),距定量预测尚有距离,SHAP 分析也仅停留在趋势层面。该框架当前定位应是实验优先级排序工具,而非替代实验的预测引擎。
参考来源
期刊:Journal of Energy Chemistry, 2026
DOI: 10.1016/j.jechem.2026.05.038
DOI: 10.1016/j.jechem.2026.05.038