来源:Machine Learning Guided Identification and Molecular Dynamics Evaluation of Candidate SARS-CoV-2 Main Protease Inhibitors from Xeromphis nilotica Stem Bark Phytochemicals(In Silico Research in Biomedicine)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
SARS-CoV-2 主蛋白酶(Mpro)是抗病毒药物开发的重要靶点。本研究以 Xeromphis nilotica 茎皮为研究对象,通过 GC-MS 鉴定其植物化学成分,结合机器学习 QSAR 建模、SwissADME 成药性评估、分子对接、500 ns 分子动力学模拟、MM-GBSA 结合自由能分析和密度泛函理论计算,构建了一套整合计算筛选流程。研究从 158 个有效化合物中筛选出 CID_146102 作为最具潜力的先导骨架,其 MM-GBSA 结合自由能为 −36.36 ± 0.46 kcal/mol,但仍弱于阳性对照奈玛特韦。该化合物尚需酶抑制实验和细胞抗病毒实验验证。
研究背景
SARS-CoV-2 是 COVID-19 的病原体,因其遗传变异能力、反复传播以及在脆弱人群中持续引发临床显著疾病,至今仍是抗病毒药物研发的重要对象。尽管疫苗、公共卫生干预和抗病毒治疗已减轻了 COVID-19 的临床负担,但 Alpha、Beta、Gamma、Delta、Omicron 及其后续亚谱系的不断演化表明,病毒进化可改变传播力、免疫识别和治疗应答。因此,抗病毒研发必须持续靶向那些对功能破坏耐受性较低的病毒组分。
SARS-CoV-2 主蛋白酶(Mpro,又称 3C 样蛋白酶)是直接作用抗病毒药物开发中最具吸引力的分子靶点之一。Mpro 是一种半胱氨酸蛋白酶,负责将病毒多聚蛋白切割为病毒复制和转录所需的功能性非结构蛋白。抑制该酶可阻断病毒生命周期中的关键步骤。Mpro 含有由 His41 和 Cys145 构成的保守催化二联体,以及底物结合亚位点。
Xeromphis nilotica 是一种具有报道镇痛和抗炎活性的药用植物,其茎皮含有多种代谢产物。本研究旨在利用 GC-MS 鉴定其茎皮中的植物化学成分,并通过整合计算工作流评估这些化合物作为 Mpro 抑制骨架的潜力。
研究方法
2.1 植物采集、鉴定与样品制备
新鲜 X. nilotica 茎皮采集自尼日利亚约贝州 Gujba 地方政府区。植物材料取自健康成熟植株,置于清洁无菌样品袋中,运送至实验室处理。植物学鉴定由约贝州立大学植物学系合格分类学家完成,凭证标本保存于植物标本馆,凭证号为 YSUH_069,以供后续参考。茎皮经人工清理去除土壤颗粒、灰尘及其他外来物质,随后在通风良好的区域于环境室温下阴干,以尽量减少热敏性植物成分的降解。干燥树皮使用清洁实验室研磨机机械粉碎为细粉,储存于密封容器中直至提取。阴干、适当粉碎和 protected 储存是标准生药学程序,可提高样品稳定性、增加溶剂接触面积并增强提取效率[18]。
【数据】植物部位:茎皮;采集地:尼日利亚约贝州 Gujba 地方政府区;凭证号:YSUH_069;干燥方式:阴干;干燥温度:环境室温;储存条件:密封容器
2.1.1 序贯溶剂提取
粉末状茎皮采用递增极性的溶剂进行序贯索氏提取,所用溶剂依次为正己烷、乙酸乙酯、正丁醇和甲醇。选择该溶剂序列是为了从植物基质中广泛回收非极性、中等极性和极性植物成分。对于每种溶剂组分,取一定量粉末样品用适当体积溶剂提取,直至虹吸管几乎无色,表明提取完全。所得提取物经过滤、浓缩至干、按溶剂组分标记,并储存于密封琥珀色瓶中,4°C 保存直至进一步分析。序贯索氏提取在天然产物研究中很有用,因为连续溶剂回流可提高植物材料中化学多样性代谢物的回收率[19]。
【数据】提取方法:序贯索氏提取;溶剂序列:正己烷→乙酸乙酯→正丁醇→甲醇;提取终点:虹吸管几乎无色;储存温度:4°C;储存容器:密封琥珀色瓶
2.2 气相色谱-质谱(GC-MS)分析
正己烷、乙酸乙酯、正丁醇和甲醇组分的化学成分采用气相色谱-质谱联用仪测定。每种干燥提取物用分析级甲醇复溶,涡旋以确保完全溶解,并在进样前通过 0.22 µm PTFE 注射器过滤器过滤。分析使用配备电子电离源的 GC-MS 系统,电离能量为 70 eV。色谱分离在 HP-5MS 熔融石英毛细管柱上实现,柱尺寸为 30 m × 0.25 mm 内径 × 0.25 µm 膜厚。氦气用作载气,流速为 1.0 mL/min,每种制备样品进样 1 µL,采用分流模式,分流比为 1:20。柱温箱程序设置为初始温度 50°C 保持 2 min,随后以 10°C/min 升至 280°C,最终保持 10 min。进样器和检测器温度分别维持在 250°C 和 280°C,质谱采集范围 m/z 40 至 550。推定化合物鉴定通过将所得质谱与 NIST 和 Wiley 质谱库中的参考谱图比对完成。仅光谱相似度指数至少为 90% 的化合物被考虑用于初步注释。在可获得的情况下,鉴定进一步由保留指数和诊断性碎裂模式支持,以降低错误化合物归属的风险。每种检测化合物的相对丰度通过峰面积归一化估算,并以总离子流图的百分比组成表示。最终化合物列表经整理去除重复条目,然后用于下游化学信息学、机器学习、对接和分子动力学分析。该方法与标准天然产物分析工作流程一致,即 GC-MS 代谢物注释之后、计算筛选之前进行结构整理[20–21]。从质谱库匹配获得的化合物身份被视为推定注释。硅氧烷相关及其他可能与分析污染有关的条目在数据整理期间被标记并谨慎解读。
【数据】电离方式:电子电离;电离能量:70 eV;色谱柱:HP-5MS(30 m × 0.25 mm × 0.25 µm);载气:氦气;流速:1.0 mL/min;进样量:1 µL;分流比:1:20;初始温度:50°C(2 min);升温速率:10°C/min;终温:280°C(10 min);进样器温度:250°C;检测器温度:280°C;质谱范围:m/z 40–550;相似度阈值:≥90%;过滤孔径:0.22 µm PTFE
2.3 机器学习引导的 QSAR 建模用于化合物优先级排序
在 GC-MS 鉴定和 X. nilotica 茎皮代谢物结构整理的基础上,实施了一个机器学习整合的定量构效关系(QSAR)框架,以在分子对接之前基于对 SARS-CoV-2 主蛋白酶(Mpro)的预测抑制活性对 GC-MS 来源化合物进行优先级排序。训练数据集由精心整理的实验验证 Mpro 抑制剂组成,活性值以 IC₅₀ 报告并标准化为微摩尔单位。这些值使用关系式 pIC₅₀ = 6 − log₁₀(IC₅₀,µM) 转换为 pIC₅₀,该转换可归一化活性分布并提高回归模型稳定性[13,15]。该转换改善了化合物间的可比性并减少了活性数据的偏度,从而支持预测建模。数据整理遵循既定 QSAR 最佳实践,以确保数据集完整性和可重复性。使用基于规范 SMILES 的去重方法去除重复化合物,同时通过 RDKit 验证排除结构无效条目[22]。额外预处理包括去除不一致或冲突的活性记录,以及在需要时标准化化学结构[23]。纳入标准基于数据质量、结构有效性和生物活性测量的一致性,符合现代 QSAR 对异质数据集的建议。这种质量驱动的整理策略为可重复的模型开发提供了基础。
【数据】活性值单位:IC₅₀(µM);转换公式:pIC₅₀ = 6 − log₁₀(IC₅₀,µM);去重方法:规范 SMILES;验证工具:RDKit
2.3.1 分子表示与描述符计算
所有有效化合物编码为规范 SMILES,并由 RDKit 计算的两个互补特征块表示[22]:33 个物理化学和拓扑描述符(包括分子量、精确分子量、计算亲脂性、拓扑极性表面积、药物相似性定量估计、重原子数、氢键供体和受体数、可旋转键数、环数、芳香环和脂肪环数、杂原子数、sp³ 碳分数、Labute 可及表面积、Bertz 复杂度指数、Balaban 指数、Kappa 形状指数、Chi 连接性指数和 Hall-Kier alpha 参数),以及以键半径二生成的 1024 位 Morgan 指纹,合计产生 1,057 个输入特征。物理化学描述符捕获分子大小、极性、疏水性、氢键潜力、柔性、环结构和结构复杂度,而指纹位编码局部子结构模式,共同提供与配体识别、结合互补性和药物相似性相关的全局和局部结构信息[13]。
【数据】描述符数量:33 个物理化学/拓扑描述符;指纹:1024 位 Morgan 指纹(键半径 2);总特征数:1,057
2.3.2 描述符过滤与特征选择
特征预处理仅使用训练分区拟合,以防止信息泄漏到验证集、外部测试集和植物化学预测集。缺失描述符值使用训练集中位数填充,训练集中方差为零的特征被移除,因为这些特征对模型学习无判别信息贡献。对于对特征尺度敏感的算法(Ridge、Elastic Net、偏最小二乘、支持向量回归、k-最近邻及两种神经网络架构),特征额外标准化为零均值和单位方差;基于树和梯度提升集成方法不进行标准化拟合,因为它们——
【数据】缺失值填充:训练集中位数;零方差特征:移除;标准化方法:零均值单位方差(仅对尺度敏感算法);未标准化算法:树基和梯度提升集成方法
2.3.3 QSAR 模型构建与评估
(原文该节内容未在节选中完整呈现,以下为节选可见部分)
LightGBM 表现出最佳 QSAR 性能,验证 R² = 0.640,外部 R² = Q² = 0.492。由于模型未满足预定义的 Tropsha 验证标准,仅用于探索性排序而非定量效力预测。
【数据】最佳模型:LightGBM;验证 R²:0.640;外部 R² = Q²:0.492;验证标准:Tropsha 标准(未满足)
2.4 分子对接
(原文该节内容未在节选中完整呈现)
2.5 分子动力学模拟
(原文该节内容未在节选中完整呈现)
2.6 MM-GBSA 结合自由能分析
(原文该节内容未在节选中完整呈现)
2.7 密度泛函理论计算
(原文该节内容未在节选中完整呈现)
研究结果
3.1 化合物提取与 GC-MS 基化合物鉴定
X. nilotica 茎皮序贯溶剂提取物的 GC-MS 分析表明,该植物含有化学多样性的代谢物库,适合计算优先级排序。四个溶剂组分初步鉴定出 268 种推定代谢物,其中正丁醇提取物 60 种、甲醇 28 种、乙酸乙酯 120 种、正己烷 60 种,表明茎皮的植物化学成分不限于单一极性类别(补充材料 1)。相反,代谢物分布于非极性、中等极性和极性组分中。这种分布很重要,因为药用植物的生物活性通常与化学异质性混合物相关,而非单一优势化合物类别。因此,使用序贯溶剂为下游基于配体和基于结构的筛选提供了更广泛的化学空间。
乙酸乙酯组分中检测到的化合物数量较多是 GC-MS 输出中最重要的观察之一。乙酸乙酯回收了 120 种化合物,代表初始代谢物库的最大部分(补充材料 1)。这表明中等极性成分在 X. nilotica 茎皮中大量存在。从药物发现的角度来看,这具有相关性,因为中等极性化合物通常在水溶性和疏水相互作用潜力之间表现出比高非极性或高极性化合物更有利的平衡。这种平衡对于早期命中鉴定很重要,因为候选分子必须具有足够的极性以支持氢键,以及足够的疏水性以占据酶结合口袋。这一发现支持将乙酸乙酯富集的化合物库与其他组分化合物一起进行 QSAR 建模、ADME 过滤和针对 SARS-CoV-2 主蛋白酶的对接。类似的溶剂依赖性生物活性植物代谢物回收已在植物化学提取研究中报道,其中提取效率受溶剂极性和化合物溶解度强烈影响[47–48]。
正己烷和正丁醇组分中检测到的化合物数量相当,进一步表明 X. nilotica 茎皮含有亲脂性和中等亲水性代谢物。正己烷组分预期含有疏水性化合物,如烃类、脂肪酸衍生物、萜烯及相关亲脂性分子。相比之下,正丁醇组分预期回收更多含氧和氢键化合物。这种化学分布与本研究相关,因为 SARS-CoV-2 Mpro 的配体识别依赖于疏水接触、氢键和空间互补性的组合。因此,从化学性质不同的溶剂组分中回收化合物增加了鉴定在 Mpro 催化口袋内具有不同相互作用模式的分子的可能性。
甲醇组分中检测到的化合物数量相对较少并不一定意味着缺乏植物化学相关性。相反,它表明在本研究使用的提取和分析条件下,GC-MS 可检测的甲醇溶性成分较少。高极性代谢物可能挥发性较低、热不稳定,或在不衍生化的情况下不太适合直接 GC-MS 检测。因此,甲醇结果应被解释为可检测化合物的 GC-MS 基表示,而非植物中所有极性代谢物的完整测量。这一区分很重要,因为 GC-MS 对挥发性和半挥发性化合物特别有效,而某些高极性成分可能需要 LC-MS 或其他互补分析平台才能更完整地分析。
将初始 GC-MS 注释减少到 170 种非冗余化合物是可靠计算分析的必要步骤。在天然产物 GC-MS 数据集中,重复化合物注释可能出现,因为同一化合物可出现在多个组分中,因为结构相似的化合物可能被文库归属,或因为重复峰可能出现在不同保留窗口。如果这些条目未经整理,计算筛选可能因同一或几乎相同化学结构的重复表示而产生偏差。因此,使用化合物名称标准化和基于规范 SMILES 的协调改善了描述符生成前数据集的化学完整性。这与公认的化学信息学实践一致,即结构整理、去重和分子表示验证在 QSAR 建模和虚拟筛选之前至关重要[13,23]。
整理的 170 种独特化合物集为机器学习优先级排序提供了更合适的化学库,因为它代表结构多样性而非重复的 GC-MS 注释(补充材料 2)。这一区分对本研究很重要。QSAR 模型从分子描述符学习,重复或错误表示的结构可能扭曲预测模式、影响适用域评估并影响化合物排序。通过使用整理的非冗余库,下游 QSAR 分析不太可能过度代表任何单一化合物,更可能基于与预测 Mpro 抑制相关的结构特征对候选物进行优先级排序。
GC-MS 谱图也为 X. nilotica 报道的药用相关性提供了化学基础。先前的药理学工作报道了 X. nilotica 提取物的镇痛和抗炎活性,本研究的植物化学成分谱支持这些生物效应可能源于多种代谢物类别而非单一成分的可能性[12]。检测到萜类相关化合物、脂肪酸衍生物、芳香化合物、醇类和其他含氧代谢物,与具有生物活性潜力的药用植物中常见的化学多样性一致。然而,本研究结果应谨慎解读,因为除非通过真实标准品、保留指数匹配和额外光谱验证确认,GC-MS 鉴定是推定的。因此,GC-MS 结果应被视为计算优先级排序的合理起点,而非抗病毒活性的直接证据。
原始 GC-MS 输出中硅氧烷相关注释的存在未被视作植物来源代谢物的直接证据。在本工作流程中,这些条目被谨慎考虑,因为未经核实纳入可能夸大提取物的表观化学多样性并向计算筛选库引入弱候选物。因此,硅氧烷注释化合物未就 X. nilotica 的生物潜力过度解读。它们在本研究中的主要相关性是方法学的,因为它们强调了 QSAR 建模、ADME 过滤和对接之前化合物整理的重要性。这种谨慎解读通过确保下游优先级排序聚焦于结构有意义的植物化学物而非可能的分析伪影,增强了整理化合物集的可靠性[21,49]。
GC-MS 注释代表暂定结构归属而非确认的代谢物身份。因此,这些化合物的计算评估基于所归属的结构,优先候选物的身份需要独立分析确认。GC-MS 结果确立了 X. nilotica 茎皮含有广泛且化学多样的代谢物库,其中乙酸乙酯组分——
【数据】总推定代谢物:268 种;正丁醇:60 种;甲醇:28 种;乙酸乙酯:120 种;正己烷:60 种;整理后非冗余化合物:170 种;相似度阈值:≥90%
3.2 机器学习 QSAR 建模与化合物优先级排序
(原文该节内容未在节选中完整呈现)
LightGBM 表现出最佳 QSAR 性能,验证 R² = 0.640,外部 R² = Q² = 0.492。由于模型未满足预定义的 Tropsha 验证标准,仅用于探索性排序而非定量效力预测。
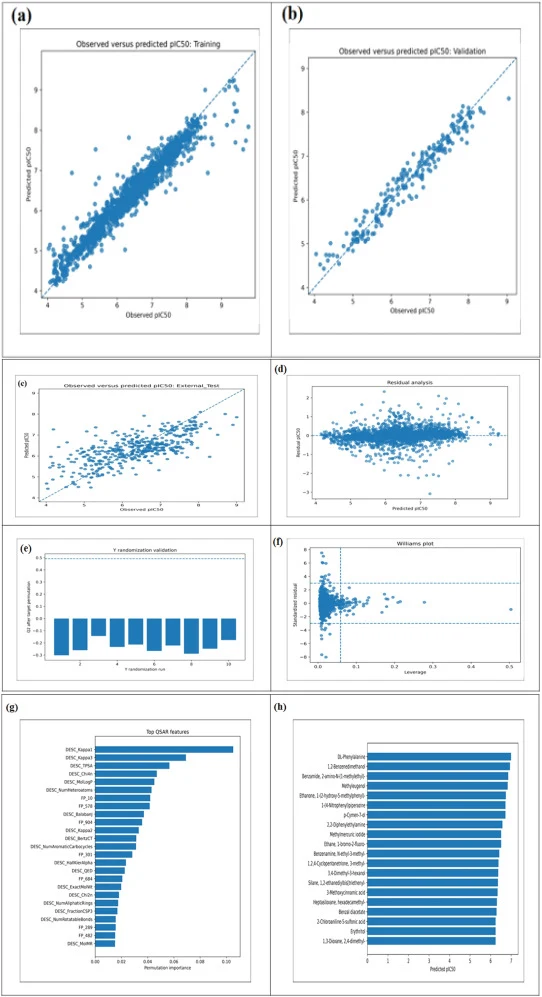
【数据】最佳模型:LightGBM;验证 R²:0.640;外部 R² = Q²:0.492;验证标准:Tropsha 标准(未满足);用途:探索性排序
3.3 SwissADME 成药性评估
(原文该节内容未在节选中完整呈现)
SwissADME 保留了七个药物样候选物。
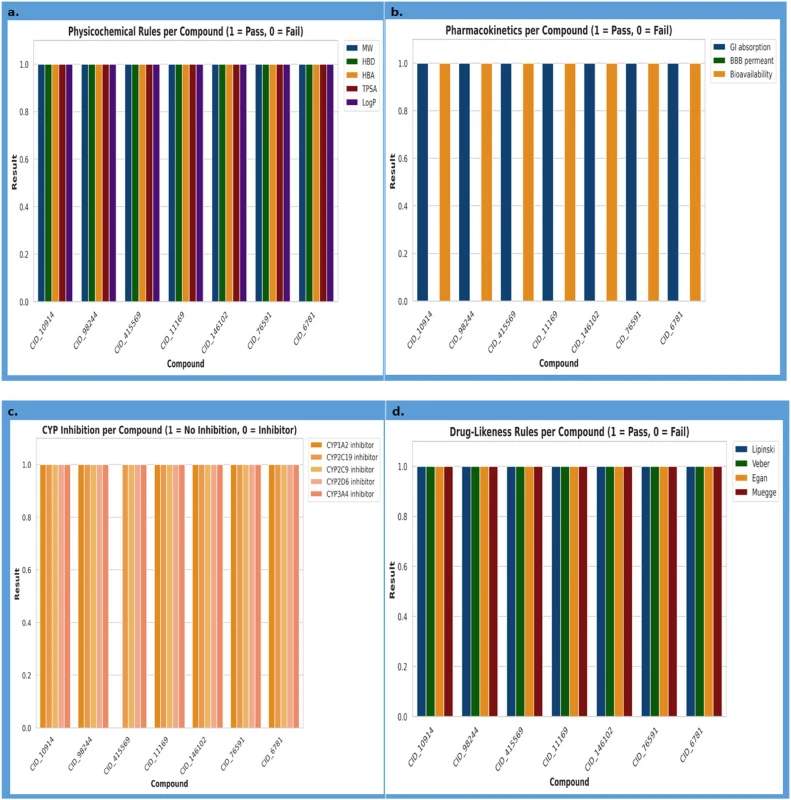
【数据】保留候选物数量:7 个
3.4 分子对接分析
(原文该节内容未在节选中完整呈现)
六个化合物显示在 Mpro 催化口袋内有利结合,尽管所有化合物的对接亲和力均弱于奈玛特韦。
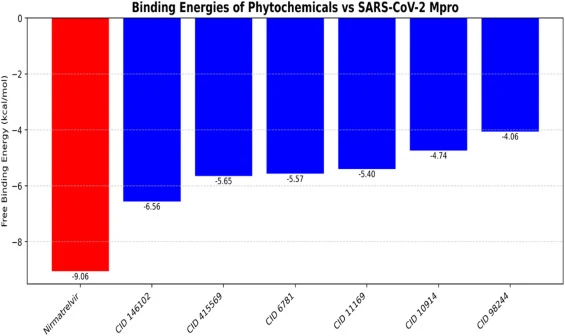
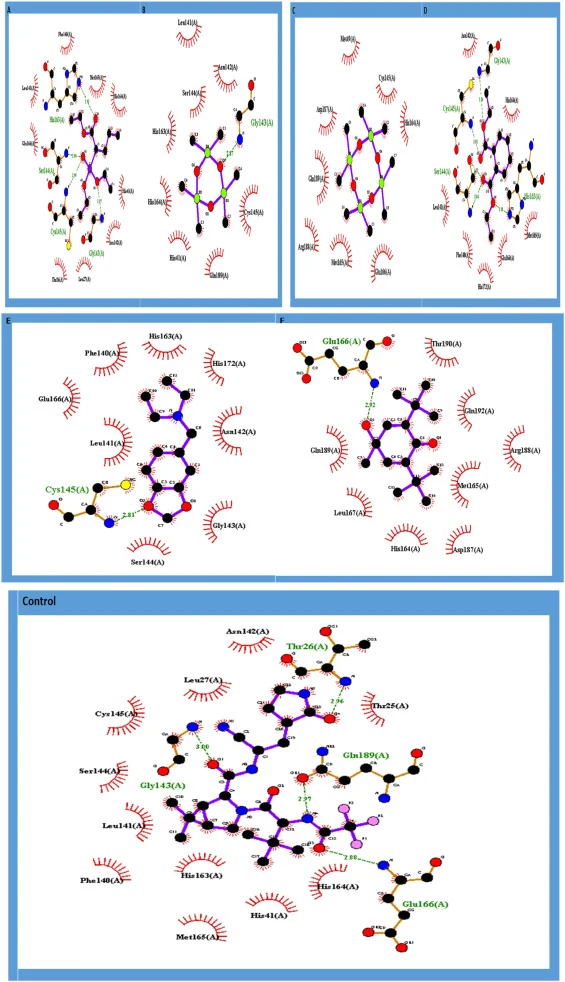
【数据】有利结合化合物数:6 个;阳性对照:奈玛特韦(所有植物化学物对接亲和力均弱于奈玛特韦)
3.5 分子动力学模拟
(原文该节内容未在节选中完整呈现)
在模拟的植物化学物中,CID_146102 表现出更有利的 MM-GBSA 结合自由能 −36.36 ± 0.46 kcal/mol,而 CID_415569 为 −30.64 ± 0.49 kcal/mol,且在 500 ns 分子动力学模拟期间具有更有利的动态稳定性特征。其对接分数为 −6.56 kcal/mol,提供了活性位点占据的补充结构证据。奈玛特韦仍然更有利,MM-GBSA 结合自由能为 −46.67 ± 0.52 kcal/mol。
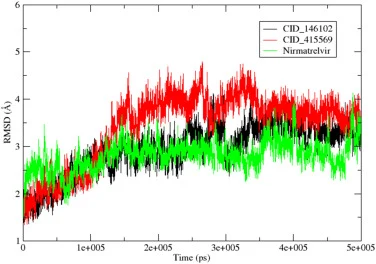
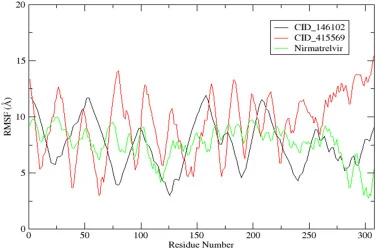
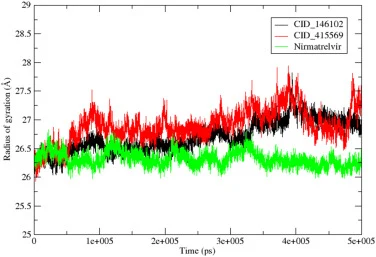
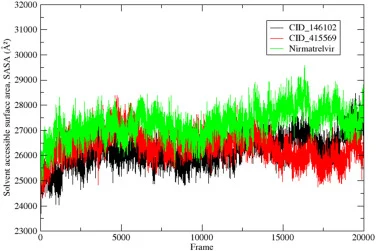
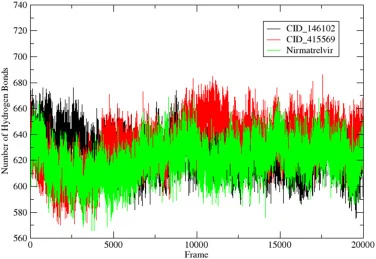
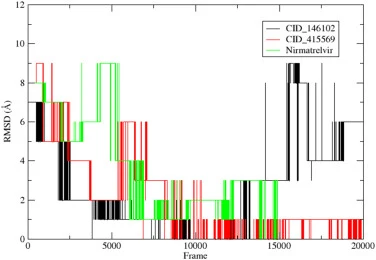
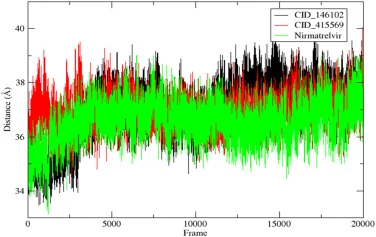
【数据】CID_146102 MM-GBSA 结合自由能:−36.36 ± 0.46 kcal/mol;CID_415569 MM-GBSA 结合自由能:−30.64 ± 0.49 kcal/mol;CID_146102 对接分数:−6.56 kcal/mol;奈玛特韦 MM-GBSA 结合自由能:−46.67 ± 0.52 kcal/mol;模拟时长:500 ns
3.6 密度泛函理论分析
(原文该节内容未在节选中完整呈现)
DFT 分析进一步支持了 CID_146102 的有利电子性质。
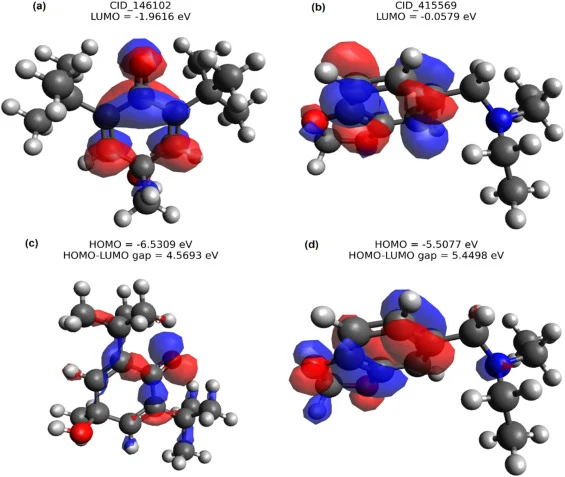
【数据】分析化合物:CID_146102、CID_415569;输出参数:HOMO/LUMO 轨道分布及能隙(eV)
讨论与解读
本研究提出了一个整合计算筛选框架,用于从 X. nilotica 茎皮植物化学物中优先级排序潜在的 SARS-CoV-2 Mpro 抑制骨架。GC-MS 分析和结构整理产生了适用于化学信息学筛选的非冗余化合物库。QSAR 模型在 2,165 个实验表征的 Mpro 抑制剂整理数据集上训练,提供了统计上有意义的排序(外部 R² = Q² = 0.492),但未达到完整外部验证标准;其输出作为探索性过滤器与下游基于结构的证据一起使用。SwissADME 基 ADME 相关和药物相似性分析将库减少到七个具有有利预测物理化学、吸收和代谢相互作用特征的候选物,分子对接表明六个化合物可占据 Mpro 催化口袋,尽管没有一个匹配奈玛特韦的对接性能。在植物化学候选物中,CID_146102 主要因其更有利的 MM-GBSA 结合自由能 −36.36 ± 0.46 kcal/mol(相对于 CID_415569 的 −30.64 ± 0.49 kcal/mol)以及在 500 ns 分子动力学轨迹中相对更稳定的行为而被优先级排序。其对接结果提供了 Mpro 底物结合口袋内占据的补充证据,而非作为最终先导优先级排序的主要基础。奈玛特韦仍然更有利,MM-GBSA 结合自由能为 −46.67 ± 0.52 kcal/mol。总体而言,CID_146102 成为本研究中鉴定出的最有前景的 X. nilotica 来源 Mpro 先导样骨架,但其预测活性仍为计算性的,需要通过酶抑制、细胞毒性和细胞基抗病毒实验确认。
编译者解读:该研究展示了机器学习与经典结构生物学方法整合用于天然产物虚拟筛选的可行路径。方法选择上,作者在 QSAR 模型未满足 Tropsha 标准时仅将其作为探索性排序工具,而非强行用于定量预测,这一处理值得肯定。局限在于:所有结论均基于计算预测,GC-MS 化合物鉴定仅为推定,且候选物活性弱于奈玛特韦。合成生物学视角下,CID_146102 可作为后续酶抑制实验的优先对象,但距离实际抗病毒应用仍有较大距离。
参考来源
期刊:In Silico Research in Biomedicine, 2026
DOI: 10.1016/j.insi.2026.100650
DOI: 10.1016/j.insi.2026.100650