来源:A hybrid CNN–GNN–XGB ensemble framework for prediction of mutation-induced protein–protein binding free-energy changes (ΔΔG) in protein engineering(Computational Biology and Chemistry)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
突变如何改变蛋白–蛋白结合亲和力,是抗体工程与变异解读的核心难题。本研究构建了一个融合XGBoost、卷积神经网络与图神经网络的混合集成框架,在SKEMPI v2.0数据集上训练,采用严格的蛋白留出评估策略。集成模型取得MAE 0.954 kcal/mol、RMSE 1.336 kcal/mol、R² 0.637、Pearson相关系数0.798的表现,配对Wilcoxon符号秩检验显示其绝对预测误差显著低于单独XGBoost基线(p < 0.001)。
研究背景
蛋白–蛋白相互作用几乎支撑着所有生物过程,从信号转导、免疫识别到转录调控与大型分子机器的组装。相互作用的强度在热力学上由结合自由能刻画,而界面处或界面附近哪怕单个氨基酸替换,都可能可测量地改变这一数值——增强、削弱甚至废除复合物形成。因此,预测突变诱导的蛋白–蛋白结合自由能变化(ΔΔG)成为抗体工程、高亲和力结合物设计以及疾病相关变异解读的核心问题。
这一结合量在概念上与折叠(热力学)稳定性变化相关但不同:后者反映单条链天然(折叠)态与去折叠态之间的吉布斯自由能差。由于一个替换可能同时扰动这两种性质,氨基酸身份、侧链化学或界面堆积的改变可能削弱结合亲和力、损害酶活性,或在折叠语境下促进与多种疾病表型相关的错误折叠事件。可靠预测突变诱导的蛋白稳定性与结合亲和力变化,在生物医学研究和工业蛋白质工程中都很重要。
研究方法
1. 数据集准备
我们使用SKEMPI v2.0数据库获取由单点突变引起的蛋白–蛋白结合自由能变化(ΔΔG)的实验测量值。这些测量值被用于构建模型。原始SKEMPI v2.0数据集包含7085条突变记录。经过亲和力提取和突变标准化后,生成了包含5020条突变记录的处理后数据集。突变条目使用PDB标识符进行标准化,并清理了突变注释字段。对处理后数据集的分析显示有3403个唯一的标准化PDB–突变表示。用于模型开发和评估的精选数据集包含5020条突变记录。 curation级联的详细过滤汇总见补充表S1。每条精选条目包含:• 蛋白质数据库标识符(PDB ID);• 野生型和突变型残基(wt, mt);• 突变位置;• 实验测量的ΔΔG(kcal/mol)。
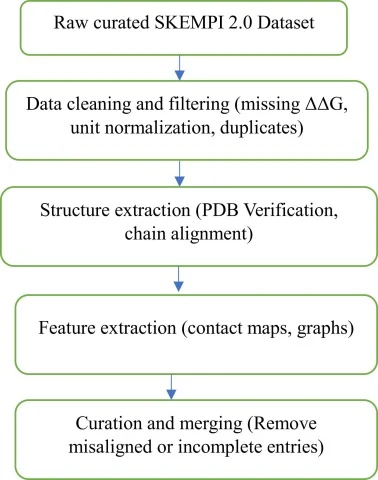
SKEMPI条目对应的蛋白质结构从RCSB蛋白质数据库获取。残基–残基接触图由相应的野生型蛋白质结构生成,用于CNN和GNN处理。未生成突变特异性接触图;相反,突变信息通过突变感知特征描述符纳入,同时保留底层结构拓扑。图1展示了从数据获取到数据整理的示意工作流程。
【数据】数据库:SKEMPI v2.0;原始记录数:7085条;处理后记录数:5020条;唯一标准化PDB–突变表示:3403个;温度:原文未详述;时间:原文未详述
2. 特征工程
构建了两条并行的特征生成流程,以捕获互补的物理化学和结构信号。
(a)用于XGB的基于序列的描述符。FASTA格式的初级氨基酸序列被转换为基于标准物理化学性质的表格表示。对于每个单突变,在以下属性上计算野生型与突变型残基之间的差异:1. 疏水性;2. 净电荷;3. 突变位置;4. 侧链体积;5. 野生型残基类别;6. 突变型残基类别。
对于XGBoost模型,每个突变使用残基身份、突变位置和物理化学性质描述符来表示。这些包括野生型残基、突变型残基、突变位置、疏水性变化、侧链体积变化以及替换相关的电荷变化。额外的上下文特征来自突变位点周围的局部序列环境,包括归一化突变位置和邻近残基的组成。疏水性值基于Kyte–Doolittle标度,而残基电荷和侧链体积使用标准氨基酸性质指数编码。
对于每个PDB结构,使用10 Å距离截断值计算残基–残基Cα–Cα接触图,并存储为NumPy .npy数组以供可重复的下游使用。这些接触图被用作卷积神经网络(CNN)的输入。为确保不同长度蛋白质的输入大小一致,每个接触图被填充或裁剪为固定的128 × 128矩阵,并表示为单通道图像。因此,CNN直接从完整接触图表示中学习结构模式,而非局部残基补丁。
(b)用于GNN的基于图的表示。为图神经网络(GNN)使用了互补的基于图的表示。残基表示为图节点,残基–残基接触表示图连通性。节点特征包括氨基酸身份、突变位点信息和物理化学描述符。图级嵌入使用平均池化生成,并用于ΔΔG预测。数值特征使用Z-score归一化进行标准化。
【数据】接触图距离截断:10 Å;CNN输入尺寸:128 × 128;CNN输入通道:单通道;归一化方法:Z-score;疏水性标度:Kyte–Doolittle;突变属性数:6项;温度:原文未详述;时间:原文未详述
研究结果
8.1 数据集概览与预处理
从原始SKEMPI v2.0数据集中,经过数据过滤后保留了超过120个蛋白质复合物中的3403个唯一单突变。这些突变涵盖了多样的结构折叠、相互作用表面和残基环境。每个突变包括野生型身份、替换残基、位置索引和实验ΔΔG。为避免拆分间的序列或结构泄漏,使用了蛋白留出分区程序。• 训练集:2382个突变(70%);• 验证集:511个突变(15%);• 测试集:510个突变(15%)。每个PDB ID仅使用一次,这确保模型是在新蛋白质上测试,而非记忆同源折叠。许多早期研究使用了随机拆分技术,允许同源或高度相似的序列同时出现在训练和测试分区中。这种训练可能掩盖模型的实际预测能力,并产生人为夸大的性能指标,尤其是相关系数。相反,我们使用蛋白留出拆分技术消除了组间共享的PDB标识符。这防止了结构基序或同源折叠的重叠。该方法提高了模型对真正未见蛋白质的泛化能力。近期的ΔΔG预测研究越来越强调最小化训练集和测试集之间序列和结构冗余的重要性,以获得更真实的模型泛化估计。
【数据】唯一单突变:3403个;蛋白质复合物:>120个;训练集:2382个突变(70%);验证集:511个突变(15%);测试集:510个突变(15%);温度:原文未详述;时间:原文未详述
8.2 模型训练与优化
#### 8.2.1 XGBoost回归(基于序列的基线)
XGBoost(XGB)模型使用肽的物理化学、位置和序列衍生描述符进行训练。这使模型能够捕获局部残基性质和突变的更广泛上下文效应。在留出测试集上,XGB模型取得了强预测性能(R² = 0.634;MAE ≈ 0.961 kcal mol⁻¹;RMSE ≈ 1.342 kcal mol⁻¹,Pearson r = 0.798),大幅优于CNN和GNN模型。
【数据】R²:0.634;MAE:0.961 kcal mol⁻¹;RMSE:1.342 kcal mol⁻¹;Pearson r:0.798;温度:原文未详述;时间:原文未详述
#### 8.2.2 卷积神经网络(基于结构的接触图表示)
CNN模型在来自野生型蛋白质结构的128 × 128残基接触图上训练,以捕获突变位点周围的局部空间关系。在留出测试集上,CNN表现出有限的预测性能(R² = 0.027;RMSE = 2.188 kcal mol⁻¹;MAE = 1.565 kcal mol⁻¹;Pearson r = 0.312),表明全局相关性较弱。然而,它在约84%的案例中正确分类了突变方向,即结合相互作用稳定化与结合相互作用去稳定化突变,表明其对局部结构扰动具有敏感性。
【数据】R²:0.027;RMSE:2.188 kcal mol⁻¹;MAE:1.565 kcal mol⁻¹;Pearson r:0.312;方向分类准确率:约84%;温度:原文未详述;时间:原文未详述
#### 8.2.3 图神经网络(拓扑感知表示)
GNN提供全局结构信息,将蛋白质结构表示为残基级图,其中节点对应氨基酸,边对应空间或基于相互作用的关系。这种表示使模型能够捕获仅靠局部特征无法获得的整个结构上下文和长程依赖关系。在留出测试集上,GNN表现出有限的独立性能(R² = −0.36,MAE = 1.760 kcal mol⁻¹;RMSE = 2.540 kcal mol⁻¹;Pearson r = 0.130)。这表明它在严格的蛋白留出评估协议下未能有效泛化。
【数据】R²:−0.36;MAE:1.760 kcal mol⁻¹;RMSE:2.540 kcal mol⁻¹;Pearson r:0.130;温度:原文未详述;时间:原文未详述
8.3 集成整合提升预测能力
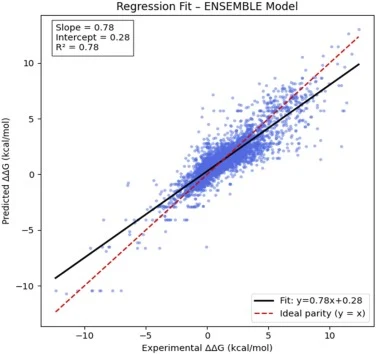
结合XGB(0.45)、CNN(0.35)和GNN(0.2)输出的加权集成产生了用于评估的最终调和集成。混合模型取得MAE = 0.954 kcal/mol、RMSE = 1.336、R² = 0.637和r = 0.798。尽管相对于XGBoost基线,全局相关性指标的改善较为温和,但集成持续降低了绝对预测误差,并受益于基于序列和基于结构的互补表示的整合。预测与实验ΔΔG之间的总体一致性在奇偶图中可视化(图2),各模型的误差比较总结在MAE柱状图中(图7)。
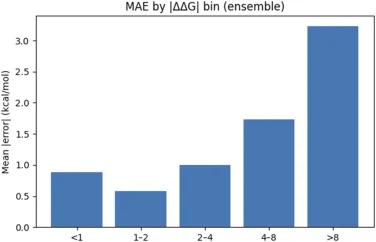
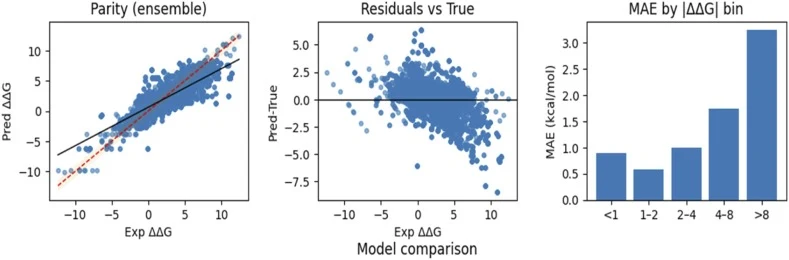
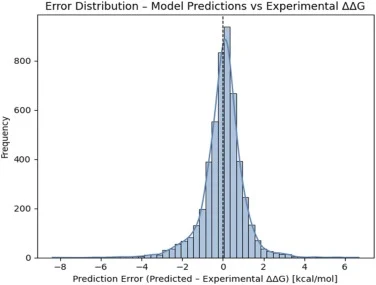
图3和图4展示了误差分布分析,表明大多数集成预测在实验测量ΔΔG值的±1 kcal mol⁻¹范围内。这表明模型在广泛的突变范围内保持准确。直方图显示对称的、零中心的模式。这表明模型不倾向于高估或低估ΔΔG,并保持稳定和一致。约70%的所有突变在±1 kcal mol⁻¹和±2 kcal mol⁻¹之间。尽管全局相关性指标的改善较为温和,配对Wilcoxon符号秩检验显示集成产生的绝对预测误差低于单独XGBoost模型(p < 0.001)。然而,测试集MAE的降低较为温和,从0.961降至0.954 kcal mol⁻¹(约0.007 kcal mol⁻¹)。这些结果表明,结合XGB、CNN和GNN有助于平衡各模型的偏差,并在预测准确性上提供温和但一致的改善。这种行为与计算生物学中的先前工作一致,即整合互补的基于序列和基于结构的学习器的集成策略,相对于任何单一模型,提高了蛋白质稳定性和结合亲和力变化预测的鲁棒性;富含精心设计的物理化学或结构描述符的浅层学习器可以接近更深端到端架构的准确性,特别是在可用训练数据有限时。
【数据】集成权重:XGB 0.45、CNN 0.35、GNN 0.2;MAE:0.954 kcal/mol;RMSE:1.336;R²:0.637;Pearson r:0.798;Wilcoxon检验p值:<0.001;MAE降低量:约0.007 kcal mol⁻¹(0.961→0.954);预测在±1 kcal mol⁻¹内比例:大多数;突变在±1至±2 kcal mol⁻¹间比例:约70%;温度:原文未详述;时间:原文未详述
8.4 基准蛋白质的生物学验证
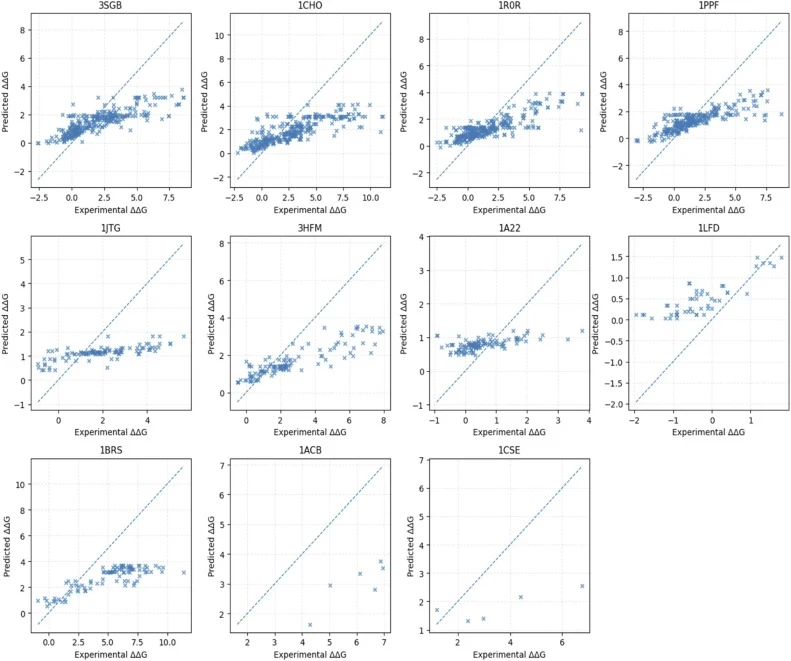
图5展示了留出蛋白质复合物的代表性奇偶图。预测行为在各个系统中有所不同。1ACB和1CSE的预测总体遵循突变效应的实验方向,但相对于y = x奇偶线被压缩,表明系统性地低估了实验ΔΔG幅度。相反,1BRS的预测显示出与奇偶线相对更接近的幅度一致性。因此,基准结果支持这些复合物在方向或符号水平上的一致性,而非统一的强数值一致性。这种逐复合物的变异反映了界面结构、突变分布、结构灵活性以及每个系统中实验ΔΔG值范围的差异。总体而言,该图显示了集成框架在捕获一系列先前未见蛋白质复合物中突变诱导能量趋势的能力。尽管验证分析包括更广泛的留出蛋白质复合物集合,包括抗体–抗原系统、多链界面和多样的蛋白–蛋白相互作用架构,但基准集仍限于SKEMPI v2.0中具有实验解析结构的蛋白质。固有无序相互作用区域、低分辨率结构模型和高度构象异质的复合物未被考察。因此,对此类系统的额外验证将提供对模型鲁棒性和泛化性的更全面评估。
【数据】基准蛋白:1ACB、1CSE、1BRS;1ACB和1CSE:预测方向一致但幅度压缩;1BRS:幅度一致性较好;温度:原文未详述;时间:原文未详述
8.5 模型校准与误差分布
回归分析显示实验与集成预测ΔΔG值之间存在明显的正相关关系。拟合回归线y = 0.78x + 0.28的斜率低于1,表明预测ΔΔG范围相对于理想一致性存在中等程度的压缩(图2和图6)。斜率略低于1表明轻度预测压缩,特别是对于高度去稳定化突变(> ∼4 kcal mol⁻¹)(图7和图8)。然而,集成在整体上保持了显著的秩相关和最小的截距偏差。
【数据】回归方程:y = 0.78x + 0.28;斜率:0.78;截距:0.28;高度去稳定化突变阈值:>∼4 kcal mol⁻¹;温度:原文未详述;时间:原文未详述
讨论与解读
9.1 总体性能与评估策略
结果表明,所提出的混合集成能够以合理的准确性预测突变诱导的ΔΔG值,同时保持计算效率。我们的模型结合了序列衍生的物理化学描述符(XGB)、局部结构感知特征(CNN)和残基连通性信息(GNN),同时保持快速、可解释和计算高效。在严格的蛋白留出基准下,XGB基线捕获了主要的能量趋势,这反映在其高Pearson和Spearman相关性上。这与先前的观察一致,即相对较小的残基级性质集合——包括溶剂暴露、疏水性和侧链体积——在模型适当正则化时,可以解释热力学信号的很大一部分。
本研究的一个主要优势是采用了严格的蛋白留出评估协议。在随机拆分中,来自同一蛋白质复合物的突变可能分布在训练集和测试集中。由于蛋白质内的残基通常共享相似的结构环境、相互作用模式和物理化学约束,模型可以部分受益于训练期间遇到的蛋白质特异性信息,导致对预测性能的过于乐观估计。相反,蛋白留出策略确保与给定蛋白质相关的所有突变被分配到同一分区。
编译者解读
该研究的亮点不在性能突破,而在评估范式的纠偏:严格的蛋白留出拆分揭示了CNN和GNN在未见蛋白质上的真实泛化困境(R²分别为0.027和−0.36),而XGBoost凭借物理化学描述符仍稳居主力。集成带来的MAE改善仅0.007 kcal mol⁻¹,虽统计显著但实用价值有限——这提示当前结构感知模型在数据稀缺的ΔΔG任务中仍难独当一面。对合成生物学而言,该框架的价值在于提供了一种可解释、可降级的工程策略:有结构时用全集成,无结构时退回序列基线,为突变文库的理性缩减提供了务实的计算前置筛选工具。未来若能将蛋白语言模型嵌入表征层,或可突破当前精度瓶颈。
参考来源
期刊:Computational Biology and Chemistry, 2026
DOI: 10.1016/j.compbiolchem.2026.109303
DOI: 10.1016/j.compbiolchem.2026.109303