来源:Enhancing protein expression in humans through codon optimization with transformer and contrastive learning(Molecular Therapy Nucleic Acids)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
mRNA疫苗与基因治疗的成功将密码子优化推向关键位置。传统方法依赖密码子使用频率表等启发式规则,忽视序列上下文,扩展性有限。本研究提出COformer——一种整合卷积神经网络与Transformer的深度学习密码子优化框架,通过对比学习将密码子表征与氨基酸身份对齐。模型以商业工具优化序列为训练目标,在HEK293T细胞中对EMG1、JNK1和CREB1三个基因进行验证,蛋白表达较野生型提升最高达11.3倍,并伴随转录本丰度增加。
研究背景
基因与mRNA治疗的核心难题之一是如何实现最优且安全的转基因表达。传统策略依赖强增强子和启动子驱动高表达,但存在固有局限:强效增强子可能异常激活邻近基因带来基因毒性风险,尤其在整合型病毒载体中;在造血干细胞等临床相关细胞类型中,CMV等常用启动子易被沉默,不得不改用EF1a等更稳定但更弱的启动子,限制了蛋白输出调控的灵活性。密码子优化提供了一种在编码序列层面进行调控的正交策略。历史上,密码子优化主要聚焦于提升翻译效率,反映了密码子使用偏好和tRNA可用性对核糖体装载与延伸动力学的强烈影响。在许多生物场景中,增强翻译效率是有益的,因为高效的核糖体装载增加了翻译产出。
研究方法
数据集构建
从UniProt检索了18,467条经过审阅的人源蛋白序列,以确保注释经过人工校验。对于每个蛋白,使用商业可得的密码子优化工具——ExpOptimizer(NovoPro)、GenSmart(GenScript)和GeneArt(Thermo Fisher Scientific)——在各工具默认的人源表达设置下生成三个同义编码序列变体,除非另有说明。这产生了55,401条优化编码序列(每个蛋白三个变体)。由于密码子优化不存在单一的真实目标序列,这些工具生成的序列被用作代理设计目标,以使COformer接触到多样化的启发式密码子选择策略。所有生成的编码序列均经过验证,确认其阅读框正确且在标准遗传密码下编码预期的氨基酸序列。核苷酸表示(DNA/RNA字母表)在各方法间保持一致处理,以确保下游序列层面分析的可比性。为防止信息泄漏,来自同一蛋白的所有序列(三个工具优化变体)被分配到同一数据集划分(训练集、验证集或测试集),因此评估反映的是对未见蛋白的泛化能力,而非蛋白特异性的记忆。
【数据】蛋白序列数:18,467条;优化工具:ExpOptimizer、GenSmart、GeneArt;每蛋白变体数:3个;总编码序列数:55,401条;数据划分:同一蛋白的所有变体归入同一划分
模型架构与训练策略
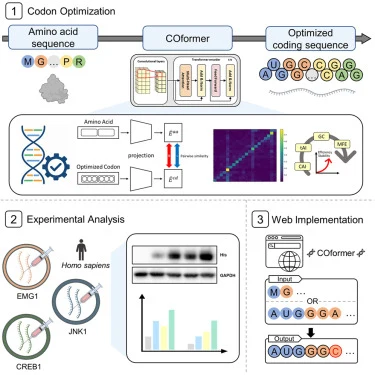
开发了COformer,它将卷积层与Transformer编码器层整合,以学习蛋白编码序列中的短程和长程上下文。从氨基酸输入到优化密码子序列输出的框架概览见图6。
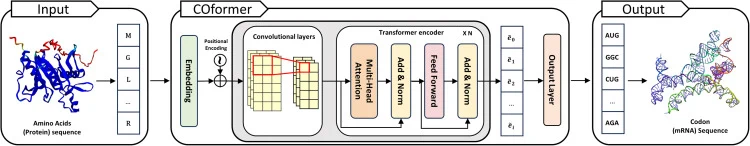
在推理阶段,COformer以氨基酸token序列为输入;密码子token序列仅在训练时用于辅助监督和对比正则化。设 \(x^{aa} = [x_0^{aa}, x_1^{aa}, \ldots, x_{n-1}^{aa}]\) 表示长度为n的氨基酸token序列,其中 \(x_i^{aa}\) 为离散token索引。嵌入层将 \(x^{aa}\) 映射为 \(E_0 \in \mathbb{R}^{n \times d}\),其中d为嵌入维度:
(公式1) \(E_0 = \text{EmbeddingLayer}(x^{aa})\)
为概括局部序列上下文,应用核大小为k、步长为s的一维卷积:
(公式2) \(H = \text{Conv1D}(E_0; W_{conv}, b_{conv})\)
随后接非线性激活和批归一化:
(公式3) \(\tilde{H} = \text{BN}(\sigma(H))\)
使用残差连接以保留原始嵌入信息:
(公式4) \(E_{conv} = \tilde{H} + \text{Proj}(E_0)\)
其中Proj(·)在维度匹配时为恒等映射,维度不匹配时为线性投影。当实现中使用池化时,以保持长度方式应用,或后接相应投影,以维持与残差通路的兼容性。该卷积表示提供了局部上下文化的嵌入,随后由Transformer编码器处理。
局部特征捕获后,\(E_{conv}\) 通过多个Transformer编码器层,每层由多头自注意力模块和逐位置前馈网络组成:
(公式5) \(\tilde{E}^{aa} = \text{Encoders}(E_{conv})\)
最终编码器输出 \(\tilde{E}^{aa}\) 通过逐位置预测头映射为密码子选择logits,softmax生成密码子词表上的逐位置概率分布:
(公式6) \(\hat{y}^{aa} = \text{Softmax}(\text{OutputHead}(\tilde{E}^{aa}))\)
其中OutputHead(·)表示逐位置分类器,将每个上下文化嵌入映射为密码子词表上的logits。解码时,非 synonymous 密码子的logits被掩码,使每个位置的密码子选择被约束为目标氨基酸的同义密码子。为量化相对于在相同条件下训练的Transformer基线的密码子选择集中度,在留出测试集的解码序列上计算了每氨基酸的top-codon比率。较高值表示更强的单一同义密码子集中。
训练COformer所用目标的概览见图7。
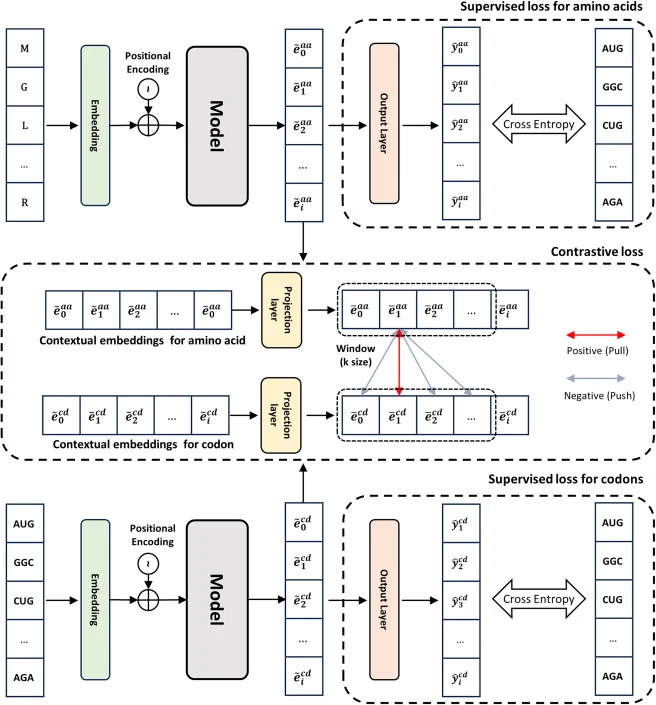
给定氨基酸输入 \(x^{aa}\) 及其对应的密码子token序列 \(x^{cd}\),COformer在流特异性token嵌入后使用共享编码器层计算氨基酸和密码子token流的上下文化表示,得到 \(\tilde{E}^{aa}\) 和 \(\tilde{E}^{cd}\)。这些表示被投影到共享潜在空间:
(公式7) \(z^{aa} = \text{ProjectionLayer}(\tilde{E}^{aa}), \quad z^{cd} = \text{ProjectionLayer}(\tilde{E}^{cd})\)
使用余弦相似度sim(·,·)和温度τ定义InfoNCE风格的对比损失。对于长序列,在长度L=64个token、步长S=32个token的滑动窗口上计算对比项。对于短于L的序列,整条序列作为单个窗口。设 \(z_w^{aa} = z^{aa}[wS : wS+L]\) 和 \(z_w^{cd} = z^{cd}[wS : wS+L]\) 表示限制在第w个窗口的嵌入。在每个窗口内,匹配对为 \((z_{w,i}^{aa}, z_{w,i}^{cd})\),其他位置j≠i的密码子嵌入作为 \(z_{w,i}^{aa}\) 的负样本:
(公式8) \(\mathcal{L}_{NCE}(z_w^{aa}, z_w^{cd}) = -\sum_{i=1}^{L} \log \frac{\exp(\text{sim}(z_{w,i}^{aa}, z_{w,i}^{cd})/\tau)}{\sum_{j=1}^{L} \exp(\text{sim}(z_{w,i}^{aa}, z_{w,j}^{cd})/\tau)}\)
对于长度n≥L的序列,窗口数 \(W = \lfloor(n-L)/S\rfloor + 1\),最终对比损失在各窗口上取平均:
(公式9) \(\mathcal{L}_{con} = \frac{1}{W} \sum_{w=0}^{W-1} \mathcal{L}_{NCE}(z_w^{aa}, z_w^{cd})\)
训练期间,COformer以定义在氨基酸输入上的主监督目标以及密码子token输入上的辅助监督目标进行优化。氨基酸序列被映射为密码子token概率 \(\hat{y}^{aa}\),最小化与目标密码子token序列y的交叉熵:
(公式10) \(\mathcal{L}_{aa} = \text{CrossEntropy}(\hat{y}^{aa}, y)\)
对于辅助监督,密码子token输入通过以下方式映射为 \(\hat{y}^{cd}\):
(公式11) \(\hat{y}^{cd} = \text{Softmax}(\text{OutputHead}(\tilde{E}^{cd})), \quad \mathcal{L}_{cd} = \text{CrossEntropy}(\hat{y}^{cd}, y)\)
交叉熵在密码子token上逐位置计算并在序列位置间取平均。监督损失为:
(公式12) \(\mathcal{L}_{sup} = \mathcal{L}_{aa} + \lambda \mathcal{L}_{cd}\)
其中λ控制辅助密码子token监督项的贡献。总目标结合监督项和对比项:
(公式13) \(\mathcal{L}_{total} = \mathcal{L}_{sup} + \mu \mathcal{L}_{con}\)
其中μ平衡监督损失和对比损失。
【数据】卷积核大小:k;步长:s;嵌入维度:d;对比窗口长度:L=64 tokens;窗口步长:S=32 tokens;温度:τ;辅助监督权重:λ;对比损失权重:μ;原文未详述k、s、d、τ、λ、μ的具体数值
质粒构建
EMG1、JNK1和CREB1的编码序列从NCBI Gene数据库获取。密码子优化编码序列使用NovoPro ExpOptimizer、GenScript GenSmart和COformer设计。随后,使用KOD-Plus-High Fidelity DNA聚合酶按照制造商方案(TOYOBO)扩增基因。野生型和密码子优化编码序列见补充表S1–S3,引物序列见补充表S4–S6(UTR序列见补充表S7)。扩增的基因产物随后亚克隆到哺乳动物表达载体pAcGFP1-N1中。构建体使用Gibson Assembly Master Mix(New England Biolabs)生成,并通过DNA测序验证。所有构建体均含有C端6×His标签。
【数据】基因:EMG1、JNK1、CREB1;来源数据库:NCBI Gene;优化工具:NovoPro ExpOptimizer、GenScript GenSmart、COformer;DNA聚合酶:KOD-Plus-High Fidelity(TOYOBO);载体:pAcGFP1-N1;组装方法:Gibson Assembly Master Mix(NEB);标签:C端6×His
细胞培养与核酸转染
HEK293T细胞维持在DMEM(Gibco)中,补充抗生素和10%胎牛血清(Gibco),在37°C、5% CO₂气氛中培养。将细胞(5×10⁵)接种到6孔板中。次日,将各质粒DNA转染到单层细胞中,操作如下。简言之,将各质粒DNA和P3000试剂在一管中用Opti-MEM培养基共同稀释,同时将Lipofectamine 3000试剂(Invitrogen)在另一管中用Opti-MEM培养基单独稀释。随后将两管内容物轻柔混合并孵育10分钟以形成DNA-Lipofectamine复合物。将复合物直接加入培养液中的细胞,然后细胞在37°C孵育24小时后进行实验。
【数据】细胞系:HEK293T;培养基:DMEM(Gibco);血清:10%胎牛血清(Gibco);抗生素:原文未详述具体种类;温度:37°C;CO₂浓度:5%;细胞接种量:5×10⁵/6孔板;转染试剂:Lipofectamine 3000(Invitrogen)+ P3000;稀释培养基:Opti-MEM;复合物孵育时间:10 min;转染后孵育时间:24 h
Western blot分析
细胞在含p(原文此处截断,以下内容原文未详述)的RIPA缓冲液(Sigma)中裂解。
【数据】裂解缓冲液:RIPA(Sigma);其余参数原文未详述
研究结果
从多样化的同义密码子景观中学习
为将COformer设计与现有实践相关联,首先量化了广泛使用的商业优化器对相同蛋白的同义解决方案的一致程度,然后评估了COformer输出与各平台的对齐情况。由于COformer使用工具优化的编码序列进行训练,聚焦于三个广泛使用的商业密码子优化平台——NovoPro ExpOptimizer、GenScript GenSmart和Thermo Fisher GeneArt——作为参考基线进行比较,并探究这些工具对相同蛋白是否收敛于相似的同义设计。在各工具对之间,核苷酸水平一致性中等偏高,中位值范围为78.5%至86.0%,这与固定氨基酸序列施加的约束一致。相比之下,密码子水平一致性显著较低,各工具对的中位值范围为44.4%至65.5%(图1A),表明这些平台尽管编码相同蛋白,却经常选择不同的同义密码子。GenSmart和GeneArt彼此之间比它们与ExpOptimizer之间更为相似,提示其启发式偏好更为接近。
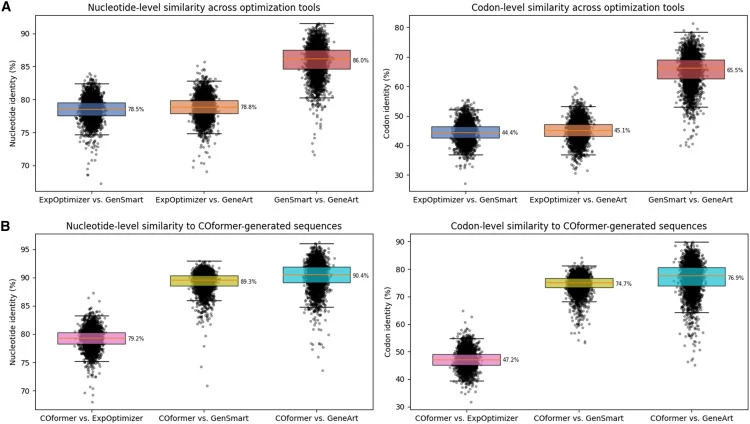
接下来比较了COformer生成的序列与各商业工具在相同留出蛋白上的输出。COformer设计在核苷酸水平上与GeneArt最为相似,中位一致性为90.4%,在密码子水平上与GeneArt和GenSmart的相似度高于与ExpOptimizer的相似度,中位一致性分别为76.9%、74.7%和47.2%(图1B)。这些相似性模式表明,训练目标捕获了不同的、工具依赖的密码子选择策略。同时,COformer生成的同义设计保持在这一异质设计空间内,而非复制单一商业平台的密码子选择。
【数据】核苷酸水平一致性中位值范围:78.5%–86.0%;密码子水平一致性中位值范围:44.4%–65.5%;COformer vs GeneArt核苷酸一致性中位值:90.4%;COformer vs GeneArt密码子一致性中位值:76.9%;COformer vs GenSmart密码子一致性中位值:74.7%;COformer vs ExpOptimizer密码子一致性中位值:47.2%
COformer设计在人源细胞中的实验验证
为评估COformer设计能否提升人源细胞中的蛋白产出,选择了三个功能类别和调控背景各异的人源基因:EMG1、JNK1和CREB1。EMG1是核糖体生物发生和18S rRNA甲基化所必需的,与Bowen-Conradi综合征相关。c-Jun N末端激酶1(JNK1)参与丝裂原活化蛋白激酶(MAPK)应激响应通路,调控凋亡和炎症。CREB1是一个转录因子,参与神经发育、记忆巩固和昼夜节律调控。所选基因表现出相对较低的基线密码子适应特征,使其适合评估COformer能否在不同序列背景下相对于野生型序列和现有商业优化方法改善蛋白表达。为评估对未见靶标的泛化能力,用于实验验证的基因(EMG1、JNK1和CREB1)均未包含在训练数据集中。
在HEK293T细胞中进行了瞬时转染实验,以便在一致递送条件下对同义变体进行受控比较。对于每个基因,设计了四个编码序列变体:野生型序列以及由ExpOptimizer、GenSmart和COformer优化的序列。相应的编码区被合成、克隆到哺乳动物表达载体(pAcGFP1-N1)中,并表达为C端6×His标签蛋白。转染后24小时,使用抗His抗体通过Western blot评估蛋白水平,以GAPDH作为上样对照(图2A)。原始Western blot图像见补充图S1。
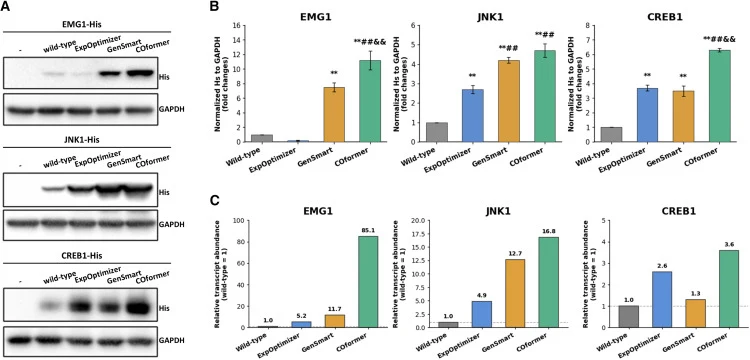
为进一步检查蛋白产出的差异是否与转录本丰度变化相关,在转染后24小时从转染细胞中提取总RNA并进行RNA测序(RNA-seq)分析。使用kallisto定量各同义构建体的转录本丰度,自定义参考包含所有构建体序列以及GAPDH作为内参归一化对照。由于同一基因的同义变体共享广泛的序列相似性,应用了背景校正以减少相关构建体间的交叉比对伪影。
COformer设计在所有三个基因中均产生了高于其他变体的蛋白表达(图2B)。COformer使EMG1表达相对于野生型提高11.3倍,同时也超过了ExpOptimizer和GenSmart优化的设计(分别为28.1倍和1.5倍)。JNK1和CREB1表现出相似模式,相对于野生型分别提高4.8倍和6.3倍,同时相对于ExpOptimizer(分别为1.8倍和1.7倍)和GenSmart(分别为1.1倍和1.8倍)也有额外增益。使用单因素方差分析(one-way ANOVA)继以Tukey多重比较检验的统计分析确认了所测基因中各密码子优化方法间的显著差异。
RNA-seq分析显示,COformer构建体在所有三个基因中相对于野生型也表现出转录本丰度增加(图2C)。特别是,EMG1的COformer构建体相比其他同义变体显示出转录本水平的显著增加,与蛋白水平观察到的强增强一致。这些结果表明,COformer改善蛋白表达可能至少部分与人类细胞中稳态转录本丰度增加有关。值得注意的是,ExpOptimizer优化的EMG1构建体表现出低于野生型的蛋白表达,与JNK1和CREB1中观察到的趋势不同。这一结果表明密码子优化的效果可能具有基因依赖性,且给定优化策略不一定对每个靶序列都能改善蛋白产出。总之,这些实验提供了实验支持,表明COformer生成的同义设计在此处测试的条件下可以增强HEK293T细胞中的转录本丰度和蛋白产出。
【数据】基因:EMG1、JNK1、CREB1;细胞系:HEK293T;转染后检测时间:24 h;EMG1蛋白表达提升:vs野生型11.3倍,vs ExpOptimizer 28.1倍,vs GenSmart 1.5倍;JNK1蛋白表达提升:vs野生型4.8倍,vs ExpOptimizer 1.8倍,vs GenSmart 1.1倍;CREB1蛋白表达提升:vs野生型6.3倍,vs ExpOptimizer 1.7倍,vs GenSmart 1.8倍;统计方法:one-way ANOVA + Tukey多重比较检验;RNA定量工具:kallisto;内参:GAPDH
各优化方法的密码子使用与密码子偏好指标
为进一步检查所选基因的密码子使用模式,分析了相对密码子频率的分布(图3A)。与野生型和商业工具输出相比,COformer设计在EMG1、JNK1和CREB1中显示出相对密码子频率谱的离散度降低,表明同义位置间的密码子频率模式变异性更小。
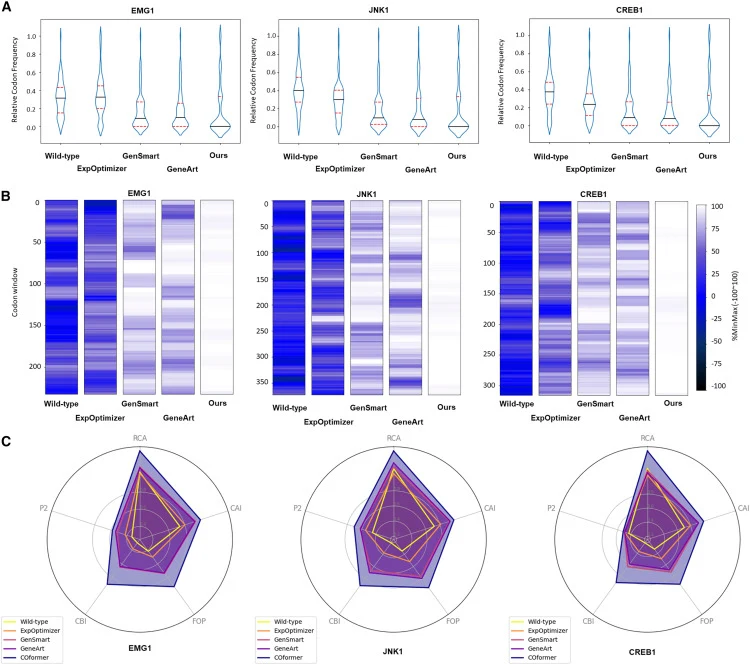
为评估编码序列沿线的局部密码子使用规律性,使用滑动密码子窗口分析了%MinMax谱(图3B)。%MinMax量化宿主参考集中相对于偏好和非偏好同义替代的局部密码子选择。COformer生成的序列在编码区沿线表现出比野生型和商业工具输出更平滑的%MinMax谱。
还使用五个互补指标评估了密码子使用和偏好——RCA、CAI、FOP、CBI和P2(图3C)。这些指标部分相关且广泛反映密码子使用偏好,但捕获密码子偏好的不同方面,包括对宿主偏好密码子的适应(CAI和RCA)、最优密码子的富集(FOP和CBI)以及方向性密码子偏好(P2)。在这些互补指标中,COformer设计始终表现出高于野生型和商业工具输出的值,表明向更符合所选宿主参考的密码子使用模式转变。P2最初在细菌密码子使用分析中引入,作为与偏好的第三位嘧啶使用和翻译选择相关的指数。由于该指数并非专为哺乳动物治疗序列设计而开发,仅将P2用作描述性密码子偏好指标,而非蛋白表达的直接预测因子。
【数据】分析基因:EMG1、JNK1、CREB1;密码子使用指标:RCA、CAI、FOP、CBI、P2;%MinMax分析:滑动密码子窗口;COformer设计趋势:所有五项指标均高于野生型和商业工具输出;原文未详述各指标具体数值
核苷酸组成与预测RNA二级结构特征
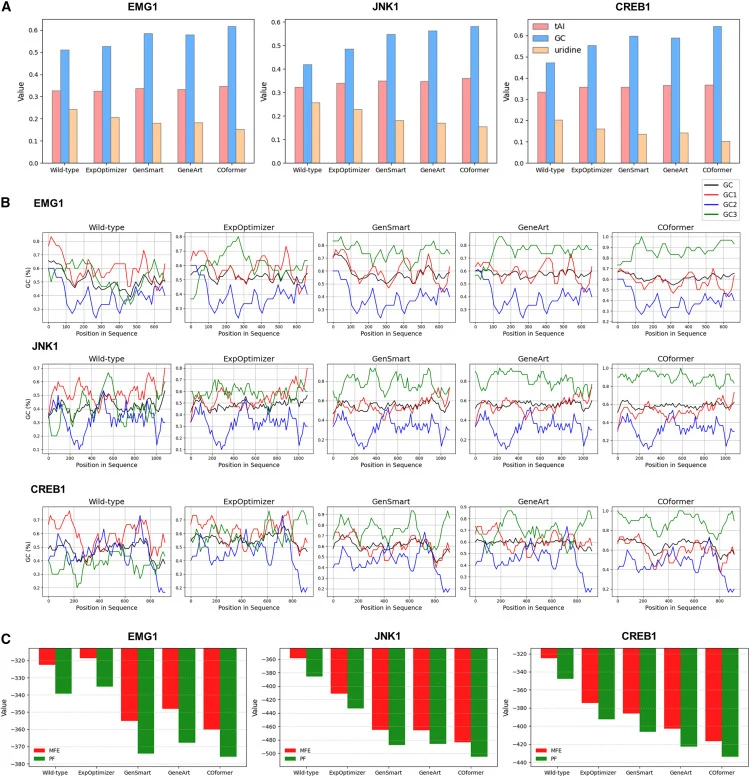
接下来分析了组成(原文此处截断,以下内容原文未详述)。
【数据】原文未详述
COformer与商业工具及基于学习模型的基准比较
(原文此处未提供该部分正文,以下为图表清单对应内容)
【数据】原文未详述
COformer架构与推理流程
(该部分内容已在研究方法中详述,对应图6)
【数据】原文未详述
讨论与解读
密码子优化是增强蛋白表达的关键策略,传统上由密码子频率表或CAI等密码子适应指数指导。这些方法在许多场景中有效,但往往忽视局部密码子依赖性和长程序列上下文的影响,而两者均可影响与表达相关的序列特性。COformer通过整合捕获短程密码子模式的卷积层与建模编码序列长程依赖的Transformer编码器来应对这些局限。对比学习被用于促进氨基酸与同义密码子表征之间超越简单频率编码的一致性。COformer以广泛使用的商业工具优化的人源序列进行训练,学习实践中使用的异质优化策略中反复出现的密码子选择模式,而非假设单一普遍最优的同义解决方案。重要的是,密码子优化不存在每个蛋白经实验定义的单一真实序列。由于大多数氨基酸可由多个同义密码子编码,同义设计空间高度非唯一,密码子偏好取决于宿主、转录本、细胞和应用特异性约束。此外,转录本结构和RNA加工上下文可能影响编码序列特征(原文此处截断)。
编译者解读:COformer将CNN与Transformer结合用于密码子优化,方法选择抓住了传统频率法的核心缺陷——忽视序列上下文。以商业工具输出为训练代理而非单一"最优"标签,这一策略务实且符合同义设计空间非唯一的本质。实验验证覆盖三个功能迥异的基因,EMG1提升11.3倍的数据有说服力。但需注意:验证基因仅三个,且训练数据来自商业工具输出,模型本质上是在学习工具共识而非超越工具;ExpOptimizer在EMG1上反而低于野生型的结果也提示基因依赖性不可忽视。P2等细菌来源指标用于哺乳动物设计的适用性仍需谨慎。
参考来源
期刊:Molecular Therapy Nucleic Acids, 2026
DOI: 10.1016/j.omtn.2026.102991
DOI: 10.1016/j.omtn.2026.102991