来源:Machine learning–based 2D-QSAR modeling and rational design of quinazolinone-derived Schiff bases as potential COX-2 inhibitors(Scientific African)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
炎症是当前药物研发的重要靶点,其中COX-2的选择性抑制被视为抗炎药物设计的最佳策略。喹唑啉酮衍生席夫碱因具有强抗炎活性而备受关注。本研究利用RDKit与scikit-learn在Google Colab平台上构建了36个衍生物的2D-QSAR模型,最优模型基于多元线性回归,统计性能优异(R²=0.90;R²aj=0.88;Q²LOO=0.85),并通过Golbraikh-Tropsha准则验证。基于该模型理性设计了7个新分子,其中M5、M6、M7三个候选物经分子对接、类药性分析和100 ns分子动力学模拟评估,展现出优于塞来昔布的COX-2结合亲和力与复合物稳定性。
研究背景
炎症是免疫系统的基本机制,能够清除有害物质并修复受损组织。正常情况下,当炎症刺激消失后炎症即停止,构成对身体有益的防御系统。抑制炎症关键酶(包括COX-1、COX-2和5-LOX)的抗炎化合物负责前列腺素和白三烯的产生。COX-1维持正常生理功能,而COX-2在炎症过程中被强烈激活,在炎症反应中发挥核心作用。5-LOX也通过合成白三烯参与慢性炎症。对于抗炎药物设计而言,选择性COX-2抑制是最佳策略,这为本研究聚焦COX-2提供了依据。
炎症过程通常采用甾体或非甾体治疗。然而,席夫碱因其药理潜力而显示出作为有前景替代方案的价值,值得进一步研究。这类化合物表现出广泛的生物活性,如抗炎、抗病毒、抗真菌和抗菌作用。喹唑啉酮衍生席夫碱因其强抗炎效果而引起广泛关注。寻找新化合物通常涉及定量构效关系(QSAR)等组合方法。QSAR是一种广泛使用的方法……
研究方法
数据收集与处理
以2D方式使用ChemDraw软件构建了36个喹唑啉酮衍生席夫碱分子系列。随后将表示为IC₅₀的抑制活性值转换为pIC₅₀(表1)。
【数据】分子数:36个;活性指标:IC₅₀转换为pIC₅₀;软件:ChemDraw
分子描述符计算
登录Google Colab平台(https://colab.research.google.com)并创建新notebook后,安装RDKit库,然后导入数据集。随后使用表2所示命令计算各类分子描述符。这些描述符能够量化所研究分子的结构和理化性质。使用Pandas库创建和管理数据表,并以Excel格式导出结果。使用RDKit库初步计算了218个分子描述符,涵盖拓扑、几何、电子和理化性质。使用Pandas库(https://pandas.pydata.org)移除不提供信息的描述符,如空值、常数或近常数描述符。经过此预处理后,保留102个相关描述符用于构建QSAR模型。
【数据】初始描述符数:218个;保留描述符数:102个;工具:RDKit、Pandas;平台:Google Colab
描述符自动筛选
在常用于识别和消除冗余描述符的方法中,Pearson相关分析是QSAR建模中有效且广泛采用的方法。然而,当描述符数量较多时,该分析变得更为复杂,手动选择耗时,因此有必要使用自动化程序。为优化描述符筛选过程,开发了一个Python脚本并在Google Colab平台上运行,使用Pandas(https://pandas.pydata.org)和Scikit-learn(https://scikit-learn.org/stable)库。该脚本随机探索超过20,000种描述符组合,并识别满足以下性能标准的最优组合:R² ≥ 0.85、R²aj ≥ 0.80和Q²LOO ≥ 0.80。这种自动化方法使得从同一组分子数据生成多个统计上有效且可比较的QSAR模型成为可能(表3)。
【数据】探索组合数:>20,000;筛选标准:R²≥0.85、R²aj≥0.80、Q²LOO≥0.80;工具:Pandas、Scikit-learn
QSAR建模数据集划分
使用scikit-learn的train_test_split函数将数据集划分为80%训练集(28个分子)和20%测试集(8个分子)(表4)。该策略确保训练时模型学习稳健,并对其预测性能进行可靠评估。两个集合之间保持活性值分布一致,以限制统计偏差。此外,测试了四个random_state值(50、100、150、200)以评估所生成模型的稳定性和可重复性。
【数据】训练集:28个分子(80%);测试集:8个分子(20%);random_state值:50、100、150、200;划分工具:train_test_split
多元线性回归(MLR)
MLR模型使用Scikit-learn库(https://scikit-learn.org/stable)、Numpy(https://numpy.org)开发。针对四种组合(表3)计算了主要统计参数,如决定系数(R²)、调整决定系数(R²aj)、交叉验证系数(Q²LOO)和测试决定系数(R²Test)。这些参数使用Scikit-learn库中的LinearRegression、r2_score、mean_squared_error和LeaveOneOut子模块计算(表5)。
【数据】统计参数:R²、R²aj、Q²LOO、R²Test;工具:LinearRegression、r2_score、mean_squared_error、LeaveOneOut
Y随机化检验
对训练集应用Y随机化检验,以评估QSAR模型的稳健性并排除任何虚假相关性。使用NumPy库对pIC₅₀值进行随机打乱,迭代1000次。每次迭代使用pandas和scikit-learn库计算统计参数R²和Q²Rand(表6)。该检验应用于先前选择的四组描述符组合(表3),确认模型性能并非随机数据拟合的结果。
【数据】迭代次数:1000次;随机化对象:pIC₅₀值;计算参数:R²、Q²Rand;工具:NumPy、pandas、scikit-learn
2D-QSAR模型验证
针对所选的四种描述符组合(表3),评估了基于多元线性回归(MLR)的QSAR模型的稳健性。使用调整R²(R²aj)和Q²LOO参数对训练集进行内部验证,以评估模型稳定性并防止过拟合。使用系数(R²Test)对测试集进行外部验证,以估计模型对未包含在学习阶段的化合物的预测能力。此外,应用Golbraikh和Tropsha准则全面评估QSAR模型的稳健性和预测可靠性,确保其既不过拟合也非源于随机相关性,并符合统计有效性的基本原则。
【数据】内部验证参数:R²aj、Q²LOO;外部验证参数:R²Test;验证准则:Golbraikh和Tropsha
适用域
确定MLR模型的适用域(AD)以确保对新分子预测的可靠性。模型使用Scikit-learn和Numpy库开发,然后应用于所选的四种描述符组合(表3)。临界杠杆值(h)根据以下公式定义:h = 3(p+1)/n,其中p代表描述符数量,n代表训练集中的分子数。每个分子的杠杆值(hᵢ)根据以下表达式计算:hi = xi(XTX)⁻¹xiᵀ,其中xi是分子i的描述符向量,X是训练集的描述符矩阵。使用标准化残差和杠杆值构建Williams图,从而识别模型适用域之外的分子。
【数据】临界杠杆公式:h*=3(p+1)/n;杠杆公式:hi=xi(XTX)⁻¹xiᵀ;工具:Scikit-learn、Numpy;可视化:Williams图
新分子的理性设计
根据整体统计性能和分子对适用域的符合情况,从所研究的四种组合中选择最佳QSAR模型。选择分子31(表1)作为参考化合物。随后对其骨架进行理性结构修饰,同时保留主要药效团。这些修饰使用ChemDraw软件手动完成。然后使用RDKit计算新设计实体的分子描述符,并从所选QSAR模型预测其抗炎活性。选择七个预测pIC₅₀值高于起始分子的新分子用于进一步的分子对接和分子动力学研究。
【数据】参考化合物:分子31;设计新分子数:7个;描述符计算工具:RDKit;结构修饰工具:ChemDraw
分子对接
配体准备
使用Schrödinger Maestro软件11.5版本中集成的LigPrep工具准备六个设计分子用于分子对接计算。准备过程使用OPLS3力场,生成对应于pH 7.0和2.0的离子化状态。每个配体允许最多32个立体异构体以考虑构象灵活性。使用相同方法,将塞来昔布作为参考化合物进行准备。其结构从PubChem数据库下载。塞来昔布是一种广泛使用的非甾体抗炎药(NSAID),也是1998年12月被美国食品药品监督管理局(FDA)批准用于口服的第一个选择性环氧合酶-2(COX-2)抑制剂。
【数据】软件:Schrödinger Maestro v11.5、LigPrep;力场:OPLS3;pH值:7.0和2.0;最大立体异构体数:32个/配体;参考药物:塞来昔布;来源:PubChem
蛋白质准备
从蛋白质数据库下载了鼠源环氧合酶-2(COX-2)的三维晶体结构(PDB ID: 3LN1),分辨率为2.40 Å。使用Schrödinger Maestro v11.5软件中的Protein Preparation Wizard工具准备蛋白质。该步骤包括去除水分子、向重原子添加氢原子以及适当分配质子化状态。随后使用OPLS3力场进行能量最小化,重原子的最大RMSD值为0.30 Å。
【数据】PDB ID:3LN1;分辨率:2.40 Å;力场:OPLS3;重原子最大RMSD:0.30 Å;软件:Protein Preparation Wizard
网格盒坐标
网格盒定义如下坐标:x = 31.72;y = −22.00……
【数据】网格盒坐标:x=31.72;y=−22.00(原文此处截断,其余坐标原文未详述)
研究结果
多元线性回归(MLR)
不同随机状态下MLR模型的统计评估
为评估MLR模型的稳定性和稳健性,通过修改random state值进行了多项测试。每个模型获得的主要统计参数列于表7。
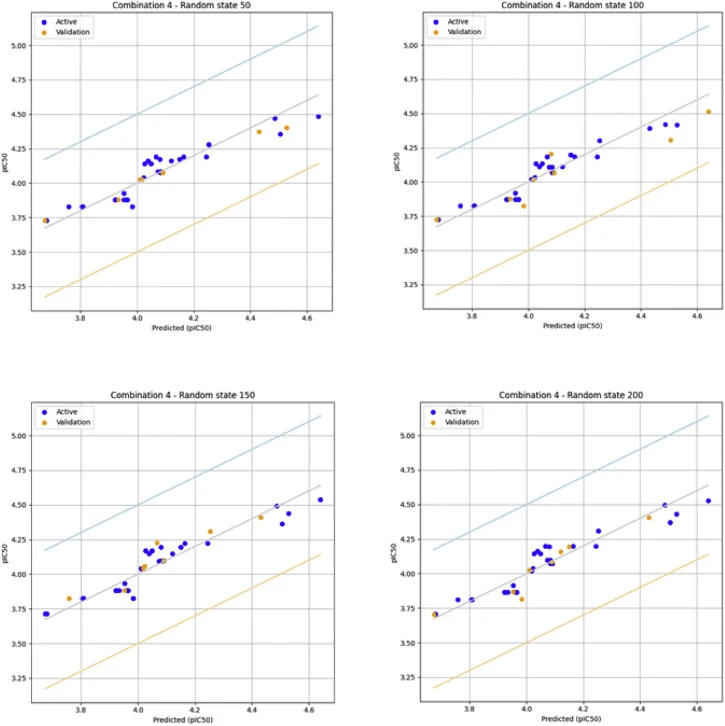
表7和图1的结果显示,实验与预测pIC₅₀值之间存在强相关性,所有研究的组合决定系数R²均大于0.82。调整R²值均大于0.80,证实了模型无论描述符组合和random state值如何均具有可靠性和稳健性。此外,高Fisher's F检验值伴随p值<0.0001,证明了所开发模型的统计显著性。在评估的四种组合中,第四种组合表现最佳,在Random state 100下R²为0.905,误差较低(RMSE = 0.066)。总体而言,这些结果表明不同组合中选择的描述符对所研究的抗炎活性建模有有效贡献。
【数据】R²>0.82;R²aj>0.80;最佳组合:第四种;R²=0.905;RMSE=0.066;Random state=100;p<0.0001
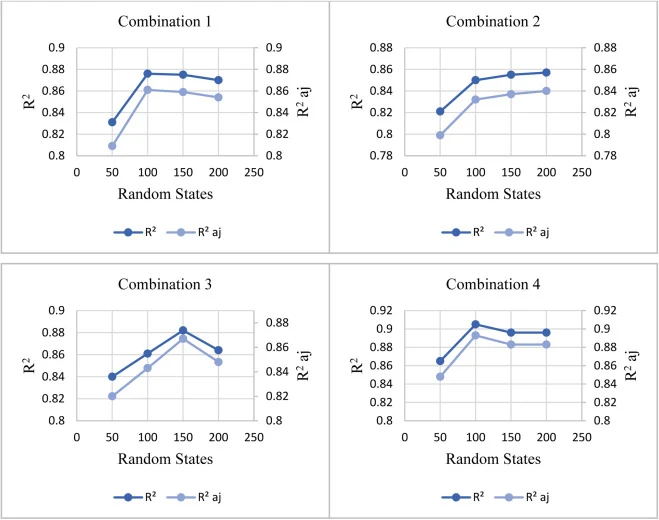
每种组合和每个Random State获得的QSAR方程(表8)揭示描述符对预测pIC₅₀活性有正向或负向影响。特别是HAl和NO₂等描述符对活性增加有正向贡献,表明它们在抗炎效果中的有利作用,而QED和HKA描述符则有负向影响。不同random state之间观察到的回归系数一致性增强了所生成QSAR模型的稳定性、稳健性和可靠性。
【数据】正向贡献描述符:HAl、NO₂;负向贡献描述符:QED、HKA
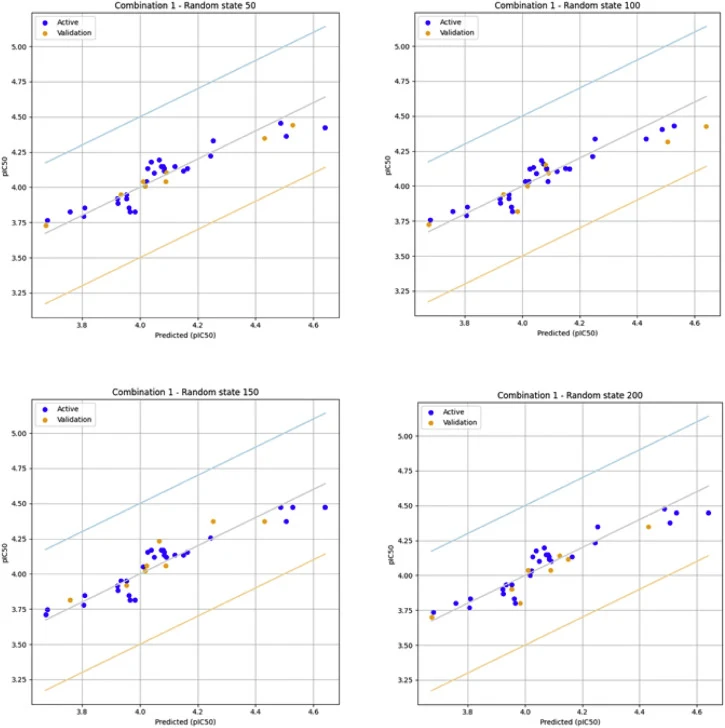
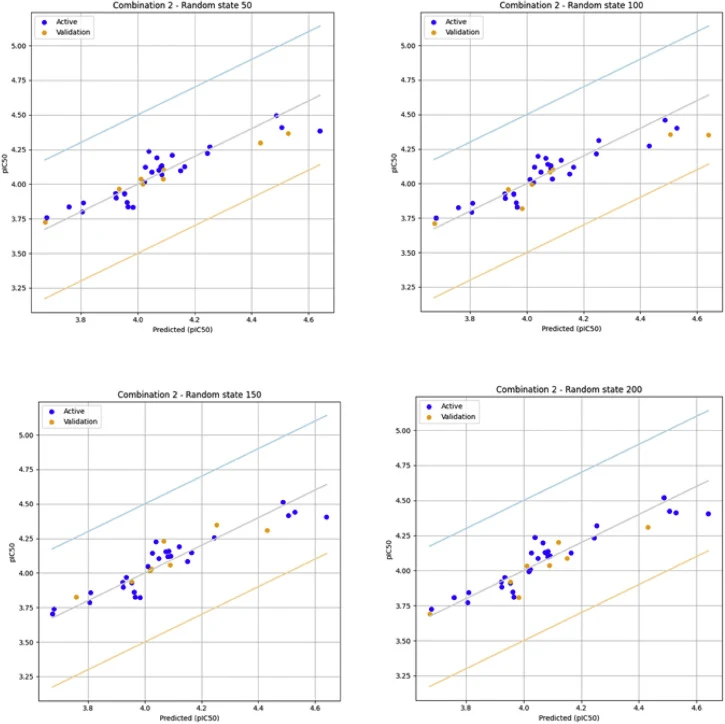
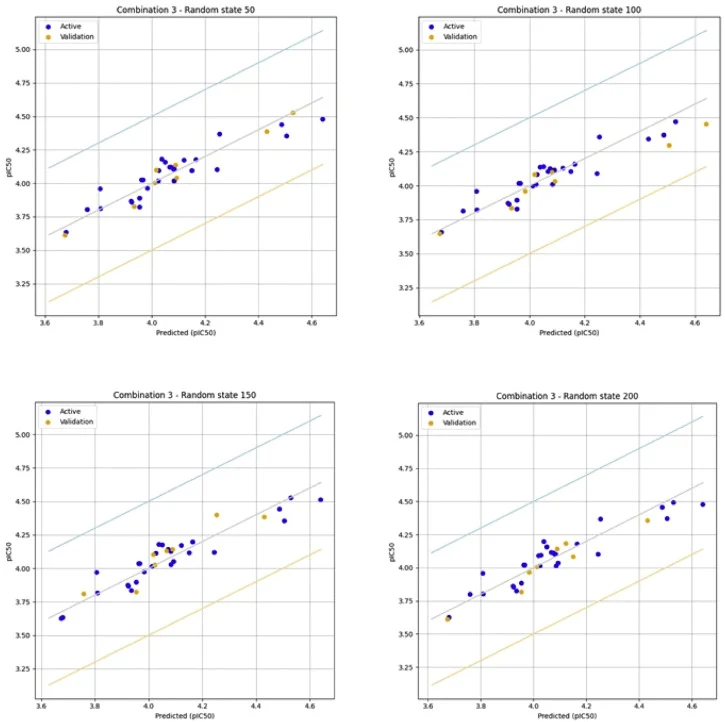
图2、3、4和5展示了使用不同random state值(50、100、150和200)时四种组合的观测实验活性与预测活性之间的相关性。所有图形均显示观测pIC50值围绕回归线均匀分布,表明实验数据与预测值之间良好吻合。这些观察结果证实了所开发QSAR模型的整体性能和可靠性。总体而言,对于所研究的四种组合,图2、3、4和5中呈现的图形显示观测与预测pIC₅₀值之间良好的线性相关性,表明模型能够可靠地重现所研究化合物的生物活性。模型在面对random state变化时的稳定性归因于数据点围绕回归线的分散。这些结果表明所开发的QSAR模型具有良好的统计可靠性和稳健的预测能力。
【数据】random state值:50、100、150、200;观测与预测pIC₅₀线性相关
使用方差膨胀因子(VIF)评估模型描述符之间的多重共线性。根据普遍接受的标准,VIF大于10表示高多重共线性,使模型方程不可靠,而VIF在1到5之间对应于解释变量之间可接受的相关水平,VIF等于1表示完全不存在多重共线性。对于所有描述符组合和不同random state值,VIF值均保持在5以下,表明所选描述符之间不存在显著多重共线性。这些结果证实了所开发MLR模型的稳健性,并表明所选描述符对预测pIC₅₀活性发挥稳定且独立的影响(表9)。
【数据】VIF阈值:>10为高多重共线性;1-5为可接受;=1为无共线性;本研究中VIF<5
标准化残差研究评估MLR模型质量
使用Scikit-learn库计算标准化残差以评估MLR模型的质量和可靠性。根据普遍接受的标准,标准化残差应落在[−3; +3]范围内,任何超出此范围的值被视为异常值。对于所有开发的MLR模型,标准化残差分析显示最大值范围为1.68至2.64,最小值范围为−2.13至−1.17。因此所有残差均保持在临界阈值内并围绕零居中,表明不存在显著异常值。这些观察结果表明MLR模型是稳健的,没有系统偏差影响pIC₅₀活性预测,从而证实了所开发模型的整体质量(表10)。
【数据】标准化残差范围:[−3; +3];最大值范围:1.68至2.64;最小值范围:−2.13至−1.17
Y随机化检验
为验证QSAR模型的稳健性,我们使用了基于pIC50值重复随机化的Y随机化检验。该检验应用于四种不同组合,每种组合有四个random state值(50、100、150和200)。R²和Q2CV的低值(表11)表明在因变量值(pIC50)随机排列后不存在相关性。cR²p系数在0.75至0.82之间变化,大于0.5,证实随机模型没有预测能力。所有这些结果表明所开发的QSAR模型并非偶然产生。
【数据】random state值:50、100、150、200;R²和Q2CV:低值;cR²p:0.75-0.82(>0.5)
2D-QSAR模型验证
每种组合在不同random state下生成的MLR模型结果与Golbraikh和Tropsha准则进行了良好比较。该验证确保我们的MLR模型能够准确预测新化合物的活性,使其可用于分子设计。使用不同random state值的四种描述符组合获得的结果表明,所有MLR模型均符合Golbraikh和Tropsha准则。R²(0.82–0.91)和Q²LOO(0.75–0.86)的高值反映了优异的拟合度和内部验证的高稳健性。此外,外部验证显示高预测能力(R²Test = 0.80–0.96)。MSE、Fisher's F和cR²p的良好值证实模型具有统计显著性且非随机产生。总体而言,这些结果表明所开发的模型稳定、稳健、具有预测性且非偶然产生,使其对预测新分子具有可靠性(表12)。
【数据】R²:0.82–0.91;Q²LOO:0.75–0.86;R²Test:0.80–0.96
本研究获得的性能与关于抗炎活性的其他2D QSAR研究报告相当,甚至更优。例如,一项基于相对较大数据集(N = 124)的研究报告了良好的内部验证(R² = 0.88),但外部预测能力有限,R²Test = 0.59。在另一项研究中,模型具有R²Test = 0.84和R² = 0.70。然而,Q²LOO值为0.40表明内部稳健性较低,提示异常值可能影响新分子的预测。
【数据】对比研究1:N=124;R²=0.88;R²Test=0.59;对比研究2:R²Test=0.84;R²=0.70;Q²LOO=0.40
适用域
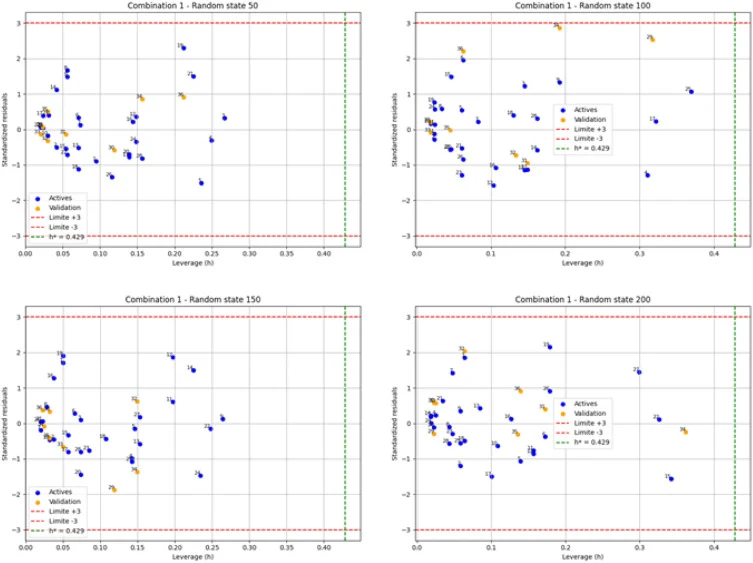
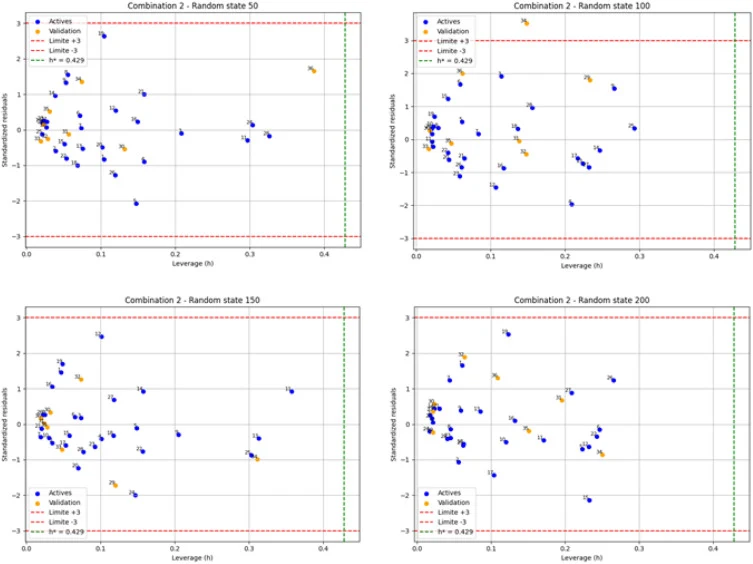
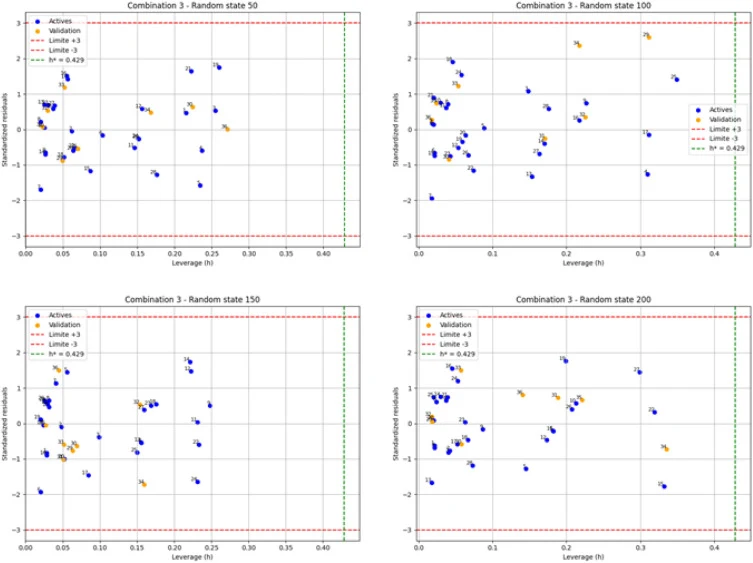
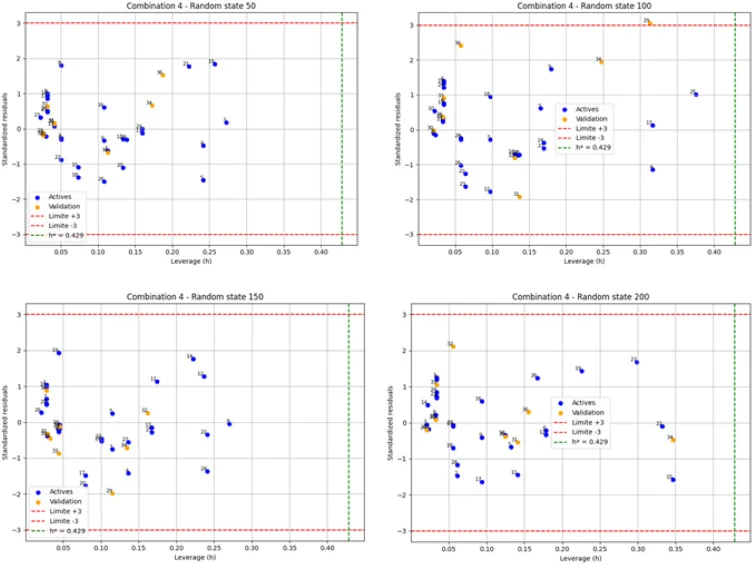
适用域(AD)识别模型预测可靠的空间,同时确保对模型拟合优度、稳健性和预测能力进行相关评估。所有组合和random state的极限杠杆值h*为0.429。Williams图(图6–9)用于检查四组描述符的适用域。训练集和测试集中的大多数分子在标准残差限(±3)内。仅组合2(Random State = 100)中的分子34和组合4(Random State = 100)中的分子29落在范围外,显示异常行为。总体而言,模型保持在定义的适用域内,这使得无论描述符集或random state如何,其预测都是可靠的。
【数据】极限杠杆值h*:0.429;标准残差限:±3;域外分子:组合2中分子34(RS=100)、组合4中分子29(RS=100)
新分子的理性设计
对于理性设计,我们选择分子31作为先导化合物,因为该分子具有较高的实验pIC50值(表1)。设计策略由从组合4 random state 150开发的QSAR模型指导。选择该模型是因为其良好的统计性能(表12)以及分子符合模型的适用域(图9)。对分子31的骨架进行了理性结构修饰,包括……
【数据】先导化合物:分子31;指导模型:组合4、random state 150;设计新分子数:7个
讨论与解读
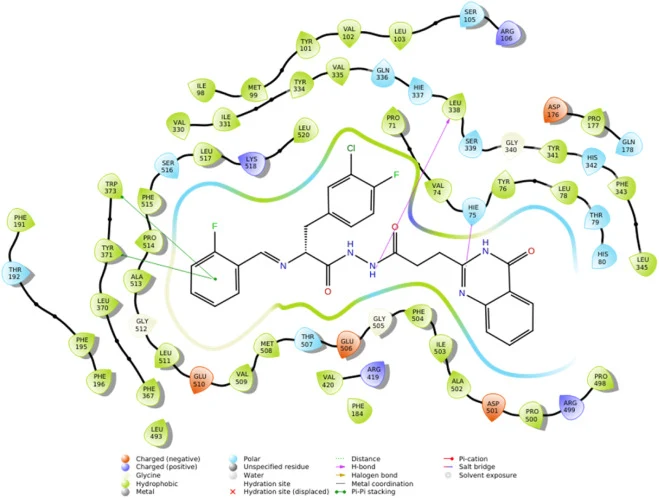
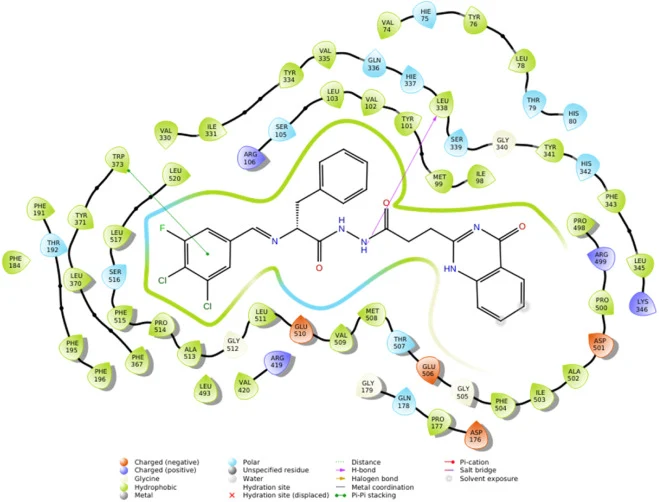
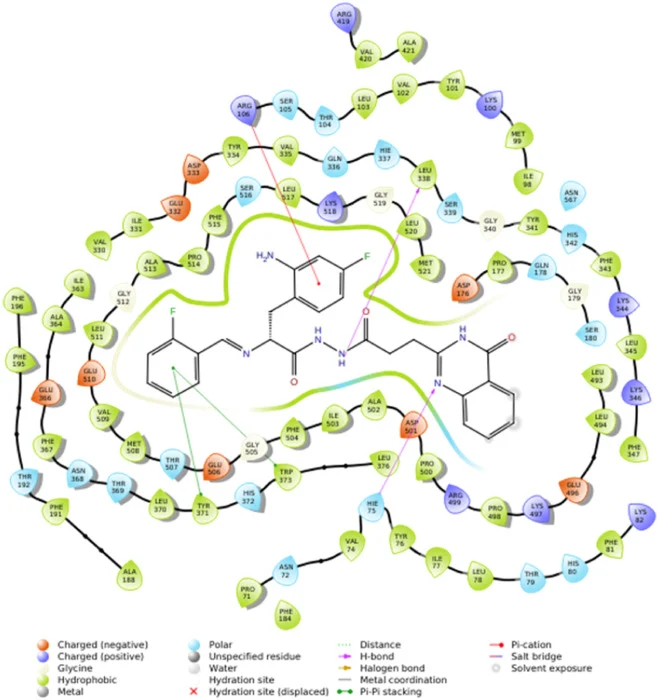
本研究开发并验证了一个稳健且具有预测性的2D QSAR模型,用于评估一系列喹唑啉酮衍生席夫碱的抗炎活性。借助Google Colab、RDKit和Scikit-learn等计算机工具,成功构建了可靠模型,并附带定义明确的适用域,确保了预测的有效性。基于最佳QSAR模型(组合4,random state = 150),理性设计识别出七个预测pIC₅₀值高于参考分子(分子31)的新分子。通过分子对接对环氧合酶-2(PDB ID: 3LN1)的计算机评估显示,三个最有前景的化合物(M5、M6和M7)具有高于参考药物(塞来昔布)的结合亲和力。进行了选择性研究以验证设计分子不存在胃肠道和心血管风险。为此,对环氧合酶-1(PDB ID: 3KK6)进行了分子对接。M5、M6和M7三个分子的结果显示选择性指数在1.01至2.54 kcal/mol之间,高于参考药物。对M5、M6和M7三个分子进行的100 ns分子动力学模拟证实了所形成复合物的稳定性,特别是分子M5在COX-2活性位点内表现出异常稳定的动力学行为。药理学分析……
编译者解读
该研究展示了机器学习驱动的QSAR建模在合成生物学导向药物设计中的典型应用路径:以RDKit自动计算描述符、以scikit-learn构建MLR模型、以适用域约束预测可靠性。其亮点在于将统计验证(Golbraikh-Tropsha准则、Y随机化)与结构生物学验证(分子对接、100 ns MD)串联,形成从数据到分子的闭环。局限在于训练集仅36个分子,模型外推能力受适用域严格限制;MLR线性假设可能遗漏非线性构效关系。未来可引入深度学习描述符或主动学习策略扩展化学空间。
参考来源
期刊:Scientific African, 2026
DOI: 10.1016/j.sciaf.2026.e03552
DOI: 10.1016/j.sciaf.2026.e03552