来源:Comparative transcriptome analysis elucidates species-specific expression patterns of steroid biosynthesis genes in four Physalis species(Scientia Horticulturae)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
酸浆属植物富含以酸浆苦素为代表的甾体化合物,具有显著的药理潜力,但其生物合成的遗传基础与种间差异长期不明。本研究对苦蘵(PA)、小酸浆(PM)、墨西哥酸浆(PP)和酸浆(PAF)四个物种进行比较转录组分析,结合LC-MS/MS定量与de novo组装,揭示了MVA/MEP上游通路及下游类固醇合成通路的转录分化格局。研究发现PM在多数MVA/MEP基因及CYP51G1、DWF1、DWF5、SMT1等关键酶上表达占优,并鉴定出31个细胞色素P450和4个3β-HSD,为高值植物甾体的代谢工程提供了遗传资源。
研究背景
酸浆属隶属茄科,约含90个物种,因广泛的治疗用途和独特的植物化学成分而成为民族药理学与当代药物开发的研究焦点。苦蘵、酸浆、小酸浆、墨西哥酸浆和秘鲁酸浆等多个物种长期在亚洲、非洲和美洲的传统医学中用于治疗炎症、免疫相关疾病和癌症,其抗炎、免疫调节和抗肿瘤效果正逐步获得科学证据支持。这些药理活性主要归因于甾体内酯(尤以酸浆苦素为代表)、黄酮、生物碱和睡茄内酯等生物活性化合物。酸浆苦素具有高度氧化的麦角甾烷骨架,可通过触发凋亡和干扰NF-κB信号通路对肿瘤细胞表现出强细胞毒性。然而,该类化合物生物合成的遗传基础及种间变异仍知之甚少。本研究通过四种酸浆属植物的比较转录组分析,旨在勾勒类固醇生物合成基因的表达图谱。
研究方法
2.1 植物材料与RNA提取
新鲜叶片样品于2024年9月采集自中国杭州师范大学温室设施(北纬30°17′27.77″,东经120°0′39.47″),包括苦蘵(PA)、小酸浆(PM)、墨西哥酸浆(PP)和酸浆(PAF)(图1a、b)。植株在采样前已生长六个月。生长条件维持在25 ± 2°C,12小时光/暗循环,相对湿度60–70%。每个物种从六株均一植株上选取茎中部完全展开的健康叶片,立即在液氮中冷冻用于转录组和代谢组分析。所选植株无病虫害及可见形态缺陷。总RNA使用Trizol试剂(Invitrogen,CA,USA)按制造商方案分离。样品用DNase I(Thermo Fisher Scientific,MA,USA)处理以去除潜在DNA污染。RNA完整性通过1.2%琼脂糖凝胶电泳评估。数量和纯度使用Bioanalyzer 2100系统配合RNA 1000 Nano LabChip Kit(Agilent,CA,USA)分析。所有样品的RNA完整性数值(RIN)均大于7.0。
【数据】物种:PA、PM、PP、PAF;采样时间:2024年9月;生长温度:25 ± 2°C;光暗周期:12h/12h;相对湿度:60–70%;植株生长时长:6个月;每物种株数:6株;RNA完整性:RIN > 7.0
2.2 代谢物提取与测定
代谢组提取时,准确称取0.1 g冻干粉末(使用Labconco冻干机在-50°C、0.1 mbar条件下冻干48 h)于2 mL离心管中。粉末与1 mL 100%甲醇混合,随后在冰浴中以40 kHz频率超声处理30 min。超声提取在低温条件下进行以防止热不稳定代谢物降解。在10,000 r/min离心5 min后,收集上清液并通过0.22 μm注射器滤膜过滤。随后,取1 μL滤液转移至自动进样瓶中进行代谢物检测。LC-MS分析在UHPLC系统(Agilent 1260 Infinity II)上联用三重四极杆质谱仪进行。分离在Agilent Eclipse Plus C18柱(2.1 × 100 mm,1.8 μm)上于35°C完成,使用0.1%甲酸水溶液(A)和乙腈(B)作为流动相,流速0.30 mL/min。质谱仪(TSQ Vantage,AB/SCIEX)以ESI源正离子模式运行。检测采用多反应监测(MRM)模式。源参数设置如下:气流量7 L/min;气温度300°C;雾化器15 psi;毛细管电压4000 V;鞘气温度300°C;鞘气流量11 L/min;喷嘴电压1500 V。对于酸浆苦素F(图1c),监测 transitions 为 m/z 525.2 → 497.2,去簇电压90 V,碰撞能量9 V。
【数据】冻干粉末:0.1 g;冻干条件:-50°C、0.1 mbar、48 h;甲醇:1 mL、100%;超声频率:40 kHz;超声时间:30 min;离心:10,000 r/min、5 min;滤膜:0.22 μm;进样量:1 μL;色谱柱温度:35°C;流速:0.30 mL/min;气流量:7 L/min;气温度:300°C;雾化器:15 psi;毛细管电压:4000 V;鞘气温度:300°C;鞘气流量:11 L/min;喷嘴电压:1500 V;酸浆苦素F transitions:m/z 525.2 → 497.2;去簇电压:90 V;碰撞能量:9 V
2.3 文库制备与测序
每个样品约使用5 μg RNA进行cDNA文库制备,设三个生物学重复。使用Oligo(dT)磁珠进行mRNA富集,分离的mRNA随机片段化。cDNA文库通过mRNASeq样品制备试剂盒(Illumina,San Diego,USA)逆转录生成。在Illumina Hiseq 4000(LC Sciences,USA)上进行双端测序,产生150 bp双端读长。
【数据】RNA用量:约5 μg/样品;生物学重复:3个;测序平台:Illumina Hiseq 4000;读长:150 bp双端
2.4 质量检查、de novo组装与功能注释
原始测序数据用Cutadapt(v1.18)(Martin,2011)和内部Perl脚本处理,去除接头污染读长、低质量碱基(Phred score < 20)和模糊序列。使用FastQC(v0.11.9)进行质量控制,评估Q20/Q30分数和GC含量分布。De novo转录组组装使用Trinity(v2.4.0)(Grabherr et al.,2011)进行,采用层次聚类(≥80%序列同一性)。每个簇中最长的isoform被指定为代表unigene。所有测序数据已存入NCBI Sequence Read Archive(BioProject:PRJNA1369639)。功能注释针对五个数据库进行:NCBI非冗余蛋白(Nr)、Gene Ontology(GO)、Swiss-Prot、KEGG Orthology和eggNOG(version 5.0),使用E-value截止值1e-5(Buchfink et al.,2015)。
【数据】Phred score阈值:< 20;聚类同一性:≥80%;E-value截止值:1e-5;数据库:Nr、GO、Swiss-Prot、KEGG、eggNOG v5.0;BioProject:PRJNA1369639
2.5 差异表达unigene(DEGs)分析
Unigene表达水平使用Salmon(v1.5.0,GPL-3 license)量化,计算TPM(Mortazavi et al.,2008;Patro et al.,2017)。差异表达分析使用edgeR(v3.34.0,Bioconductor,GPL-2 license)基于负二项广义对数线性模型进行(Robinson et al.,2010)。差异表达基因(DEGs)的鉴定阈值为|log₂(fold change)| > 1且错误发现率(FDR)< 0.05,采用Benjamini–Hochberg方法校正以控制多重检验。GO和KEGG富集分析对DEGs使用内部Perl脚本进行。
【数据】表达量化工具:Salmon v1.5.0;差异分析工具:edgeR v3.34.0;DEG阈值:|log₂FC| > 1、FDR < 0.05;校正方法:Benjamini–Hochberg
2.6 同源性分析与系统发育树构建
同源性分析使用ClustalW(v2.1)以默认参数进行(Aiyar,2000)。细胞色素P450蛋白的全长氨基酸序列用于多序列比对。保守结构域使用GeneDoc(v2.7)可视化并手动修正(Nicholas and Nicholas,1996)。系统发育重建在MEGA X(v10.2.6)中使用邻接法进行,1000次bootstrap重复(Kumar et al.,2018)。
【数据】比对工具:ClustalW v2.1;可视化:GeneDoc v2.7;系统发育:MEGA X v10.2.6;bootstrap:1000次
2.7 实时PCR验证
qRT-PCR在10 μL反应体系中进行,含1 μL稀释cDNA(1:10)、5 μL TB Green Premix Ex Taq II(Takara Bio,Dalian,China)和0.1 μM各基因特异性引物。热循环条件为:95°C 10 min;40个循环的95°C 15 s和60°C 60 s;随后进行熔解曲线分析。PaACTIN用作内参。相对表达水平使用2−ΔΔCt方法计算,每个生物学样品设三个技术重复。归一化表达数据以mean ± SD表示(n=3生物学重复)。
【数据】反应体积:10 μL;cDNA稀释:1:10;TB Green Premix:5 μL;引物浓度:0.1 μM;预变性:95°C、10 min;循环:40个(95°C、15 s;60°C、60 s);内参:PaACTIN;方法:2−ΔΔCt;技术重复:3个;生物学重复:n=3
2.8 数据分析
对于生理和qRT-PCR数据(如酸浆苦素F含量和相对表达验证),使用EXCEL2019和SPSS27.0进行统计分析。在单因素方差分析之前,使用Shapiro–Wilk检验评估数据正态性,使用Levene检验评估方差齐性。由于两项假设均满足(所有比较p > 0.05),采用单因素方差分析后进行Tukey's HSD检验进行多组比较(图1d),柱上不同小写字母表示P < 0.05水平显著差异。对于qRT-PCR数据的成对比较,使用星号表示显著性水平:P < 0.05视为具有统计学显著性,用表示;P < 0.01用表示;P < 0.001用表示。
【数据】统计软件:EXCEL2019、SPSS27.0;正态性检验:Shapiro–Wilk;方差齐性:Levene;多组比较:单因素ANOVA + Tukey's HSD;显著性阈值:P < 0.05()、P < 0.01()、P < 0.001()
研究结果
3.1 LC-MS/MS测定酸浆苦素F含量变异
UPLC-MS/MS分析揭示了四种酸浆属植物间酸浆苦素F含量的显著差异(图1d)。最高浓度见于PAF(3678.18 ng/g DW),而PA含量最低(0.18 ng/g DW)。
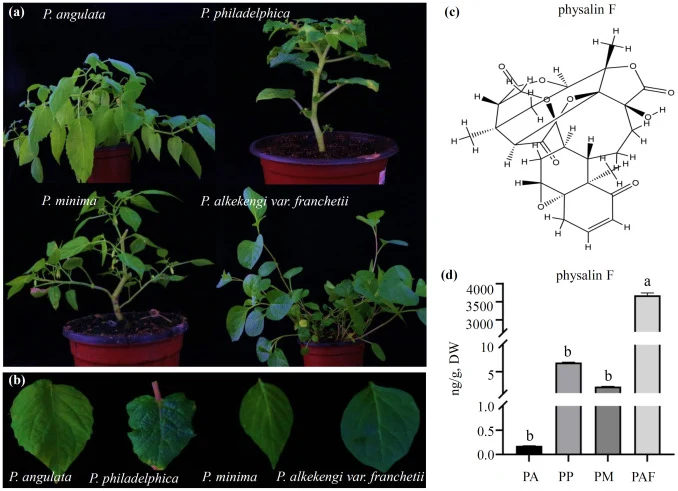
【数据】酸浆苦素F含量:PAF 3678.18 ng/g DW、PA 0.18 ng/g DW
3.2 不同酸浆属植物的转录组
经过质量评估和接头修剪后,我们获得了73.04 Gb高质量测序数据:PA为15.65 Gb,PP为20.95 Gb,PM为19.09 Gb,PAF为17.35 Gb(表S1)。Clean reads质量优异,分别有98.07%和94.34%的碱基高于Q20和Q30阈值。GC含量在各物种间稳定(43.61–45.81%)。四个物种reads的de novo组装产生了88,732个unigenes(N50 = 1,020 bp;平均长度688.11 bp)和253,784个transcripts(N50 = 988 bp;平均长度722.4 bp)(图2a-b)。长度分布分析显示,79%的unigenes(n = 70,430)和77.62%的transcripts(n = 197,018)短于1,000 bp,而大于2,000 bp的序列仅占4.79%(n = 4,246)和4.11%(n = 10,371)(图2c)。功能注释获得了大量匹配:NR中49,350个unigenes(55.64%),eggNOG中48,748个(54.95%),SwissProt中31,530个(35.55%),Pfam中34,463个(38.85%),KEGG中31,708个(35.75%),GO中38,754个(43.68%)(图2d)。跨物种同源性分析鉴定出与被子植物的显著保守性,特别是马铃薯(Solanum tuberosum),显示最高数量的同源基因(n = 17,142)(图2e)。
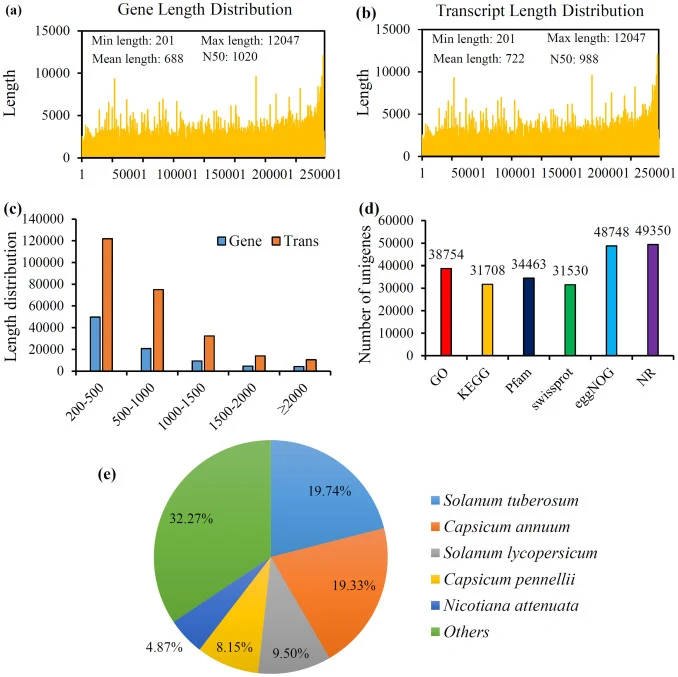
【数据】高质量数据:总计73.04 Gb(PA 15.65 Gb、PP 20.95 Gb、PM 19.09 Gb、PAF 17.35 Gb);Q20:98.07%;Q30:94.34%;GC含量:43.61–45.81%;unigenes:88,732个(N50 = 1,020 bp;平均长度688.11 bp);transcripts:253,784个(N50 = 988 bp;平均长度722.4 bp);<1,000 bp unigenes:79%(n = 70,430);<1,000 bp transcripts:77.62%(n = 197,018);>2,000 bp unigenes:4.79%(n = 4,246);>2,000 bp transcripts:4.11%(n = 10,371);NR注释:49,350(55.64%);eggNOG:48,748(54.95%);SwissProt:31,530(35.55%);Pfam:34,463(38.85%);KEGG:31,708(35.75%);GO:38,754(43.68%);同源基因最高物种:Solanum tuberosum(n = 17,142)
3.3 增强的GO和KEGG条目分类
GO注释将38,754个unigenes(43.68%)分为三个主要域(图3a)。在生物学过程中,转录调控占主导。细胞定位分析鉴定出核相关和细胞质蛋白最为普遍,而分子功能注释揭示蛋白质结合为主要特征。KEGG通路注释将20,796个unigenes(28.51%)分为六个功能类别,主要代表为代谢通路(n=10,200,49.05%)和遗传信息处理(n=6238,30.00%)(图3b)。代谢通路分析揭示核心过程的富集:碳水化合物代谢(n=2,429)、氨基酸代谢(n=1,460)、脂质代谢(n=1,275)、能量代谢(n=1,143)和次级代谢物生物合成(n=744)合计占代谢分配的65.18%。在遗传信息处理中,翻译相关基因构成最大亚组(n=2,714,43.51%),而信号转导在环境信息处理中占主导(n=1,498,87.40%)。
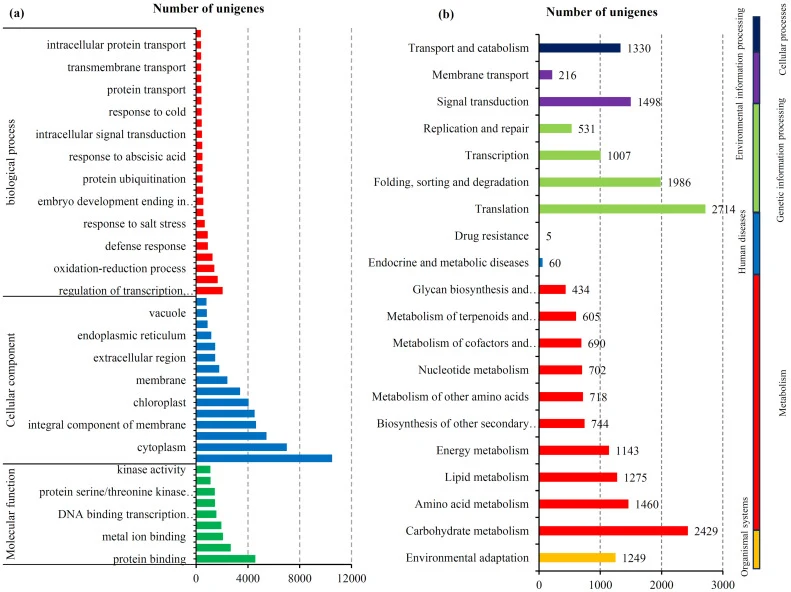
【数据】GO注释:38,754个unigenes(43.68%);KEGG注释:20,796个unigenes(28.51%);代谢通路:n=10,200(49.05%);遗传信息处理:n=6238(30.00%);碳水化合物代谢:n=2,429;氨基酸代谢:n=1,460;脂质代谢:n=1,275;能量代谢:n=1,143;次级代谢物生物合成:n=744;合计占比:65.18%;翻译相关:n=2,714(43.51%);信号转导:n=1,498(87.40%)
3.4 不同比较间DEGs的富集分析
比较转录组分析揭示了各物种对之间的DEG数量(图4a、b,表S3)。种间比较显示不对称表达谱,在PA vs PP中PP的上调unigenes比PA多41.3%(10,512 vs 7,437)(图4b)。观察到转录分化的层次递进:PA vs PAF:29,738个DEGs,PP vs PAF:32,208个DEGs,PM vs PAF:31,684个DEGs,PA vs PM:19,850个DEGs,PP vs PM:23,657个DEGs,PA vs PP:17,949个DEGs。PM vs PAF显示最高转录差异(31,684个DEGs),而PA vs PP显示最低(17,949个DEGs)(图4b)。这些结果表明四种酸浆属植物表现出深刻的转录组分化,物种特异性DEGs可能作为其独特代谢表型的关键驱动因素。比较KEGG分析揭示了层次性通路激活模式(P < 0.05)。PP vs PM显示最高通路多样性(38个富集模块),其次是PA vs PM(33个)和PA vs PP(29个)。两个核心通路在所有比较中保守:苯丙烷生物合成(ko00940)和植物-病原体相互作用(K04079)(图4c)。
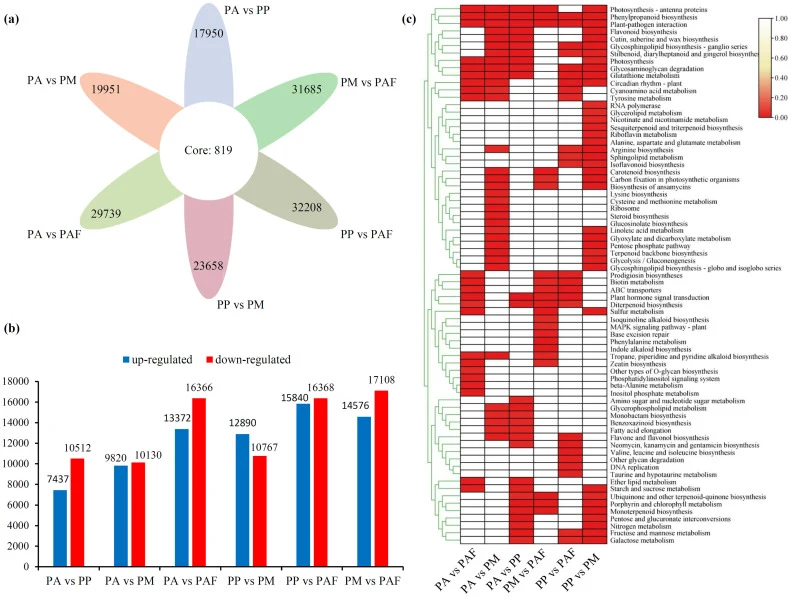
【数据】PA vs PP上调unigenes:PP 10,512 vs PA 7,437(PP多41.3%);DEG数量:PA vs PAF 29,738、PP vs PAF 32,208、PM vs PAF 31,684、PA vs PM 19,850、PP vs PM 23,657、PA vs PP 17,949;最高转录差异:PM vs PAF(31,684);最低:PA vs PP(17,949);KEGG富集模块:PP vs PM 38个、PA vs PM 33个、PA vs PP 29个;保守通路:苯丙烷生物合成(ko00940)、植物-病原体相互作用(K04079);显著性:P < 0.05
3.5 与萜类骨架生物合成相关的DEGs
转录组分析鉴定了编码MEP和MVA通路中所有必需酶的关键unigenes(图5a、b,表S2)。在MVA通路中,三个编码AACT的unigenes显示物种特异性表达:DN22699和DN38031为PM优势,而DN44598在PA中偏好表达(图5b)。这种isoform水平的分配表明PM和PA利用不同的AACT变体将乙酰辅酶A导入MVA通路。编码HMGS的基因DN32555和DN36679分别在PM和PAF中显示峰值表达,表明MVA通路第一个限速步骤的物种特异性调控。在四个编码HMGR的unigenes中,三个(DN38110、DN39761、DN46675)主要在PM中转录,与DN35741的PAF特异性表达形成对比。PM中三个HMGR isoform的普遍存在表明该物种对MVA通量有强烈的转录承诺。下游MVA酶包括MK(DN38057)、PMK(DN46291)和MPDC(DN40862)在PM中的表达比PA、PP和PAF高2.7–3.9倍,表明PM中MVA通量增强。在MEP通路中,三个DXS isoform(DN42851、DN45063、DN47050)在PM中显示显著更高的转录丰度。虽然大多数MEP酶由单个unigenes代表,但CMK(DN44547)和HDR(DN45753)显示PM优势表达。两个基因显示双重表达:编码MDS的DN33833在PA和PM中共表达,而编码HDS的DN49635在PA和PP中激活。MCT在PAF中表达高于其他三个物种。我们鉴定了影响类异戊二烯通量的关键调控节点:编码IPPI的DN41356显示PM富集表达。FPPS(DN45674)转录水平在PM中高3.1倍,强化了该物种中类异戊二烯前体供应增强的概念。观察到物种特异性GPPS isoforms:DN35894(PA/PP优势)、DN36786(PA/PP/PM广泛表达)和DN43567(PAF特异性),表明不同物种依赖不同的GPPS变体进行香叶基二磷酸生产。PM中GGPPS生物合成主要由DN32399介导,表明独特的调控机制。这些发现突出了酸浆属物种间萜类通路调控的进化分化。
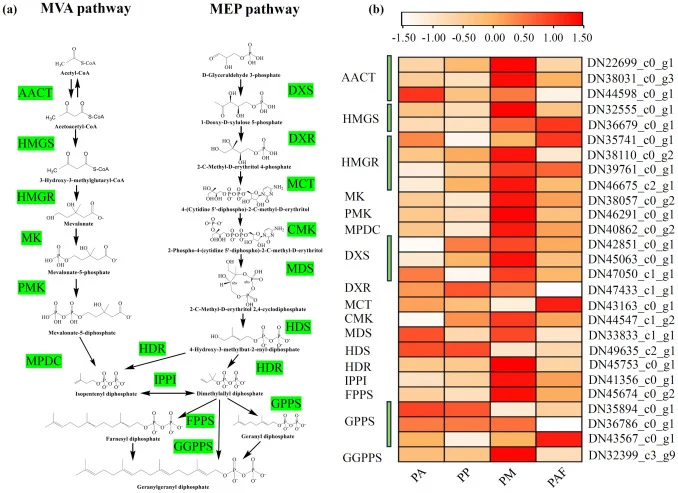
【数据】AACT unigenes:DN22699、DN38031(PM优势)、DN44598(PA偏好);HMGS:DN32555(PM峰值)、DN36679(PAF峰值);HMGR:DN38110、DN39761、DN46675(PM为主)、DN35741(PAF特异性);下游MVA酶:MK(DN38057)、PMK(DN46291)、MPDC(DN40862)在PM中高2.7–3.9倍;DXS isoforms:DN42851、DN45063、DN47050(PM高丰度);CMK(DN44547)、HDR(DN45753)PM优势;MDS(DN33833)PA/PM共表达;HDS(DN49635)PA/PP激活;MCT在PAF中较高;IPPI(DN41356)PM富集;FPPS(DN45674)PM中高3.1倍;GPPS isoforms:DN35894(PA/PP优势)、DN36786(PA/PP/PM广泛)、DN43567(PAF特异性);GGPPS:DN32399(PM主要介导)
3.6 与类固醇生物合成通路相关的DEGs
我们鉴定了十三个编码关键类固醇生物合成酶的unigenes:角鲨烯环氧酶1(SQLE1)、羊毛甾醇合酶(LSS)、环阿屯醇合酶(CAS1)、甾醇14-脱甲基酶(CYP51G1)、Delta(14)-甾醇还原酶(TM7SF2)、甲基甾醇单加氧酶1(SMO1)、3-β-羟基类固醇脱氢酶(NSDHL)、3-β-羟基类固醇-Delta(8),Delta(7)-异构酶(HIS)、甲基甾醇单加氧酶2(SMO2)、Delta24-甾醇还原酶(DWF1)、7-脱氢胆固醇还原酶(DWF5)、环阿屯醇-C-24-甲基转移酶1(SMT1)和环桉叶醇环异构酶(CPI)(图6a)。转录谱中观察到显著的种间变异。NSDHL(DN36413)在PA中偏好表达,表明该物种早期甾醇修饰活性增强。PP显示SQLE1(DN48519)、NSDHL(DN42104)和CPI(DN43663)的优势表达,表明角鲨烯环氧化和环异构化在PP中可能特别活跃。CYP51(DN43581)、DWF1(DN34286)、DWF5(DN30898)和SMT1(DN46970)在PM中显示优势表达,暗示PM在甾醇脱甲基化、侧链还原和C-24甲基化方面投入大量资源——这些是调节甾醇结构多样性的关键步骤。PAF显示CAS1(DN46385)、SMO1(DN28067)和HIS(DN39595)的显著转录活性(图6b),表明环阿屯醇合成和随后的甲基甾醇氧化在该物种中优先增强。这种通路基因表达的物种特异性分配突出了四种酸浆属植物间类固醇代谢调控的进化分化。
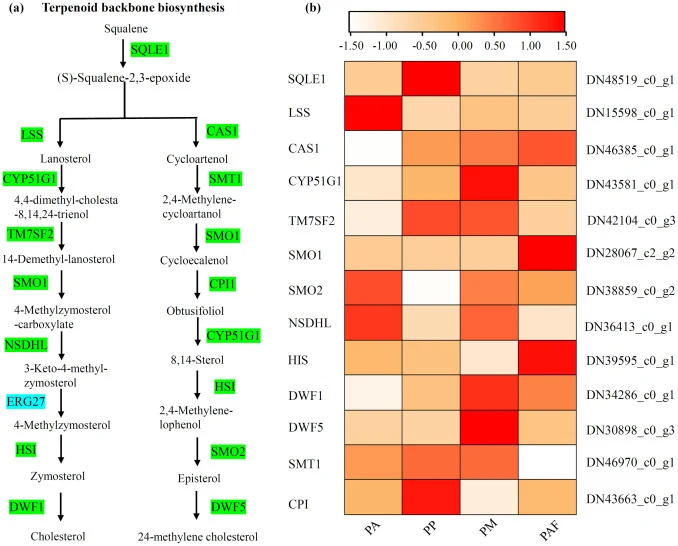
【数据】鉴定unigenes:13个;关键酶:SQLE1、LSS、CAS1、CYP51G1、TM7SF2、SMO1、NSDHL、HIS、SMO2、DWF1、DWF5、SMT1、CPI;NSDHL(DN36413)PA偏好;SQLE1(DN48519)、NSDHL(DN42104)、CPI(DN43663)PP优势;CYP51(DN43581)、DWF1(DN34286)、DWF5(DN30898)、SMT1(DN46970)PM优势;CAS1(DN46385)、SMO1(DN28067)、HIS(DN39595)PAF显著
3.7 与生物活性类固醇生物合成终端步骤相关的DEGs
系统发育重建……(原文此处截断)
【数据】原文未详述
讨论与解读
近年来,酸浆属植物的甾醇因其独特化学结构和显著药理特性而备受关注。LC-MS和NMR等技术已从这些植物中鉴定出20多种甾醇类化合物,包括β-谷甾醇、豆甾醇、菜油甾醇及多种酸浆苦素。酸浆苦素因其抗炎活性而受到重视,通常通过调节NF-κB和MAPK通路介导。作为这些化合物的主要天然储库,酸浆属植物已被广泛分析,鉴定了大量成分。然而,尽管甾醇多样性已有充分记载,积累的种间定量变异——尤其是酸浆苦素之间——仍鲜有探索。本研究结果揭示了四个物种间酸浆苦素F含量的显著差异,PAF显示最高浓度,表明其作为优选来源的潜力。这种异质性强调了物种选择在植物化学采购和功能研究中的重要性。然而,甾醇生物合成种间分化的代谢和遗传机制仍不清楚。比较转录组学方法鉴定DEGs为阐明酸浆属甾醇通路调控的分子基础提供了有前景的策略。本研究结果表明……(原文此处截断)
编译者解读:该研究以比较转录组为切入点,将化学表型(酸浆苦素F含量相差逾两万倍)与转录分化直接关联,方法选择务实——de novo组装规避了参考基因组的缺失,LC-MS/MS定量为后续基因-代谢物关联提供了锚点。然而,转录本丰度不等于酶活,CYP450和3β-HSD的候选基因仍需异源表达或基因编辑验证。对合成生物学而言,PM中MVA通路的多isoform协同上调与PAF中CAS1/SMO1的偏好表达,提示了分模块重构甾体骨架的可能路径,但底物杂泛性与通路串扰仍是放大生产的瓶颈。
参考来源
期刊:Scientia Horticulturae, 2026
DOI: 10.1016/j.scienta.2026.115169
DOI: 10.1016/j.scienta.2026.115169