来源:Combining Automated Kinetic Model Selection with Robust Optimization and Application to Maximize Cell-free Production of UDP-GalNAc(Metabolic Engineering Communications)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
无细胞多酶级联反应能够实现精准生物合成,但其成本效率仍是瓶颈。动力学模型可指导过程优化,却受限于结构不确定性与参数不确定性。本研究提出MoRSel——一种自动化精炼与筛选动力学模型的新方法,基于信息论准则在拟合优度与模型复杂度之间寻找最优平衡。作者将其应用于UDP-GalNAc无细胞合成级联的动力学模型,识别出更准确描述实验行为的模型结构,并结合基于系综的鲁棒优化策略,分别以最大化产物滴度和最小化酶负载为目标进行优化。验证实验显示:产物滴度与转化率均提升约45%;酶成本降低53%的同时,相对滴度与相对产率分别提升80%和75%。
研究背景
生物过程工程的核心目标是设计并优化生化生产过程。利用生物催化剂合成化合物有两条主要路径:体内全细胞催化(常通过基因改造实现产物合成)和体外无细胞系统(利用分离的酶与代谢物)。全细胞系统已在多种应用中取得成功,仍是主流方案,但无细胞系统具有独特优势——不受细胞生长、pH等生理约束,可探索更广泛的通路设计与操作参数空间。然而,无细胞生物合成成本高昂,酶的制备与纯化耗时费力,亟需基于第一性原理的鲁棒优化方法来弥合与低成本、可预测生物生产之间的差距。
无细胞过程通常涉及不超过十几个酶促步骤,组分远少于完整细胞,其动力学可用动力学模型描述、分析与优化。这类模型基于常微分方程,速率方程描述酶催化反应动力学与代谢物浓度及酶丰度的关系。但动力学模型的预测能力常受结构不确定性和参数不确定性限制——前者指模型是否包含所有相关反应与调控相互作用,后者指参数估计的不确定性。本研究提出MoRSel方法应对结构不确定性,并将其与已有的鲁棒优化框架结合,应用于UDP-GalNAc无细胞合成级联的过程优化。
研究方法
2.4 参数不确定性下UDP-GalNAc酶级联的基于模型的优化与实验验证
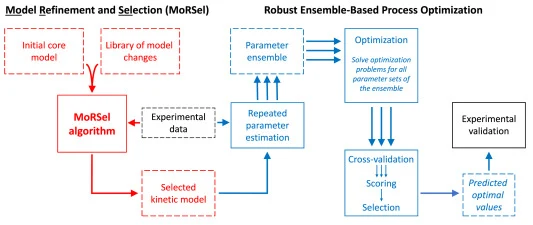
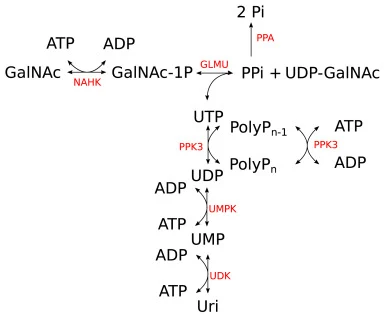
我们使用所选最终模型变体的参数系综,通过应用Huber等人(2024)开发的参数不确定性下优化方法(另见图1),来改善无细胞UDP-GalNAc批次过程相对于既定基线行为(见补充文件S1;实验4;另见图7)的性能。该方法包含三个步骤:(1)定义优化问题并对系综中每个参数集求解(此步骤使用COPASI中实现的遗传算法);(2)计算额外的模型模拟,以检验每个优化结果在系综中所有剩余参数集上的表现(交叉验证);(3)对每个优化结果的性能进行评分,选出最佳结果用于实验验证。如下所述,考虑了三个经济相关的过程目标。
2.4.1 UDP-GalNAc滴度的优化
第一个基于模型的优化问题(方程5a-e)的目标是确定初始酶浓度和底物浓度(决策变量),使7小时后产物UDP-GalNAc的浓度最大化。该问题受最大酶负载约束,该值设为基线实验(补充文件S1中的实验4;另见表4)的酶负载。初始酶浓度和底物浓度受下界和上界约束,这些边界针对所有酶和所有底物,来源于物理和实际考虑(如溶解度)。所选动力学模型变体作为约束包含在优化问题中,初始浓度记为(包含在中)。优化中浓度的起始值设为基线实验的初始浓度。整体优化问题如下:(5a)(5b)(5c)(5d)(5e)
对系综中每个参数集求解优化问题,得到最优初始酶浓度和底物浓度的分布(补充文件S3),表明酶GLMU、NAHK和PPK3的初始浓度在大多数情况下相比基线有所增加。由于总酶负载固定,其他酶的浓度需要降低以补偿。此处,酶UDK、UMPK、尤其是PPA的初始浓度在大多数情况下降低。主要底物尿苷和GalNAc被限制在基线浓度,以排除通过添加更多底物来实现更高滴度的平凡解。关于ATP的初始浓度,如预期,优化器在大多数解中选择将其设为上限,因为ATP是过程初始动态阶段最重要的磷酸供体。所有优化结果在系综的所有参数集上进行了交叉验证和评分,以确定最佳预测(补充文件S3),随后进行了实验测试(图8)。
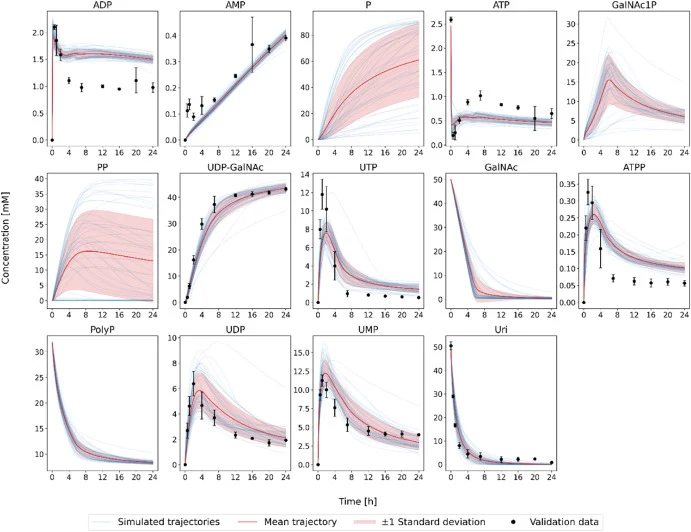
将验证实验的数据点与预测的平均轨迹(在整个参数系综上模拟)进行比较,显示两者吻合良好,尽管仍存在一些误差(且某些代谢物无法测量)。主要底物之一尿苷以及最终产物UDP-GalNAc的模拟轨迹与验证实验数据尤其吻合。原始与预测(最优)初始底物和酶浓度以及基线过程与优化过程性能的比较总结于图9。
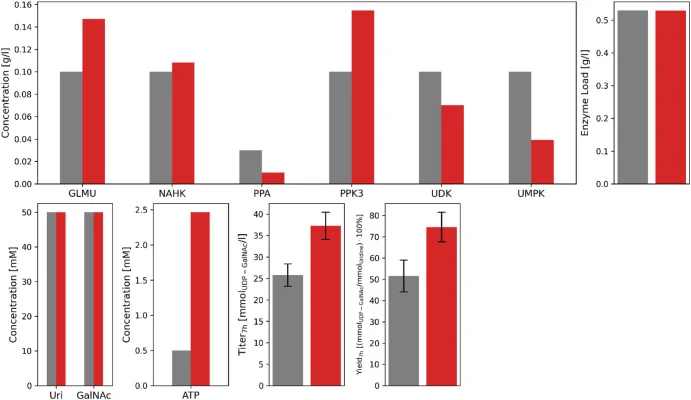
与基线相比,7小时UDP-GalNAc滴度提升了44.72%,从25.76提高到37.28 mmolUDP-GalNAc/l,转化率提升了44.72%(从最大转化率的51.52%提高到74.56% [mmolUDP-GalNAc/mmolUridine · 100%]),尽管两种情况使用了相同的酶负载和相同的主要底物尿苷和GalNAc初始浓度。
【数据】目标产物:UDP-GalNAc;优化时间:7h;滴度提升:44.72%;基线滴度:25.76 mmolUDP-GalNAc/l;优化后滴度:37.28 mmolUDP-GalNAc/l;基线转化率:51.52%;优化后转化率:74.56%;酶负载:与基线相同;底物浓度:尿苷和GalNAc与基线相同
2.4.2 酶负载的优化
第二个基于模型的优化问题(方程6a-f)旨在确定初始酶浓度和底物浓度,使得在给定UDP-GalNAc最低滴度和产率(均在7小时测量,产率参照底物尿苷)的前提下,所需酶负载最小化。与前节相同,动力学模型和所有优化变量的边界作为约束包含在内(分别为方程6b和6c-d;另见表5)。(6a)(6b)(6c)(6d)(6e)(6f)
对系综中每个参数集求解优化问题,得到最优初始酶浓度和底物浓度的分布(补充文件S3),表明大多数酶的浓度相比基线有所降低。唯一例外是GLMU和PPK3,其中位数浓度略高于各自的基线水平。在试图实现整体更低酶负载的同时增加这些酶的浓度,突显了它们对级联性能的重要性。此外,优化器将主要底物尿苷和GalNAc的浓度相比基线略微降低。所有优化结果再次在系综的所有参数集上进行了交叉验证和评分,以确定最佳预测(补充文件S3),随后进行了实验测试(图10)。
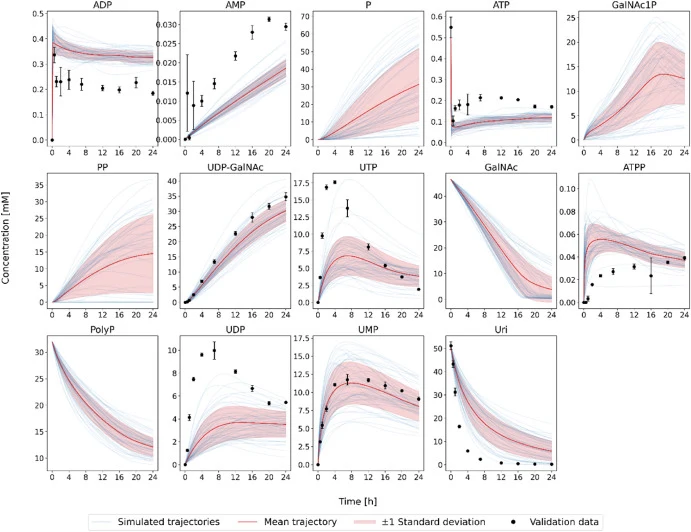
将验证实验的数据点与预测的平均轨迹(在整个参数系综上模拟)进行比较,显示尽管存在一些不匹配,主要底物尿苷以及UMP、尤其是最终产物UDP-GalNAc的轨迹与验证数据吻合良好。原始与预测(最优)初始酶浓度和底物浓度以及基线过程与优化过程性能的比较见图11。
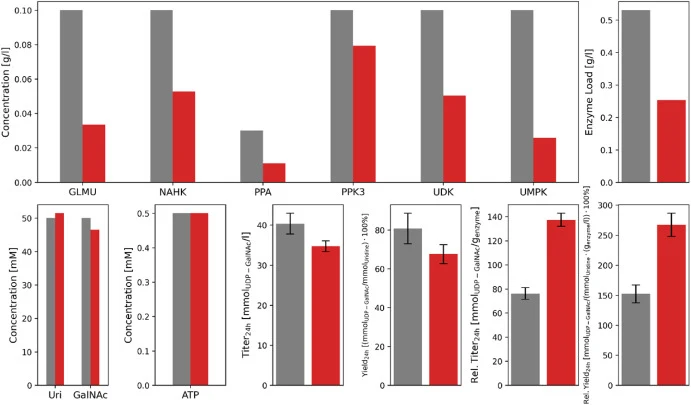
与基线相比,酶负载(及相关成本)显著降低了52.83%,从0.53降至0.25 genzyme/l。在降低的酶负载下,绝对滴度和产率略低于基线(分别降低13.95%和12.32%),从而违反了优化问题中设置的最低滴度和产率约束。这种情况可能发生,因为这些约束的满足取决于所选的动力学参数集,不同于初始条件约束(如酶负载的上界)。因此,当在交叉验证期间使用系综中其他参数集进行模拟时,滴度和产率值可能违反原始约束。对于酶负载优化,我们发现这适用于相应交叉验证表中71%的滴度值和72%的产率值。在针对给定参数集优化模型时(仅对后者约束保证被满足),交叉验证中的这种潜在偏差无法被考虑。由于我们关注每个优化结果在整个参数系综上的性能,所有值(无论是否遵守约束)都被汇总用于评分。通过这种方式,固有的参数不确定性被纳入优化过程。尽管绝对滴度和产率的原始值无法完全达到,但计算相对滴度和相对产率(将绝对滴度和产率除以酶负载)显示两者均可显著改善。相对滴度提升了80.34%,从76.16提高到137.35 mmolUDP-GalNAc/genzyme,相对产率提升了75.40%,从152.32提高到267.17 [100% · mmolUDP-GalNAc/mmolUridine · l/genzyme]。
【数据】酶负载降低:52.83%;基线酶负载:0.53 genzyme/l;优化后酶负载:0.25 genzyme/l;绝对滴度变化:-13.95%;绝对产率变化:-12.32%;交叉验证中违反约束比例:滴度71%、产率72%;相对滴度提升:80.34%(从76.16到137.35 mmolUDP-GalNAc/genzyme);相对产率提升:75.40%(从152.32到267.17 [100% · mmolUDP-GalNAc/mmolUridine · l/genzyme])
研究结果
2 结果
以下首先介绍我们新的动力学模型精炼与选择模块(MoRSel)。第二部分展示其作为鲁棒优化初始模块应用于UDP-GalNAc合成无细胞多酶级联的适用性(图1)。
2.1 新模型选择流程的开发
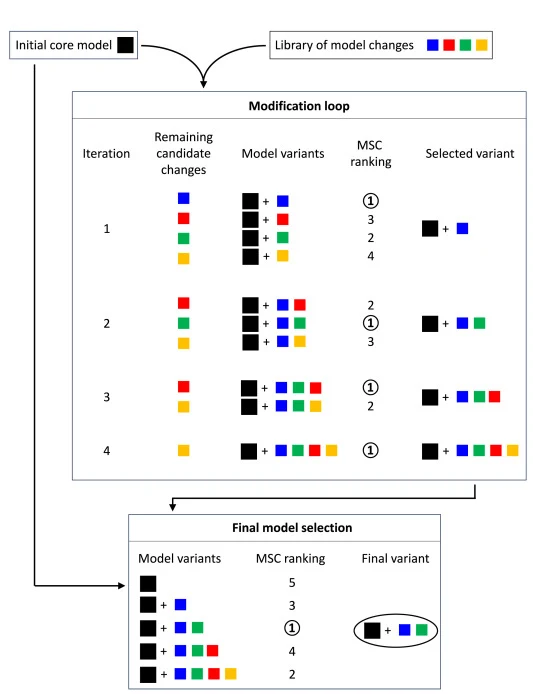
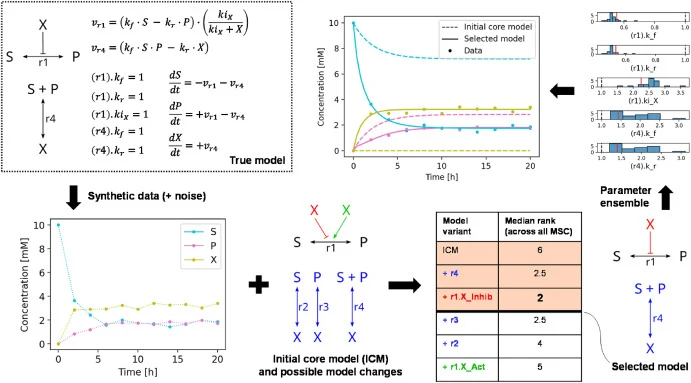
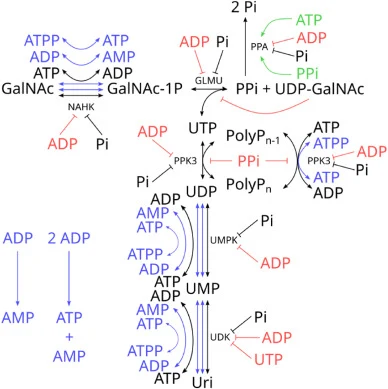
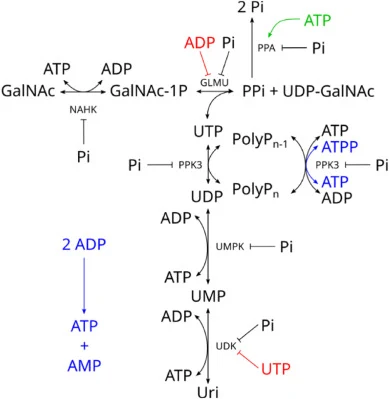
MoRSel实现了一种新的模型选择方法,其流程从初始动力学(核心)模型、候选模型变化库(如添加/删除反应或动力学速率定律的改变)和实验数据集出发,旨在识别拟合优度与模型复杂度之间最优平衡的模型结构。流程从构建初始核心模型开始,该模型通常包含所研究系统的所有已知反应及其假定的动力学速率定律。模型由一组常微分方程表示:(1)其中是所有物种(代谢物和酶)的浓度向量,是反应网络的化学计量矩阵,是(净)反应速率的向量。后者由物种浓度、反应参数和时间的函数(速率定律)定义。对于所有酶催化反应的速率定律,我们使用了Liebermeister和Klipp(2006)的便利动力学公式,这是Michaelis-Menten动力学的推广版本,我们通过整合Haldane关系对其进行了修改(导致包含相应反应平衡常数的项)。因此,每个速率定律包含参与化合物的亲和力参数(Michaelis常数)、酶的转换率以及相应反应的平衡常数。例如,对于一个由酶催化的可逆反应,将两个底物和转化为两个产物和,速率定律为(公式中、和对应各自的浓度):(2)是正向反应的转换率。代谢物与酶之间已知的调控相互作用可通过速率定律中的适当项纳入。通常,核心模型应包含所有(且仅包含)从生物学知识中明确的反应和调控项;这些因此被视为地面真值。
核心模型对实验数据的初始拟合(参数估计)可能无法充分描述给定酶级联的动力学。一个典型原因是初始核心模型未包含代谢物与酶之间所有相关的调控相互作用。这些调控效应可能因一锅法中所有化合物混合后浓度可能超过细胞内生理值而变得相关。出于类似原因,未知或未考虑的副反应可能发生并影响级联的整体动力学。因此,如果拟合后的初始核心模型不能充分描述实验数据,下一步是收集参与酶的潜在变构调控和/或副反应的信息,形成模型变化库。这些模型变化因此要么是化学计量变化(添加或删除整个反应,包括其速率定律),要么是动力学变化(改变反应的相应速率定律)。关于化学计量变化,所有反应(包括不在核心模型中的反应)已存在于化学计量矩阵中,实施化学计量变化等同于将相应的速率定律设为零或设为(新的)速率定律方程。动力学变化以三种方式之一影响反应的速率定律:(a)通过全新的机制描述完全替换它,(b)通过纳入同一酶催化的不同反应之间的竞争性抑制项,或(c)通过将现有速率定律与变构酶调控相关的乘性项组合。在此,为整合变构抑制,我们将相应反应速率的速率定律乘以项,其中是抑制常数,是作为抑制剂的代谢物浓度。对于变构激活项,我们使用因子,其中是激活常数,是作为激活剂的代谢物浓度。由于和是自由参数(在模型拟合期间估计),总是可以通过选择和为零来恢复纳入调控项之前的模型行为。因此,确保通过变构项修改的模型结构的最佳拟合不会比引入调控项之前的模型结构更差。添加新反应时同样如此,因为其参数值可设为0以恢复先前的动力学。只有删除反应可能导致最佳模型拟合变差。
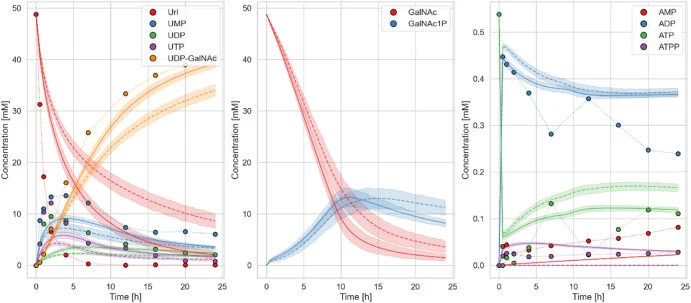
给定初始模型和可能的模型变化列表,我们的模型选择算法旨在识别一组稀疏的模型修改,以提高其拟合优度作为预测能力的指标。模型拟合使用最小二乘方法,目标是最小化模型模拟与实验数据之间的残差平方和(RSS):(3)其中是实验中时间点物种的浓度,是同一时间点相应模型物种的浓度,来自模型模拟(基于参数集和实验中使用的初始浓度)。是实验中物种的归一化权重,由以下方程计算:(4)此处,表示实验中所有时间点上物种所有测量的均方,是实验中测量的物种数。
即使找到了最小化RSS的最优参数集,仅凭RSS也不适合比较具有不同参数数量的模型。特别是,如上所述,向模型添加调控项或反应(及其参数)意味着总是存在一种参数化至少可以重现引入修改之前的模型行为(即RSS不会变差)。为校正这一效应并促进稀疏性,给定模型结构(即其适应度)的质量通过计算模型选择准则(MSC)来评估,MSC惩罚模型参数数量作为模型复杂度的指标。本工作中使用的MSC概述见表1。由于MSC最初基于最大似然估计方法定义,我们使用Portet(2020)推导的最小二乘参数估计的重新表述,该表述适用于数据中的测量误差独立同分布且具有相同方差的正态分布的情况。一个常用的基于信息论考虑的模型选择准则是Akaike信息准则(AIC)(Akaike, 1973)。从给定的一组不同模型中,它旨在找到以最少信息损失解释数据的模型。假设大样本量(数据点数量),准则中包含的惩罚项以考虑模型参数数量(表1)。AIC的校正版本(AICc)由Sugiura(1978)和Hurvich与Chih-Ling(1989)推导。与传统的AIC相比,它具有更复杂的惩罚项,对较小施加更重的惩罚但在增大时趋近于,使校正AIC对较小样本量更稳健。AIC和AICc都不假设真实模型包含在待测试的模型集中。这与贝叶斯信息准则(BIC)(Schwarz, 1978)形成对比,后者选择在给定可用数据下最大化其后验概率的模型,假设真实模型……
【数据】核心模型速率定律:便利动力学(Liebermeister & Klipp, 2006)+ Haldane关系;模型表示:常微分方程;拟合方法:最小二乘法最小化RSS;权重计算:归一化权重(方程4);模型选择准则:AIC、AICc、BIC;变构抑制项:;变构激活项:;AIC惩罚项:;样本量假设:大样本
讨论与解读
本研究提出了MoRSel——一种在结构不确定性下构建动力学模型的新模型精炼与选择方法。从初始核心模型、可能的模型变化库和实验数据出发,候选变化被迭代整合到核心模型中,其对模型优度的影响通过聚合不同的模型选择准则来评估。通过这种方式,使用贪婪搜索算法探索了一个由有限初始定义假设组成的精选空间。MoRSel与先前开发的参数不确定性下鲁棒基于模型优化框架(Huber等,2024)无缝集成,此处应用于成功优化UDP-GalNAc核苷酸糖生产的无细胞酶级联,分别针对产物滴度和酶负载进行了优化。
在解决从多种可能变体中选择最佳模型这一问题上,已有不同方法被提出。在这一范围内,MoRSel可归类为假设库驱动的初始模型结构精炼。这提高了结果的生物学可解释性,特别适用于不同结构假设定义明确的问题。在其他可用方法中,modelMAGE框架(Flöttmann等,2008;Schaber等,2011)与我们的方法最为相似。他们的方法从……
编译者解读
MoRSel的核心价值在于将模型结构选择从人工试错转变为可量化的自动化流程——用信息论准则惩罚复杂度,用贪婪搜索探索假设空间,再与参数系综鲁棒优化衔接,形成从模型构建到过程决策的闭环。对无细胞合成生物学而言,这意味着当一锅法中出现非生理浓度的意外调控或副反应时,不必依赖直觉逐一排查,而是让算法在预定义的生物学假设库中筛选。局限同样明显:方法的可靠性高度依赖候选变化库的完备性,若真实调控机制未被纳入库中,MoRSel无法凭空发现;此外,交叉验证中约束违反率高达71%-72%,提示参数不确定性向约束满足的传导仍是鲁棒优化的薄弱环节。
参考来源
期刊:Metabolic Engineering Communications, 2026
DOI: 10.1016/j.mec.2026.e00287
DOI: 10.1016/j.mec.2026.e00287