来源:Kinetic metabolic modeling of Saccharomyces cerevisiae mutants reveals two major regulatory patterns of glycolytic flux control(Journal of Bioscience and Bioengineering)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
维持高糖酵解通量对酿酒酵母的乙醇发酵与代谢工程至关重要,但基因扰动下酵母如何防止糖酵解"涡轮设计"过度激活,机制尚不清楚。日本学者佐藤元树构建了涵盖90个反应、543个参数的酵母中心碳代谢动力学模型,利用野生型与11株单基因缺失突变体的多组学数据(蛋白质组、代谢组、通量组)通过遗传算法训练模型集合,再以代谢控制分析(MCA)解析通量控制格局。结果显示,所考察的多数菌株遵循两种主要调控模式:HXK限制型与ATP需求耦联型。该研究为靶向代谢工程与稳健生物工艺设计提供了理论依据。
研究背景
糖酵解是酿酒酵母发酵生产的核心通路。高通量发酵要求细胞维持较高的糖酵解通量,但通路本身具有"涡轮设计"特征——即上游ATP投入与下游ATP产出之间的失衡容易导致代谢物过度积累。细胞如何通过调控网络避免这种过度激活,尤其在单基因缺失等遗传扰动下是否仍能维持稳健的通量控制,此前缺乏系统研究。以往对糖酵解控制结构的认识多来自简化模型或野生型菌株,缺少在多突变体背景下、整合多组学数据的定量解析。动力学模型结合代谢控制分析(MCA)可以在网络尺度上计算通量控制系数(FCC),从而定量判断哪些酶步骤对目标通量具有主导控制作用。本研究即以此为切入点,构建了覆盖酵母中心碳代谢的动力学模型,并用实验测得的多组学数据对模型集合进行训练与校验,进而比较野生型与11株单基因缺失突变体的通量控制模式,试图回答"通量控制是少数几种固定模式,还是随菌株各异"这一问题。
研究方法
酵母菌株与培养条件
酿酒酵母S288C(MATα mal SUC2)购自日本国家生物资源项目(NBRP)。11株单基因缺失菌株(ald6Δ、gcn4Δ、gcr2Δ、gnd1Δ、pdb1Δ、pdc1Δ、pfk1Δ、rpe1Δ、sol3Δ、tal1Δ和tdh1Δ)按此前所述方法在S288C背景中构建(表S1)。菌株划线接种于酵母提取物–蛋白胨–葡萄糖(YPD)琼脂平板(10 g/L Bacto酵母提取物、20 g/L Bacto蛋白胨、20 g/L葡萄糖、20 g/L琼脂),30 °C过夜培养。第一次预培养:挑取单菌落接种于试管中5 mL YPD培养基,30 °C、120 rpm培养24 h(n = 1)。第二次预培养与主培养使用合成葡萄糖(SD)培养基(5 g/L葡萄糖、6.7 g/L无氨基酸酵母氮源)。将第一次预培养物接种至200 mL挡板瓶中50 mL SD培养基,初始OD600为0.05,于BioShaker(G.BR-200,TAITEC,日本埼玉)中30 °C、120 rpm培养24 h。所得第二次预培养物以相同条件接种主培养,培养12–60 h。为制备代谢组与蛋白质组分析所需的同位素标记内标,第二次预培养与主培养中的葡萄糖均替换为[U–13C]葡萄糖(Cambridge Isotope Laboratories,美国马萨诸塞州Tewksbury;纯度>99%)。OD600用UV-1280分光光度计(Shimadzu,日本京都)测定。胞外葡萄糖、乙醇、甘油和乙酸按此前所述方法用配备示差折光检测器的Prominence高效液相色谱仪(Shimadzu)定量。
【数据】菌株:S288C及11株单基因缺失株(ald6Δ、gcn4Δ、gcr2Δ、gnd1Δ、pdb1Δ、pdc1Δ、pfk1Δ、rpe1Δ、sol3Δ、tal1Δ、tdh1Δ);培养基:YPD(10 g/L酵母提取物、20 g/L蛋白胨、20 g/L葡萄糖、20 g/L琼脂)、SD(5 g/L葡萄糖、6.7 g/L酵母氮源);温度:30 °C;转速:120 rpm;预培养时间:24 h;主培养时间:12–60 h;初始OD600:0.05;同位素标记物:[U–13C]葡萄糖(>99%纯度)
基于13C的代谢通量分析
13C代谢通量分析(13C-MFA)按此前所述方法进行。简言之,主培养培养基中的葡萄糖替换为[1–13C]葡萄糖(Cambridge Isotope Laboratories;纯度>99%)。细胞于指数生长期收获。胞内蛋白用盐酸水解,所得蛋白源氨基酸用含1%叔丁基二甲基氯硅烷(TBDMCS)的N-(叔丁基二甲基硅烷基)-N-甲基三氟乙酰胺(MTBSTFA)(GL Sciences,日本东京)衍生化。氨基酸的13C标记比例用气相色谱–质谱联用(GC–MS;GCMS-QP2020,Shimadzu)测定。校正接种细胞带来的标记与天然同位素丰度后获得质量同位素分布向量(MDV)(表S2)。比葡萄糖消耗速率及乙醇、甘油、乙酸比生成速率取自此前研究(表S3)。13C-MFA所用酿酒酵母代谢模型与此前研究相同(表S4)。通量通过将模型拟合至MDV与比速率、以mfapy软件最小化残差平方和进行估计(表S5)。34个反应通量值的95%置信区间用网格搜索法确定,并纳入比生长速率,共得到35个通量值(表S5)。
【数据】标记底物:[1–13C]葡萄糖(>99%纯度);衍生化试剂:MTBSTFA含1% TBDMCS;分析仪器:GCMS-QP2020(GC–MS)、mfapy软件;通量值数目:35个(含比生长速率);置信区间:95%;统计方法:残差平方和最小化、网格搜索法
胞内代谢物浓度定量
胞内代谢物浓度采用改良的此前报道方法测定。首先,S288C细胞在第二次预培养与主培养葡萄糖均替换为[U–13C]葡萄糖的培养基中培养。于OD600 = 1.5(OD600 × mL = 10)收获细胞,经聚四氟乙烯膜滤器(孔径0.45 μm、直径47 mm;Omnipore,Merck Millipore,美国新泽西州Kenilworth)快速过滤收集。滤膜立即浸入1.6 mL含各5 μM环亮氨酸、核糖醇、d-樟脑磺酸、利多卡因和正缬氨酸的冷甲醇中,−80 °C保存。胞内代谢物用甲醇/氯仿/水法提取。甲醇溶液中加入640 μL Milli-Q水和1.6 mL氯仿,1560 × g、4 °C离心20 min。水相(250 μL)分装至六个微量离心管,于SpeedVac(Thermo Fisher Scientific,美国马萨诸塞州Waltham)减压干燥,−80 °C保存。每份干燥样品与38种非标记代谢物标准品混合物(表S6)混合,各代谢物终浓度10 μM。38种代谢物用离子对液相色谱–三重四极杆质谱联用(LC–MS/MS)分析,系统为Nexera X2(Shimadzu),配备Mastro C18柱(150 × 2.1 mm,3 μm;Shimadzu GLC,日本东京)与LCMS-8050(Shimadzu)。S288C提取物中13C标记代谢物浓度由非标记/标记峰面积比确定。随后,S288C与11株缺失株在非标记葡萄糖培养基中培养,于指数生长期(OD600 = 0.7–1.2)收获细胞并按上述方法用甲醇淬灭。提取时,将13C标记S288C提取物的干燥样品重悬于800 μL Milli-Q水作为内标溶液。内标溶液(640 μL)与1.6 mL氯仿一同加入甲醇溶液。提取与LC–MS分析按此前所述进行。提取液中各代谢物浓度按公式(2)计算:提取液代谢物浓度(μM)=(12C峰面积/13C峰面积)× 13C标记样品中代谢物浓度。另有12种代谢物(表S7)按此前所述用GC–MS定量。含各代谢物1、5、10、50或100 μM的标准溶液以相同方式分析。代谢物浓度由以正缬氨酸为内标归一化的外标峰面积校准曲线计算。胞内浓度(mM)由实测提取液浓度换算,采用干细胞重值0.22 g/L/OD600与比细胞体积1.7 mL/gDCW(表S8)。
【数据】收获OD600:1.5(OD600 × mL = 10);滤膜:0.45 μm孔径、47 mm直径;淬灭液:冷甲醇含5 μM环亮氨酸、核糖醇、d-樟脑磺酸、利多卡因、正缬氨酸;提取体系:640 μL水 + 1.6 mL氯仿;离心:1560 × g、4 °C、20 min;水相分装:250 μL × 6管;标准品:38种代谢物、终浓度10 μM;LC柱:Mastro C18(150 × 2.1 mm,3 μm);质谱:LCMS-8050;收获OD600范围:0.7–1.2;GC–MS标准品浓度:1、5、10、50、100 μM;换算参数:0.22 g/L/OD600、1.7 mL/gDCW
靶向蛋白质组分析
相对酶表达水平用靶向蛋白质组分析按此前所述方法定量。简言之,S288C与11株缺失株培养以获得胞内蛋白的肽段消化物。这些菌株同时在第二次预培养与主培养葡萄糖均替换为[U–13C]葡萄糖的培养基中培养,以获得13C标记肽段消化物。酵母培养物于指数生长期(OD600 = 0.7–1.2)、OD600 × mL = 50收获。粗蛋白提取用珠磨破碎仪(Beads Crusher μT-12,TAITEC)配氧化锆珠(0.6 mm与5 mm珠),2000 min−1、4 °C处理5 min。蛋白浓度用Qubit 3.0荧光仪(Thermo Fisher Scientific)测定。蛋白按此前所述用胰蛋白酶(Promega,美国威斯康星州Madison)与LysC(Wako Pure Chemical Industries,日本大阪)消化。所得肽段用MonoSpin C18柱(GL Sciences)脱盐。13C标记肽段消化物等体积混合作为内标溶液。各非标记样品与内标溶液等体积混合。肽段混合物用纳升液相色谱–超快速质谱(nanoLC–UFMS)(LC-20ADnano与LCMS-8040;Shimadzu)分析,靶向204种蛋白(表S9)。色谱数据用Skyline 3.1版处理,肽段丰度以归一化至相应13C标记内标峰的峰面积定量。选取在所有样品中峰信噪比持续较高的肽段用于蛋白丰度定量。对每个样品,取……(原文此处截断)
【数据】收获条件:OD600 = 0.7–1.2、OD600 × mL = 50;破碎:2000 min−1、4 °C、5 min、氧化锆珠0.6 mm与5 mm;蛋白定量:Qubit 3.0;消化酶:胰蛋白酶、LysC;脱盐柱:MonoSpin C18;分析系统:nanoLC–UFMS(LC-20ADnano + LCMS-8040);靶向蛋白数:204种;数据处理软件:Skyline 3.1
研究结果
多组学数据集的获取
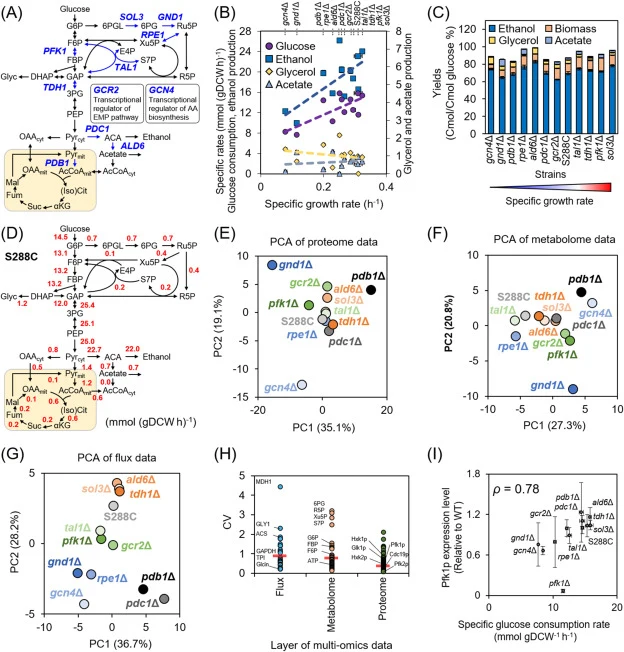
在含葡萄糖的合成培养基中对酿酒酵母S288C及11株单基因缺失株进行摇瓶批式培养(图2A,表S1)。11株单基因缺失株依据文献报道的细胞生长表型任意选取。培养曲线数据取自此前研究并分析计算得率(表S3)。S288C的比生长速率为0.29 ± 0.003 h−1(图2B),乙醇得率为69.5% C-mol/C-mol葡萄糖(图2C)(表S3)。S288C的比葡萄糖消耗速率与比乙醇生成速率分别为14.6 ± 0.1与20.3 ± 0.5 mmol (gDCW h)−1,与此前报道值接近。各缺失株的比生长速率介于S288C值的28%(gcn4Δ)至110%(sol3Δ)之间(图2B)。gcn4Δ与gnd1Δ生长缓慢的表型表明这两处缺失对细胞代谢状态影响显著。相反,tdh1Δ与sol3Δ的生长未变或略有增强,提示这些缺失的代谢效应被代谢状态的翻译与翻译后调控所补偿。尽管菌株间存在差异,两株生长缓慢菌株(gcn4Δ与gnd1Δ)的比葡萄糖消耗与比乙醇生成速率低于其他菌株(图2B);而这些菌株的乙醇得率与其他菌株相近(图2C)。自培养对数中期取样获得多组学数据集,包括35个反应的通量水平(n = 1)、50种代谢物的胞内浓度(n = 3)以及中心碳代谢中143种酶蛋白的相对表达水平(n = 3)(表S5、S8、S10)。S288C的代谢通量分布呈现Crabtree效应,与此前研究结果一致(图2D)。全部12株菌的13C-MFA结果均通过卡方检验(表S5)。为表征菌株间差异,对每个组学层分别进行主成分分析(PCA)。蛋白质组层未见明显聚类,但生长最慢的三株菌(gcn4Δ、gnd1Δ与pdb1Δ)的数据形成离群点(图2E),表明其酶表达谱发生显著改变。同样三株菌的数据在代谢组层亦为离群点,尽管未见明显聚类(图2F)。然而,这些离群点在通量组层未出现(图2G)。该模式提示蛋白质组与代谢组层的广泛变化限制了通量组层的变异。为表征各組学层,计算S288C与11株缺失株间各可观测量的变异系数(CV)并跨组学层比较(图2H;表S18、S19)。通量组、代谢组与蛋白质组层的平均CV值分别为0.89、0.77与0.38,表明蛋白质组层的变异在代谢组与通量组层被放大。通量组层中变异性最高的反应为苹果酸脱氢酶(MDH,CV = 4.4)、苏氨酸醛缩酶(GLY1,CV = 2.3)与乙酰辅酶A合成酶(ACS,CV = 1.9)。相反,通量变异性最低的是葡萄糖消耗速率、磷酸丙糖异构酶(TPI)与3-磷酸甘油醛脱氢酶(GAPDH),CV均为0.22(图2H)。这些低变异反应属于糖酵解,提示中心糖酵解通量受到调控以最小化代谢网络内的波动。因此,研究者考察了催化已知糖酵解限速步骤的己糖激酶(HXK)、磷酸果糖激酶(PFK)与丙酮酸激酶(PYK)的酶表达变异性。HXK同工酶丰度的变异(Hxk1p:0.88,Hxk2p:0.44,Glk1p:0.69)显著高于PYK(Cdc19p:0.25)或PFK亚基(Pfk1p:0.35,Pfk2p:0.13)。代谢组层中,上游糖酵解中间物(6-磷酸葡萄糖,G6P;6-磷酸果糖,F6P;FBP)与戊糖磷酸途径(PPP)中间物变异性高,而ATP浓度CV相对较低,为0.43(图2H)。跨通量组、蛋白质组与代谢组层的相关性分析揭示15个统计学显著相关(表S19、S20)。最显著的正相关出现在Pfk1p表达与糖酵解通量之间(图2I)。此前工作同样记录了糖酵解通量与PFK热力学驱动力(ΔΔG)之间的正相关。这些相关性提示Pfk1p表达降低会降低糖酵解通量。此外,HXK与磷酸葡萄糖异构酶(PGI)通量与其各自途径产物G6P、F6P浓度之间呈负相关(表S19、S20)。这两个反应均可被己糖磷酸的积累所抑制,提示产物抑制可能参与糖酵解通量控制。另外,丙酮酸脱羧酶(PDC)通量——将丙酮酸导向乙醇的起始步骤——与其主要同工酶Pdc1p表达水平之间呈正相关(表S19、S20)。
【数据】比生长速率:S288C 0.29 ± 0.003 h−1;乙醇得率:69.5% C-mol/C-mol葡萄糖;比葡萄糖消耗速率:14.6 ± 0.1 mmol (gDCW h)−1;比乙醇生成速率:20.3 ± 0.5 mmol (gDCW h)−1;缺失株比生长速率范围:S288C值的28%(gcn4Δ)–110%(sol3Δ);多组学数据规模:35个反应通量(n = 1)、50种代谢物(n = 3)、143种酶蛋白(n = 3);平均CV:通量组0.89、代谢组0.77、蛋白质组0.38;最高通量CV:MDH 4.4、GLY1 2.3、ACS 1.9;最低通量CV:葡萄糖消耗、TPI、GAPDH均为0.22;HXK同工酶CV:Hxk1p 0.88、Hxk2p 0.44、Glk1p 0.69;PYK CV:Cdc19p 0.25;PFK亚基CV:Pfk1p 0.35、Pfk2p 0.13;ATP CV:0.43;显著相关数:15个
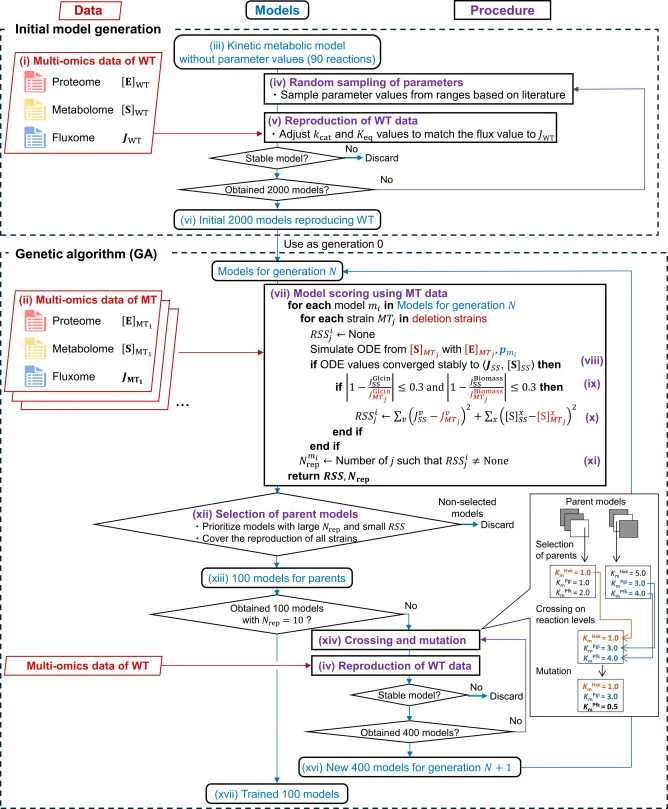
利用多组学数据集训练动力学代谢模型
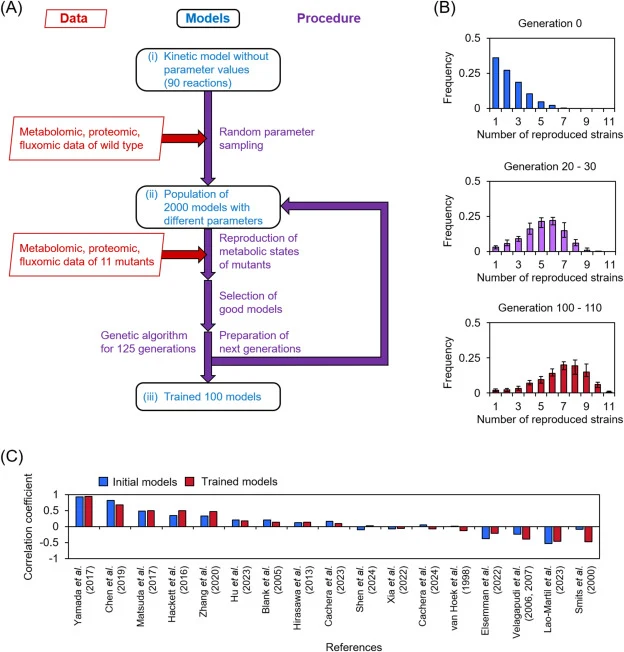
跨多组学层的相关性分析未揭示针对单个缺失株的特异性控制机制。因此,研究者进行MCA。MCA是一种局部敏感性分析方法,通过FCC定量酶活性变化对目标通量值变化的贡献。尽管FCC可通过扰动酶活性实验估计,但此类测量在代谢网络尺度上通常不切实际。因此,FCC由基于常微分方程(ODE)、以酶动力学速率方程参数化的动力学模型计算。将现有的酵母代谢动力学模型扩展至包含90个反应与543个参数(表S11;图3A,i)。速率方程纳入49个已知的代谢物介导变构调控。胞外代谢物浓度固定,而包括葡萄糖消耗与比生长在内的所有交换通量均为代谢物浓度的函数。543个参数中,239个具有体外测定的文献值,但其对应的体内值未知。由于其余304个参数缺乏体外测量(表S13),研究者以多组学数据作为训练数据,用遗传算法(GA)优化参数集。首先,生成2000个能重现S288C野生型状态的随机参数化模型作为初始模型(图3A,ii)。除k cat外的参数值(如K m与K i)在有文献值时围绕文献值采样,无文献值时在0.001至100之间采样。随后计算k cat值以重现野生型多组学状态。接着,评估每个模型重现11株缺失株代谢状态的能力。例如,将pfk1Δ的酶表达谱施加于各模型,再正向积分至重现的稳态。当重现的比葡萄糖消耗速率与生长速率在实测值的±30%以内时,认为模型重现了pfk1Δ。该容差参照此前集合动力学建模研究的准则设定,以容许实测比速率的实验变异性及速率方程固有的简化。对全部11株菌执行相同流程,保留……(原文此处截断)
【数据】模型规模:90个反应、543个参数;变构调控数:49个;参数构成:239个有体外文献值、304个缺乏体外测量;初始模型数:2000个;参数采样范围:0.001–100(无文献值时);重现判据:比葡萄糖消耗速率与生长速率在实测值±30%以内;菌株数:11株缺失株 + 野生型
单基因缺失株的代谢控制分析
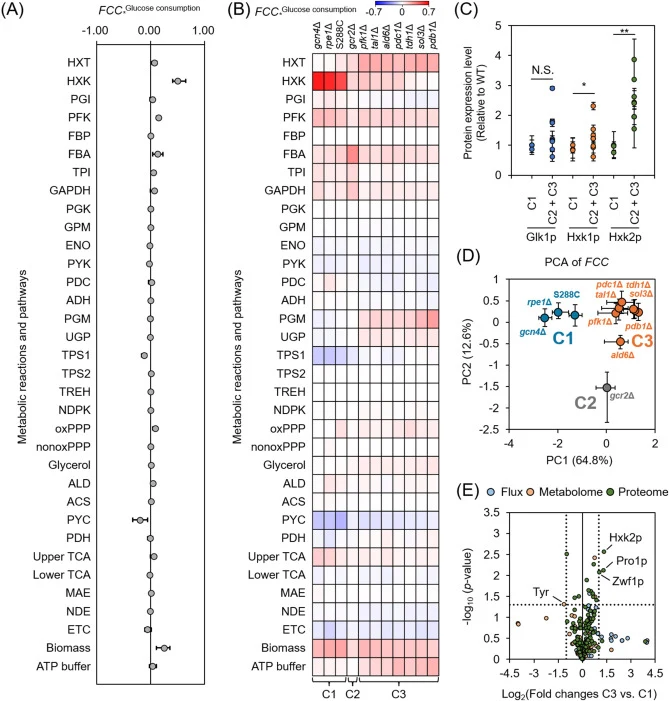
用训练好的动力学模型集合对S288C与10株单基因缺失株进行MCA(图4)。图4A显示S288C中相对于葡萄糖消耗通量的FCC。图中为100个模型的中位数,误差棒表示第10与第90百分位数……(原文此处截断)
【数据】模型集合规模:100个模型;统计量:中位数、第10与第90百分位数;分析对象:S288C与10株单基因缺失株(gnd1Δ未被模型重现);控制系数:FCC(相对于葡萄糖消耗通量)
MCA揭示的糖酵解通量调控模式
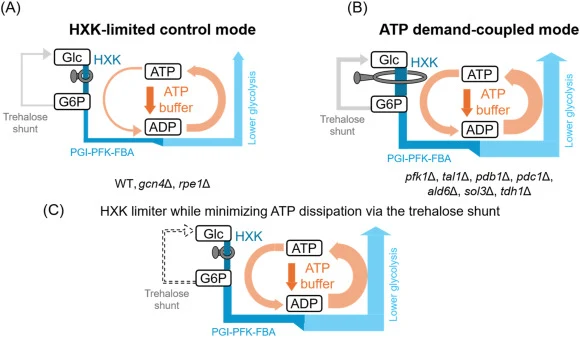
图5A显示野生型、gcn4Δ与rpe1Δ中的HXK限制型控制模式,其中降低的己糖激酶活性作为反馈限制器防止通路过度激活。图5B显示pfk1Δ、tal1Δ、pdb1Δ、pdc1Δ、ald6Δ、sol3Δ等7株突变体转向ATP需求耦联模式,通量控制转移至耗能反应,使糖酵解通量与ATP需求直接挂钩……(原文此处截断)
【数据】HXK限制型菌株:WT、gcn4Δ、rpe1Δ;ATP需求耦联型菌株:pfk1Δ、tal1Δ、pdb1Δ、pdc1Δ、ald6Δ、sol3Δ等7株;特殊菌株:gcr2Δ控制谱独特、gnd1Δ未被模型重现
讨论与解读
本研究考察了酿酒酵母高糖酵解通量的调控原理。通过分析单基因缺失突变体,研究者试图判断糖酵解通量的控制模式是局限于少数几种固定模式,还是在各缺失株间各不相同。为此,从野生型与11株缺失株收集多组学数据集(图2),并用GA训练动力学代谢模型(图3)。用训练好的模型集合进行MCA,揭示了这些菌株中控制糖酵解通量的关键反应(图4)。结果表明,至少在本研究所考察的菌株与培养条件下,酿酒酵母的糖酵解通量控制主要通过两种主要调控模式运作(图4B)。在野生型、gcn4Δ与rpe1Δ中,己糖激酶(HXK)表现出最高的正FCC,作为主导限速步骤。早期建模研究亦有类似结论:Smallbone等将实验参数纳入简化的酵母糖酵解模型,观察到HXK对糖酵解通量具有最高的正控制;其他针对野生型酵母的研究也提示类似控制。尽管本研究扩展后的代谢模型纳入了中心碳代谢、细胞生长并基于多组学数据进行动态训练,仍重现了这些结果,提示野生型酵母主要依赖……(原文此处截断)
编译者解读:该研究的方法学价值在于把"多组学数据训练动力学模型集合 + MCA"做成可复用管线:2000个初始模型经±30%容差筛选后取100个模型中位数计算FCC,有效规避了单一参数集的过拟合。两大调控模式的划分对代谢工程有直接指导意义——若目标产物走乙醇路径,HXK限制型菌株宜上调HXK或解除产物抑制;若需通量与ATP需求解耦,则ATP需求耦联型底盘更适合作能量耦合型合成。局限也明显:仅摇瓶批式、n = 1的通量数据、gnd1Δ无法重现、gcr2Δ控制谱独特,说明模型对PPP与调控层扰动仍不完备,后续需补充分批培养与调控突变数据。
参考来源
期刊:Journal of Bioscience and Bioengineering, 2026
DOI: 10.1016/j.jbiosc.2026.10.001
DOI: 10.1016/j.jbiosc.2026.10.001