来源:Beyond abundance in SELEX-NGS: AI-guided decoding of aptamer–protein binding predictors validated by biosensors(Sensors and Actuators B: Chemical)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
SELEX联合二代测序已成为适配体发现的主流平台,但仅凭序列丰度筛选高亲和力候选物的传统范式并不可靠。本研究以HSP70为靶标,采用无偏、保多样性的采样策略,从NGS文库中选取覆盖宽丰度范围的候选适配体,逐一测定结合亲和力,并据此构建可解释机器学习模型。结果显示,除序列丰度外,氢键网络是预测高亲和力的高权重特征;一个低丰度却高亲和力的"非典型"适配体Apt948被鉴定出来,并成功用于构建可重复使用的电化学生物传感器,检测限达2.63 pg/mL。
研究背景
适配体是短单链寡核苷酸,常被称为"化学抗体"。相比传统蛋白抗体,它们热力学稳定性优异、合成成本低、易于修饰,因而被广泛整合进临床诊断、环境危害监测和食品安全等分析平台。自1990年SELEX问世以来,其与NGS的联用已成为分离各类靶标适配体的通用策略。标准流程中,文库需经9–15轮PCR富集,随后研究者通常只挑选丰度最高的序列(如前20条)进行亲和力验证。然而,这种以丰度为依据的筛选范式受三重制约:其一,低效分配、PCR扩增和测序方法固有的偏好性会随机富集非特异性或弱结合序列;其二,某些蛋白靶标结构可塑性强,会导致"丰度塌缩",使NGS图谱缺乏可辨的序列梯度,丰度依赖型筛选随之失效;其三,金标准亲和力测定通量有限,无法覆盖全部候选序列。因此,亟需一种超越丰度、可解释且与结合能力强相关的预测框架。
研究方法
2.1 材料
本研究所用材料与试剂的完整清单见支持信息。
【数据】材料与试剂:详见支持信息;原文未详述具体清单内容
2.2 适配体的体外筛选与分析
#### 2.2.1 体外筛选过程
适配体体外筛选在30°C下利用Octet K2生物层干涉仪系统完成。简言之,将靶标HSP70(10 μg/mL)固定于Ni-NTA生物传感器上,随后与包含超过10¹⁴条独特ssDNA寡核苷酸的高多样性初始文库孵育600 s(图S1)。为严格去除非特异性结合物,功能化传感器经历严格洗涤步骤(600 s),所用缓冲液采用逐步升高的离子强度梯度(0.1–1.0 M)。为严格保证靶标特异性,整合了双重反筛选机制:先用裸Ni-NTA生物传感器弃除基质结合假象,再以Hsp90和AFP作为分子诱饵耗竭交叉反应亚群。保留的高亲和力寡核苷酸复合物随后通过蛋白酶K酶解洗脱。回收的扩增子经PCR扩增,再用λ-核酸外切酶消化,选择性再生正向单链DNA(ssDNA)池以供后续循环使用。该迭代富集过程连续维持九轮。最终,富集池进行高通量NGS测序。该过程产生了超过140,000条独特候选序列的庞大景观,明确展示了富集文库的非凡随机性和广泛结构多样性,从而为后续无偏采样提供了坚实基础。
【数据】靶标:HSP70;靶标浓度:10 μg/mL;初始文库:>10¹⁴条独特ssDNA;孵育时间:600 s;洗涤时间:600 s;离子强度梯度:0.1–1.0 M;筛选轮数:9轮;NGS产出:>140,000条独特候选序列;温度:30°C;仪器:Octet K2生物层干涉仪
#### 2.2.2 保多样性、无偏采样策略
实施了无偏、保多样性的采样策略,有效规避了以丰度为中心采样的固有偏差,并实现对序列空间的穷尽式探查。初步特征提取与分类在10,000条相对读数丰度严格超过0.01%的精选序列子集上执行。随后,基于k-mer(k = 3)的PCA被用于对该编码特征空间降维,接着用K-means聚类将该序列群稳健地划分为五个不同的拓扑簇。从这五个定义簇中,按比例通过随机选择抽取1,000条序列的中间池。最后,应用凝聚层次聚类分析(HCA)提取130条分支保守序列(图S2)。这130条多样性驱动的候选物与丰度排名前20的测序候选物合并。由此,建立了一个恰好包含149条独特适配体的非冗余基准数据集,作为所有下游分析的坚实基础。无偏、保多样性采样的效果在"结果与讨论3.1"中展示。
【数据】初始子集:10,000条序列;丰度阈值:>0.01%;k-mer:k = 3;聚类数:5个拓扑簇;中间池:1,000条序列;HCA提取:130条分支保守序列;合并top20后总数:149条独特适配体
#### 2.3 特征信息驱动的机器学习分析
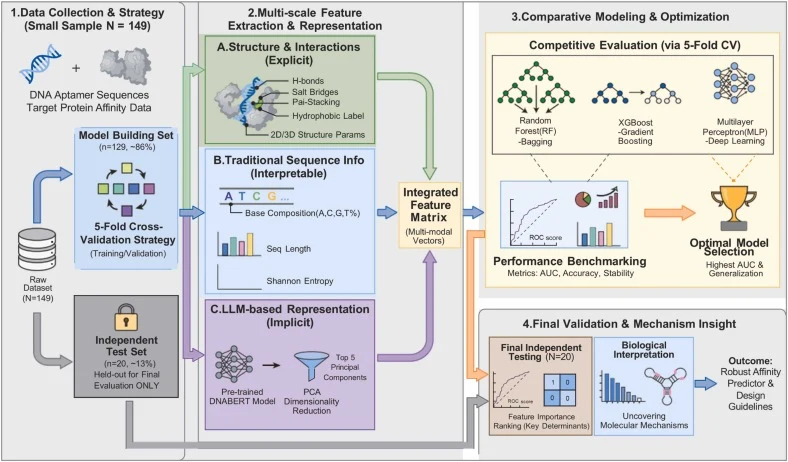
识别适配体结合关键特征的计算流程,包括数据划分、特征融合、模型构建和特征重要性排序,如图2所示。
#### 2.3.1 计算环境设置
所有计算分析均在Python(v3.10.13)中完成。初级序列特征使用Pandas(v1.5.3)和NumPy(v1.24.3)提取。来自预训练DNABERT模型的潜在语义嵌入通过PyTorch(v2.0.1)加载并平均池化,严格作为预训练序列表征而非纯深度学习框架使用。预处理时,理化与结构特征经Z-score标准化(StandardScaler,Scikit-learn),高维DNABERT嵌入通过PCA(Scikit-learn v1.2.2)降至五个主成分(PCs)。
【数据】Python版本:v3.10.13;Pandas版本:v1.5.3;NumPy版本:v1.24.3;PyTorch版本:v2.0.1;Scikit-learn版本:v1.2.2;DNABERT嵌入降维:5个主成分;标准化方法:Z-score
#### 2.3.2 数据集构建与预处理
通过将数据集以约6.5:1的比例划分为训练队列(n = 129)和独立留出测试集(n = 20),严格防止了数据泄漏。虽然从传统机器学习角度看该测试集相对较小,但其质量极高;它并非由嘈杂的、未经验证的序列读数组成,而是包含经体外严格表征了绝对结合动力学的序列。在这一小样本情形下,训练期间实施了分层5折交叉验证策略,以最大化统计稳健性并明确缓解固有的过拟合风险。
【数据】训练集:n = 129;测试集:n = 20;划分比例:约6.5:1;交叉验证:分层5折
#### 2.3.3 三维特征工程与表征学习
构建了一个三维(3D)特征空间,包含三个正交域:
(i)计算推导的显式结构相互作用:利用Protein-Ligand Interaction Profiler(PLIP)平台,从计算机分子对接轨迹中推导出一整套预测性相互作用特征——包括氢键网络、疏水接触、π–π堆积、阳离子–π相互作用和盐桥(表S1)。需要承认,这些描述符代表由对接评分函数引导的计算假设,而非实验解析的物理结构。此外,这些计算推导特征与二级、三级拓扑结构及序列丰度整合后,可比仅基于序列的模型更严格地预测结合界面。
(ii)传统序列指标:提取核苷酸频率分布(A、T、C、G含量)和总体序列长度作为基线描述符。此外,采用Shannon熵严格量化初级序列复杂度,并代理潜在构象景观的热力学多样性。信息熵数学定义为:H(S) = −∑_{i∈Ω} p_i log₂ p_i,其中Ω = {A,T,C,G}表示经典核苷酸字母表,p_i表示第i种核苷酸的相对频率。该信息论指标囊括了初级序列复杂度,作为评估靶标结合特异性与结构可塑性之间热力学权衡的关键参数。
(iii)潜在语义表征:为捕获潜在高阶序列基序和长程依赖关系,部署预训练DNABERT架构提取上下文感知的语义嵌入。采用PCA将复杂序列–注意力特征投影到五个主成分上,这些主成分捕获HSP70与适配体候选物之间分子相互作用的基本结构异质性。该策略缓解了小样本情形下的过拟合,保留了关键结构方差,同时防止高维噪声掩盖显式生物物理描述符。
【数据】特征域数量:3个;相互作用特征类型:氢键、疏水接触、π–π堆积、阳离子–π、盐桥;序列指标:A/T/C/G含量、序列长度、Shannon熵;DNABERT降维:5个主成分;工具:PLIP
#### 2.3.4 机器学习架构与模型选择策略
为识别最适合预测适配体结合亲和力的算法,构建并比较了三种机器学习模型:随机森林(RF)、极端梯度提升(XGBoost)和多层感知机(MLP)。简言之,RF是基于决策树的集成学习算法,通过随机选择样本和特征子集来缓解过拟合。XGBoost是一种梯度提升方法,整合了显式结构正则化以抑制小样本过拟合并动态调整类别不平衡。最后,MLP作为标准人工神经网络基线,用于捕获高度复杂的非线性特征交互,因为刻意避免过于复杂的深度学习架构,以防止在受限样本量下过拟合。实验测定的真实标签通过应用严格的亲和力阈值pKd = 6(对应Kd = 1 μM)来分配。
【数据】模型:RF、XGBoost、MLP;亲和力阈值:pKd = 6(Kd = 1 μM)
研究结果
3.1 数据集建立及序列丰度与结合亲和力的相关性分析
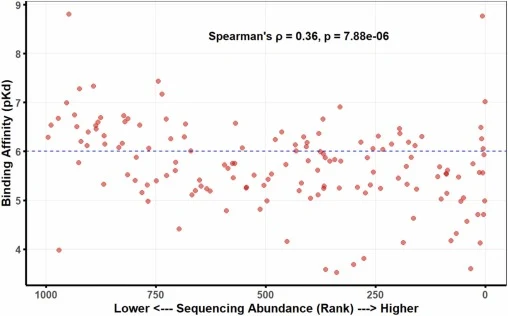
评估包括序列丰度在内的各种因素如何影响亲和力,需要一个适配体池在测序水平上呈良好分布范围的靶标蛋白。HSP70的结构稳定性在NGS数据集中产生了跨越整个丰度谱的独特候选适配体梯度。因此,我们以HSP70为模型靶标,设计了无偏、保多样性的采样策略。尽管是单一靶标,HSP70展现出多功能的表面拓扑结构,提供了丰富的多样结合界面。通过"材料与方法2.2.2"所述采样方法获得的149条适配体候选物,在初级序列、二级拓扑、热力学谱和三级对接特征上表现出深刻的结构异质性,缺乏任何显著聚类,从而保留了内在多样性并确保了对HSP70构象景观的代表性覆盖(图S3)。利用149条无偏采样的适配体序列,我们系统评估了序列丰度作为亲和力指标的有效性。149条序列的结合亲和力通过BLI实验测定(表S1)。如图3所示,散点图表明149条适配体样本在原始丰度排名和结合亲和力方面呈弥散分布,无偏地分布在整个丰度范围内。结果证实序列丰度与结合亲和力之间存在显著但弱的相关性(ρ = 0.36,p < 0.01),表明高频富集并非适配体性能的唯一指标。这一发现促使我们寻找超越序列丰度的、可解释且与适配体对蛋白靶标结合能力强烈相关的关键预测特征。
【数据】适配体候选物:149条;相关性系数:ρ = 0.36;显著性:p < 0.01;亲和力测定方法:BLI
3.2 机器学习模型构建与关键特征提取
#### 3.2.1 交叉验证、模型选择与特征重要性揭示
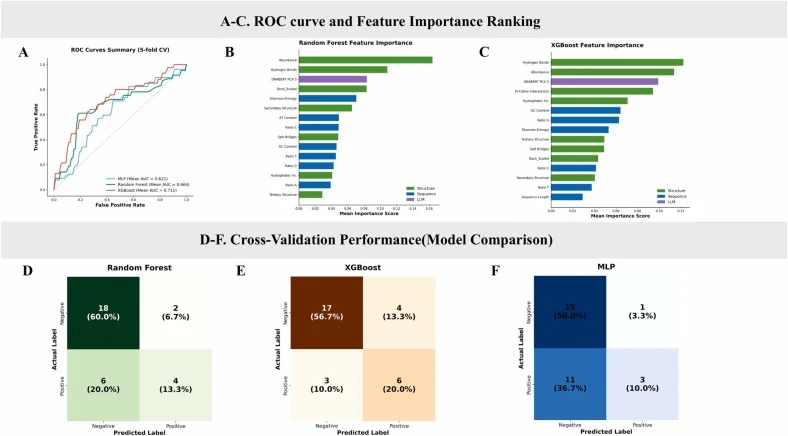
为系统探索这些潜在的高预测性特征,我们利用高保真、结构多样的数据集,整合计算预测的分子相互作用结果(表S1),训练并验证了三种代表性机器学习架构:RF、XGBoost和MLP。如表1所示,XGBoost算法在所评估模型中展现出最均衡的预测性能,有效充当探索性分析工具。XGBoost产生了中等平均AUC为0.711 ± 0.081和F1分数为0.760,优于RF和MLP基线,同时在受限样本情形下保持可靠的算法稳健性。为全面评估模型性能,通过五折交叉验证生成了ROC曲线(图4A)和混淆矩阵(图4D–F)。虽然所有架构均经严格基准测试,XGBoost成为最均衡的框架,优先高置信度预测分层(图4E),相比RF(图4D)和MLP(图4F)有效截断假发现率。关键的是,与传统的仅基于序列的神经网络黑箱架构不同,两种基于树的模型均可作为可解释框架。提取其全局特征重要性揭示了显著一致性:计算推导的氢键、序列丰度和DNABERT PCA 5在两个模型中始终位列前三高权重预测特征(图4B–C)。最值得注意的是,在优化的XGBoost架构中,显式参数化的氢键展现出比序列丰度更高的预测权重,成为与高亲和力适配体识别相关的最突出特征(图4C)。此外,尽管DNABERT衍生的潜在语义特征(PCA 5)缺乏直接的生物物理解释性,其高排名凸显了其在捕获隐藏高阶序列依赖方面的统计效用。这种隐式语义信息有效补充了氢键等显式计算结构特征,共同为生成适配体–蛋白复合化的结构假设提供了稳健的特征信息驱动统计基础。
【数据】XGBoost平均AUC:0.711 ± 0.081;XGBoost F1分数:0.760;交叉验证:5折;top3特征:氢键、序列丰度、DNABERT PCA 5
#### 3.2.2 独立测试集验证与模型性能评估
优化的XGBoost模型随后通过非参数自举法在训练集和独立测试集上评估。如表S2所示,1,000次迭代的非参数自举产生的指标与训练集上五折交叉验证结果高度一致,仅精确率略低。训练和测试AUC值(0.76 vs. 0.75)紧密匹配,共同表明模型稳健且无严重过拟合。需要指出,宽置信区间(如召回率CI:0.25–1.00)诚实反映了小测试样本(n = 20)而非方法学缺陷。虽然整体性能中等(AUC ≈ 0.75),但足以用于探索性机制解释,可靠捕获具有生物学意义的序列–功能关系。
【数据】自举迭代:1,000次;训练AUC:0.76;测试AUC:0.75;召回率CI:0.25–1.00;测试样本:n = 20
#### 3.2.3 特征解释引导的"非典型"适配体表征
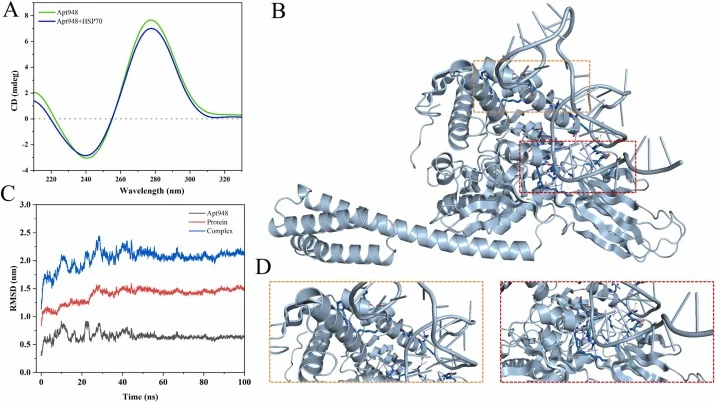
在数据收集阶段,Apt948作为代表性非常规候选物脱颖而出,其特点是尽管序列丰度极低,却具有高结合亲和力。随后的圆二色(CD)光谱实证证实了其稳定的茎环拓扑结构(图5A),而100 ns显式溶剂MD模拟表明HSP70–Apt948复合物的空间骨架波动迅速稳定为刚性平衡平台(图5C)。我们利用PLIP平台(图5D)和原子对接模拟(图5B)在单残基分辨率上解卷积了这些精英候选物的计算预测界面接触。尽管Apt948测序丰度极低,计算预测Apt948可编排密集的界面网络,与HSP70靶标建立23个不同氢键,以及3个疏水接触、1个阳离子–π相互作用和7个盐桥(表S1)。为证实ML模型衍生特征的功能意义,我们对预测的氢键碱基进行了定点突变分析。四个界面残基的单点突变(T10A、A18G、G22A和C36T)导致不同程度的亲和力下降(pKd:7.42、7.55、7.12和7.24),相比Apt948(pKd:8.81)。此外,随着靶向碱基替换数量增加(2、3和4个替换),结合亲和力从8.81逐步恶化至7.19、6.79和6.26。这一直接实证证据确认,计算优先排序的氢键网络在介导高亲和力识别中发挥实质性作用。将这些可解释的计算机相互作用谱与经验指标和突变验证整合,Apt948被选为下游传感器制造和功能概念验证的生物识别元件。
【数据】Apt948 pKd:8.81;单突变pKd:T10A = 7.42、A18G = 7.55、G22A = 7.12、C36T = 7.24;多突变pKd:2替换 = 7.19、3替换 = 6.79、4替换 = 6.26;氢键数:23;疏水接触:3;阳离子–π:1;盐桥:7;MD模拟时长:100 ns
3.3 转化验证:生物传感器的构建与电分析表征
具有可比体外结合亲和力的适配体在整合到实际器件中时,常表现出显著不同的靶标捕获效率。因此,Apt948的分析性能在电化学生物传感框架内进行评估,作为功能性概念验证。本研究旨在确定导致其低读数丰度的固有生物物理因素是否可能 paradoxical地损害其转化可行性,尽管其具有高结合亲和力。
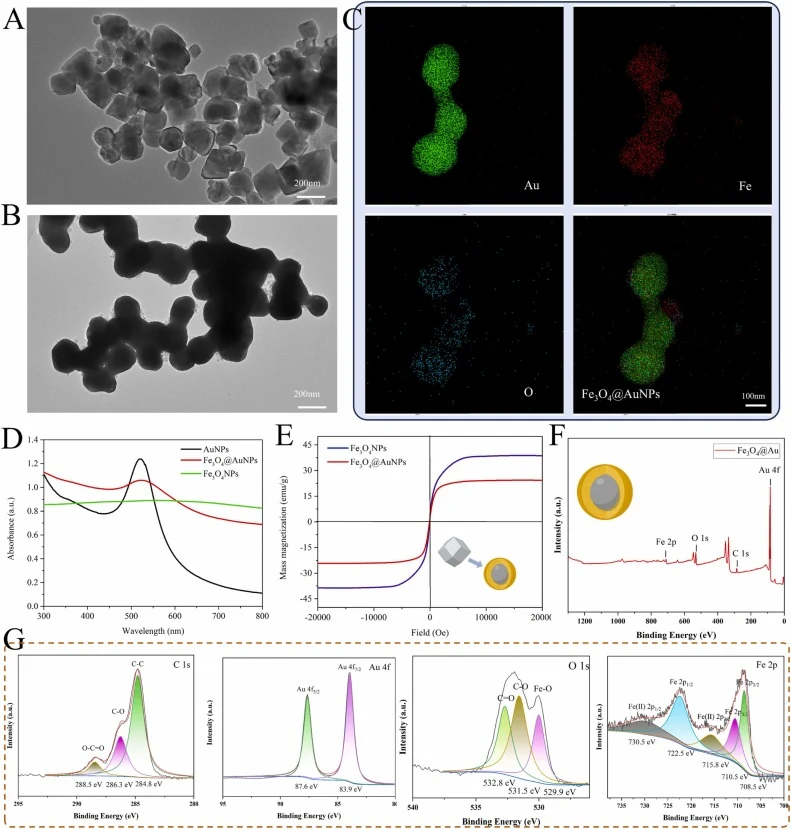
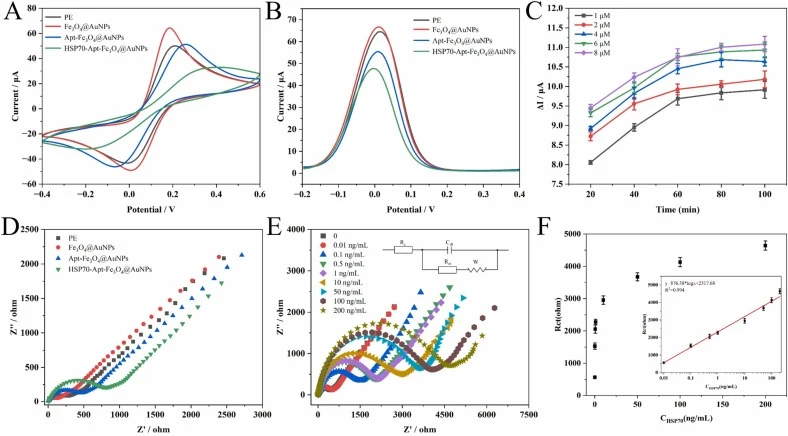
【数据】检测限:2.63 pg/mL(S/N = 3);原文未详述其他电化学表征具体数值
讨论与解读
本研究通过无偏采样策略结合多尺度结构描述符驱动的探索性机器学习框架,解耦了SELEX衍生文库中序列丰度与结合亲和力的经典关系。特征驱动分析表明,计算推导的结构参数——尤其是氢键网络的高预测权重——是与高亲和力靶标识别相关的突出特征,印证了现有结构发现。该策略为推进适配体计算机设计计算方法提供了有价值的视角。当前这些模型主要作为黑箱、数据驱动系统运行,缺乏预测生物物理相互作用的显式表征,这一固有局限造成对训练数据集的强依赖并制约泛化能力。因此,通过优先考虑这些计算生物物理特征而非读数频率,本研究通过整合关于适配体–靶标复合化的可操作结构假设,为计算设计提供了特征信息驱动的统计基础。此外,体外验证表明低丰度候选物不会损害生物传感器的实际性能;相反,其稳健的靶标识别能力可有效补偿传感平台的固有灵敏度局限。
编译者解读:该研究的方法学价值在于将"丰度至上"的SELEX筛选逻辑扭转为"结构特征驱动",用可解释的树模型把氢键网络推到预测首位,并用定点突变做了因果验证——这在适配体发现领域并不多见。局限也很明显:测试集仅20条,AUC约0.75,模型仍属探索性;氢键特征来自对接而非实验结构,存在假阳性风险。对合成生物学而言,该框架提示:适配体设计可先从可解释的生物物理描述符入手,再以少量湿实验闭环验证,从而降低对大规模测序深度的依赖。
参考来源
期刊:Sensors and Actuators B: Chemical, 2026
DOI: 10.1016/j.snb.2026.140519
DOI: 10.1016/j.snb.2026.140519