来源:核糖体展示文库富集差结合洗脱条件(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做核糖体展示筛选,最崩心态的不是没信号,而是富集了两三轮,测序一看还是那批老面孔,甚至野生型背景占了大半。你怀疑文库不行,怀疑靶标没包好,其实大部分问题出在“结合—洗涤—洗脱”这条链上。这篇按实验流程拆开讲,从低级错误到进阶坑,每步都给你判断标准、验证动作和具体参数,照着排一遍,大概率能找到漏点。
第一步:先别急着优化,这几个低级错误最要命
1. mRNA降解了还在往下做。跑个甲醛变性胶,28S/18S带型糊成一片就是RNase污染,直接重提RNA,所有缓冲液换新的DEPC水配。
2. S30提取物反复冻融。翻译效率掉一半以上,复合物数量不够,富集自然差。分装成20 μL一支,-80°C只冻融一次。
3. 洗涤缓冲液忘加去污剂。0.1% Tween-20漏掉,非特异吸附蹭蹭涨。配好当天用,别存超过一周。
4. 洗脱后没立刻中和。低pH甘氨酸洗脱超过2分钟,复合物直接散架,RT-PCR回收率断崖下跌。
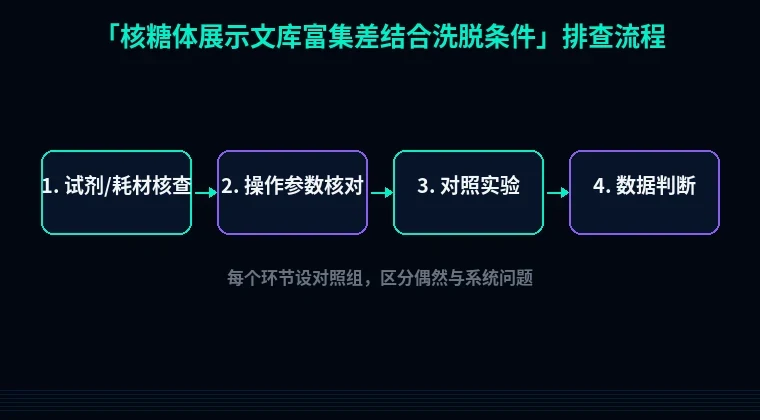
第二步:分维度系统排查,按流程走一遍
1. 复合物形成环节:翻译停得稳不稳
现象:RT-PCR能扩出产物,但每轮回收量逐轮下降,富集曲线不涨。
原理:核糖体展示靠“mRNA-核糖体-新生肽”三元复合物稳定存在,镁离子浓度和温度是命门。
解决步骤:翻译体系里Mg²⁺调到10-15 mM,低于8 mM复合物容易解离,高于20 mM非特异结合明显上升。30°C孵育30分钟,立刻转冰上冷却5分钟终止翻译,别在室温放着。
验证方法:取1 μL翻译产物跑琼脂糖胶,看核糖体大亚基RNA带是否完整;或者用抗His抗体做Western确认展示蛋白存在。
2. 靶标固定化环节:包被密度是隐形杀手
现象:富集一轮后测序,低亲和力克隆占比异常高。
原理:靶标包得太密,多价结合(avidity)会把弱结合子也拉上来,这就是典型的假富集。
解决步骤:96孔板每孔包被100 μL靶蛋白,浓度控制在1-5 μg/mL,4°C过夜。包被完用5%脱脂奶或3% BSA封闭1小时,封闭不充分等于白包。生物素化靶标用链霉亲和素磁珠时,每毫克磁珠载量别超过20 μg靶标。
验证方法:做一组梯度包被(0.5、2、10 μg/mL),比较各浓度下的富集倍数,选信噪比最高的那一档。
3. 结合环节:时间和盐浓度要配套
现象:结合后洗两次就掉光了,回收率低得离谱。
原理:体外翻译产物里残存的高浓度盐和核酸会干扰结合,结合缓冲液盐度不对,复合物根本挂不上靶标。
解决步骤:结合缓冲液用PBS加0.1% Tween-20、5 mM MgCl₂,NaCl控制在150 mM左右。先在冰上预混复合物和缓冲液10分钟,再加到包被板里,4°C孵育1-2小时。室温孵育超过1小时,复合物解离率明显上升。
验证方法:孵育后取上清做RT-PCR,和孔内洗脱产物对比,上清里信号高说明没结合上,回头查靶标包被和缓冲液。
4. 洗涤环节:次数不是越多越好
现象:洗脱产物RT-PCR条带很弱,富集信号发虚。
原理:核糖体复合物对去污剂和剪切力敏感,洗猛了连特异结合子一起丢。
解决步骤:PBST(PBS+0.1% Tween-20)洗3-5次,每次200 μL,轻柔上下吹打3次就弃液,别涡旋。最后一次用PBS洗一遍去掉去污剂。洗涤温度保持4°C。
验证方法:收集每次洗涤液做RT-PCR,如果第2、3次洗液里信号还很强,说明结合本身不牢,问题在前面的包被或缓冲液。
5. 洗脱环节:条件太狠或太温柔都不行
现象:富集差、克隆多样性低,或者洗下来全是背景。
原理:洗脱要打破蛋白-靶标相互作用,又不能把复合物拆散。低pH、高盐、竞争洗脱各有适用场景。
解决步骤:首选竞争洗脱,加10-100 μM游离靶标或对应配体,4°C孵育30分钟,温和且特异。次选低pH洗脱:0.1 M甘氨酸-HCl pH 2.2,洗脱1-2分钟,立刻加1/10体积1 M Tris-HCl pH 8.0中和。高盐洗脱(0.5-1 M NaCl)只适合离子结合型靶标,别乱用。
验证方法:洗脱前后各做一次RT-PCR,算回收率;同时设“空板对照”,空板洗脱产物信号低于特异孔的1/10才算合格。
第三步:进阶疑难,这几个坑老手也翻车
坑一:亲和效应导致“劣币驱逐良币”。靶标多价展示时,低亲和力克隆靠多价结合被富集。解决办法是换用单价靶标(比如Fab片段),或者包被浓度压到0.5 μg/mL以下,逼着高亲和力克隆胜出。
坑二:mRNA二级结构挡住翻译起始。文库5’端UTR形成发夹,核糖体加载不上去,复合物数量少。用MFold预测一下,把起始密码子上游-15到+5区域的ΔG调到-10 kcal/mol以内,或者换用已知高翻译效率的UTR。
坑三:洗脱后复合物已解离。低pH洗脱后不做中和,或者中和缓冲液体积不够,mRNA跟着降解。记住:每100 μL洗脱液加10 μL 1 M Tris-HCl pH 8.0,加完立刻混匀转冰上。
避坑总结+实操建议
三条核心结论:第一,富集差先查复合物完整性和靶标包被密度,这两个占问题的七成;第二,洗涤用3-5次、每次200 μL轻柔操作,别追求“洗得越干净越好”;第三,洗脱优先竞争洗脱,低pH洗脱必须2分钟内中和。
两个日常好习惯:所有接触RNA的缓冲液当天配、当天用,DEPC水现取;每轮筛选固定设空板对照和野生型对照,富集倍数按“特异孔信号/空板信号”算,别只看绝对回收量。
工具用对,少走一半弯路
筛完一轮要测序,引物设计别随手拍——用站内引物设计工具核对Tm和二级结构,避免扩增效率拖后腿。文库构建阶段想做密码子优化提升展示蛋白表达量,直接上密码子优化工具,按大肠杆菌偏好性调一遍。如果靶标是可溶蛋白但包被后老是聚集,蛋白可溶性优化工具能帮你筛一遍突变位点,包被质量上去了,富集特异性自然跟着涨。