来源:蛋白表达沉默密码子偏好优化(DNA Lab Space 实验教程)| 编译:DNA Lab Space
你花两千块做了全序列密码子优化,GC 调了,稀有密码子也换了,合成回来克隆进 pET-28a,转 BL21(DE3),37°C 摇到 OD600 0.6,加 1 mM IPTG,四小时后收菌跑 SDS-PAGE——胶上干干净净,什么都没有。这种“优化了个寂寞”的情况太常见了。这篇教程不管你的优化报告写得多漂亮,直接按克隆→转录→翻译起始→延伸→折叠→检测的流程一步步拆,把每一步能踩的坑和对应的验证动作写清楚,照着做就能定位问题出在哪个环节。
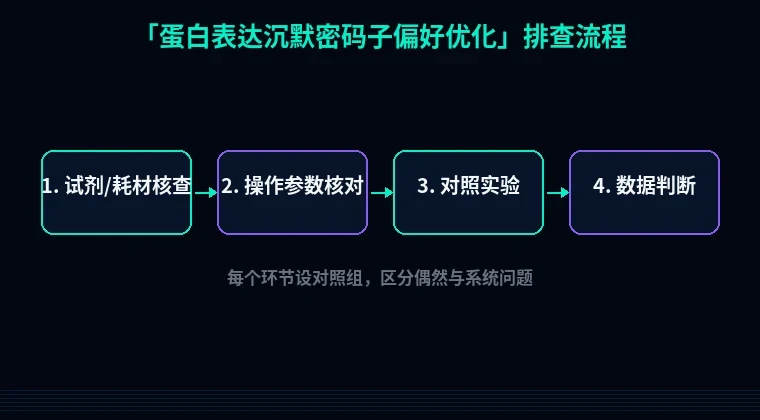
第一步:先排除新手常犯的低级错误
这类问题占实际案例的三成以上,五分钟就能查完,别急着怀疑序列。
1. 宿主菌没带 DE3 感受态。 pET 系列用 T7 启动子,只有 BL21(DE3) 这类带 T7 RNA 聚合酶基因的菌才认它——你用了普通 BL21,等于启动子对牛弹琴。换一管 BL21(DE3) 重新转化,别嫌麻烦。
2. 质粒压根没进菌。 挑单克隆做菌落 PCR,或者提质粒跑 0.8% 琼脂糖胶,看 6–7 kb 的条带在不在。没有带,后面全是白费。
3. IPTG 忘了加或者浓度加错。 1 M 母液冻在 -20°C,1 L 培养基加 1 mL 才到 1 mM。加之前看一眼母液是不是反复冻融成冰碴了,浓度早就不准。
4. 诱导条件选错了。 37°C 摇 4 h 是快表达路线,适合可溶性的小蛋白;膜蛋白或易聚集的直接上 16°C 过夜 16–20 h。别一上来就高温硬冲。
第二步:分维度系统排查
低级错误排掉,问题大概率在序列设计或者翻译过程本身。按流程往下走。
1. 5′ 端 mRNA 二级结构太硬,核糖体滑不进去
现象:优化后起始密码子上游 30 nt 的 GC 含量被算法推到 65% 以上,RNAfold 预测的 ΔG 低于 -15 kcal/mol。原理很直接,30S 亚基需要单链区才能结合,你给 AUG 前面套个发夹,翻译起始效率能掉到原来的十分之一。解决动作:把 5′ 端 30–40 nt 的 GC 压回 40–50%,AUG 前 8 nt 内别出现连续 4 个 G 或 C,保留一个 A/G 富集的单链区。验证:重新跑 RNAfold,看起始区的结构图是否打开,然后合成 2–3 个变体做小规模对比。
2. 优化顺手带进了 SD 类似序列或 Rho 依赖终止位点
现象:序列中段出现 AGGAGG 这类 6 nt 保守区,或者连续 30 nt 里 C 多 G 少。原理:细菌内部 SD 序列会让核糖体在中途重新起始甚至移码,Rho 因子则识别 C 富集、结构松散的 RNA 引发转录提前终止。解决:把优化后的序列丢进在线扫描工具,查 SD 匹配、Rho 位点、正向重复(同向重复超过 20 nt 极易重组)。命中就做同义替换,把 AGGAGG 拆开,把 C 富集段换成 T。验证:换完再扫一遍,同时做个 Northern blot 看转录本长度是不是全长。
3. 稀有密码子簇没清干净,翻译中途卡壳
现象:全长序列显示优化完成,但 50–100 bp 内还挤着 3–4 个 AGG/AGA。原理:E. coli 里这两个 Arg 密码子对应的 tRNA 丰度极低,串排会拖停核糖体,触发 tmRNA 介导的反式翻译,产物直接被标记降解。解决:查密码子使用频率表,把 AGG/AGA 的占比压到 5% 以下;如果蛋白本身富含 Arg,直接换 Rosetta(DE3) 补 tRNAs。验证:同样的质粒转两种菌,各摇 50 mL,SDS-PAGE 并排跑。
4. 不是没表达,是表达完就降解了
现象:上清没有,沉淀里也没有,His 抗体 Western 打不出全长带,倒是能看到 25 kDa 左右的杂带。原理:密码子优化改变的是序列,不改变蛋白酶对蛋白的识别——Lon、ClpP 在 37°C 高表达时活性拉满,N 端规则不稳定的蛋白几分钟就没。解决:培养基里现用现加 1 mM PMSF 和 EDTA-free 蛋白酶抑制剂 cocktail;换 lon/clp 缺陷株;标签从 N 端挪到 C 端再试一版。验证:做 0/1/2/4 h 的诱导时间梯度,看目标带是不是先出现后消失。
5. 检测方法灵敏度不够
现象:低表达量蛋白,考马斯亮蓝染色看不到,但 Western 有微弱条带。原理:CBB 染色单条带检测下限约 100 ng,你的表达量在 10 ng 级别就是看不见。解决:上样量从 10 μL 提到 30 μL,换 10% 胶拉长跑;或者直接上 His-tag 抗体做 Western。验证:做梯度稀释的标准品,把检测线摸清楚再下结论。
第三步:进阶疑难问题
走到这里还没解决,就得往更细的方向看了。
1. 优化改变了 mRNA 半衰期。 5′ 端序列重排可能暴露 RNase E 的切割位点,转录本在翻译前就被切了。做法:取 3 个 5′ 端同义密码子变体,各做 50 mL 小摇,加 IPTG 后 0/5/15 min 取 1 mL 菌液加两倍体积无水乙醇终止,提取 RNA 跑 Northern,看全长转录本存活多久。
2. 优化只对齐了“大肠杆菌偏好”,没看等位 tRNA 缺失。 BL21 本身缺几种稀有 tRNA,单纯按频率表优化不代表 tRNA 够用。做法:查你目标宿主的具体 tRNA 拷贝数,或者直接换补给株对比。
3. 膜蛋白和毒性蛋白的特殊性。 密码子没问题,表现却是表达即沉淀、或者表达后菌不长。做法:16°C 诱导,培养基加 1% glucose 压住泄漏表达,诱导前把菌冰浴 10 min 再降温摇。
避坑总结 + 实操建议
三条核心结论:全序列优化不等于万事大吉,5′ 端 40 nt 和内部稀有密码子簇要分开调;优化完一定要扫 SD 序列、Rho 位点、限制性位点和正向重复,再下单合成;沉默不等于没表达,先做 Western 再下结论。
两个日常习惯:每个质粒留一支 -80°C 甘油菌,别每次现转;诱导永远做时间梯度(0/2/4/8 h),别只盯 4 h 一个点。
工具在这,直接用
序列到手先跑一遍密码子优化工具,把 5′ 端 GC 和稀有密码子分开设参数;克隆前用引物设计工具核对读框和酶切位点;蛋白表达前拿蛋白可溶性优化工具预测一下聚集倾向,再决定诱导温度。工具不是替你做实验,是帮你少踩两个坑。