来源:CRISPR编辑脱靶全基因组测序验证(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做完全基因组脱靶测序,候选位点列了两百多个,Sanger一验,全阴。或者反过来,明明编辑效率挺高,脱靶列表干净得像没做过编辑。这两种情况都让人头大。这篇按"低级错误—流程分段—进阶疑难"三层拆,覆盖从gDNA提取到变异过滤的9个排查点,每个点给你具体参数和验证动作。照着走一遍,大概率能找到问题卡在哪。
第一步:先别怀疑建库,这4个低级错误占了一半的锅
1. 参考基因组版本对不上。 你拿hg19注释的bed文件去call GRCh38比对出来的bam,坐标整体偏移,候选位点全是假的。解决:全流程统一到GRCh38,bam、bed、dbSNP版本三者对齐,重比对一次只要30分钟。
2. gDNA已经降解了。 A260/280低于1.7、琼脂糖胶上出现拖尾,建库后重复序列区域覆盖度直接塌方。解决:重新提gDNA,至少5 μg,1%琼脂糖胶100 V跑40分钟看主带是否锐利。
3. 测序深度根本不够。 WGS脱靶检测低于100×,0.1% VAF的位点压不住背景噪声。目标区域测序建议≥200×,低频脱靶事件≥500×。别拿30×的WGS数据硬找脱靶。
4. 样本标签贴反了。 编辑组里检出的"脱靶"在对照组同样高,八成是样本搞混。解决:先跑10个SNP位点的指纹比对,确认样本身份再往下分析。
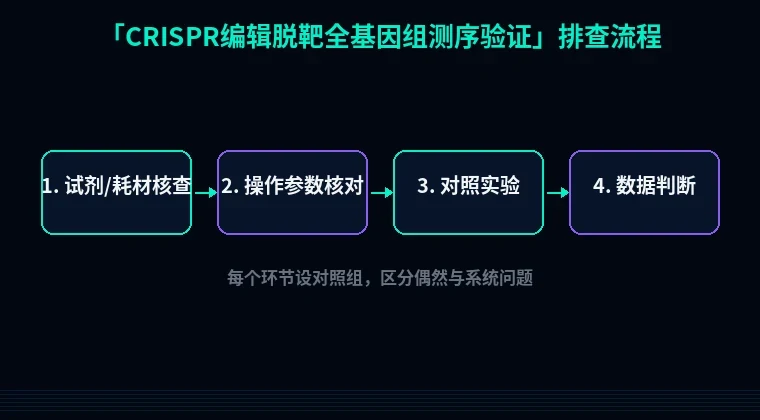
第二步:按实验流程分四段查,别一上来就怪生信
1. sgRNA设计与脱靶预测参数(设计端)
现象:预测工具给出的高分脱靶位点一个都没验到,实际却冒出一批新位点。
原理:Cas-OFFinder默认按SpCas9的NGG PAM、20 nt spacer、允许3个错配来搜。你如果用的是SpCas9-VQR变体,PAM是NGA,还按NGG搜,漏检是必然的。
解决步骤:①确认你用的Cas变体——SpCas9认NGG,SpRY认NRN/NYN,SaCas9认NNGRRT;②错配数放宽到4-5,bulge size设2;③CRISPOR和Cas-OFFinder两个工具交叉跑,取并集。
验证方法:并集里排名前20的位点必须全部进验证panel,漏掉一个就回头改参数重跑。
2. gDNA质量与建库偏好(样本端)
现象:脱靶位点覆盖度忽高忽低,GC-rich区域掉到20×以下。
原理:gDNA片段化不均匀加上PCR扩增偏好,高GC区域建库效率低,低频变异直接被"抽干"。
解决步骤:①gDNA超声打断到300-500 bp;②起始量1 μg,KAPA HyperPrep建库,扩增循环数压到8以下;③加UMI接头,每个原始分子至少3条一致reads。
验证方法:Agilent 2100看插入片段主峰在350 bp左右,qPCR测文库浓度,峰形拖尾就重建。
3. 测序读长与比对(测序端)
现象:同一脱靶位点在生物学重复之间方向不一致,一会儿检出,一会儿消失。
原理:PE75读长跨不过重复序列或同源区域,reads被强行比对到多个位置,MAPQ很低。
解决步骤:①上PE150;②BWA-MEM加-M参数标记split hit;③GATK MarkDuplicates去重。
验证方法:IGV里打开该位点,MAPQ<20的reads占比超过30%,这段数据就别用了,重测。
4. 变异检出与背景过滤(分析端)
现象:候选脱靶列表几百个,Sanger验证全阴,假阳性率超过80%。
原理:没做配对背景过滤,把germline SNP和测序错误一起收了进来。
解决步骤:①拿同批次未编辑对照做配对过滤,Mutect2加--normal参数;②去掉dbSNP和1000G里登记的germline变异;③只保留VAF≥0.1%且支持reads≥5的位点;④去掉链偏好明显的位点(正负链支持比超过3:1)。
验证方法:随机抽10个位点做扩增子测序,符合率低于70%就回头调过滤阈值。
第三步:三个进阶坑,数据看着对但结论站不住
1. 低频脱靶淹没在测序错误里。 VAF在0.01%-0.1%的位点,Q30下测序错误率本身就有0.1%,分不清是编辑还是噪声。解法:UMI建库、深度拉到500×、用CRISPResso2跑,再拿未编辑对照看同样位点的背景噪声分布。背景噪声里也出现的峰,一律不算。
2. 大片段缺失和结构变异漏检。 常规SNV pipeline只call点突变,2 kb以上的缺失、倒位、易位完全看不见。解法:GRIDSS或CREST单独跑结构变异,候选断点用ddPCR验证——跨断点探针、1 ng模板、58°C退火30秒。别只盯SNV列表。
3. 嵌合克隆与等位基因脱落。 编辑效率算出来60%,脱靶VAF却稳定在30%,很可能是混合克隆。解法:96孔板有限稀释挑单克隆,每个克隆单独提gDNA跑靶向测序。等位基因脱落多发生在SNP附近引物错配,设计引物时避开±50 bp内的SNP位点。
避坑总结
- 脱靶验证假阳性容易、假阴性更容易。深度、对照、正交验证,三件事缺一不可。
- 生信列表再漂亮,没有Sanger或扩增子测序兜底,别写进文章。
- 低频事件靠UMI,结构变异靠专门caller,一套pipeline打天下必翻车。
两个日常习惯:每次建库留一份gDNA备份在-80°C,出问题能回溯;每个编辑样本配一个同批次未编辑对照,同lane上机,背景过滤才有依据。
工具衔接
动手前先用站内sgRNA设计工具跑一遍,把脱靶预测列表直接导出,省得在两个网站之间来回倒坐标。验证脱靶位点要设计扩增引物,用引物设计工具按Tm 60±2°C、产物150-250 bp筛,避开SNP密集区。做HDR修复模板的话,顺手用密码子优化工具调整同义突变,别让修复模板自己带出一个新PAM,凭空多出一批脱靶。