来源:核酸定量偏差大荧光染料饱和(DNA Lab Space 实验教程)| 编译:DNA Lab Space
同一个样本,Qubit读数一会儿380 ng/μL,一会儿610 ng/μL;稀释10倍再测,按理该是38,结果算出65。你怀疑样本降解,其实大概率是荧光染料饱和了。核酸定量的坑,八成不在样本,在体系和读数。这篇教程按操作流程拆成三个层级:先扫低级错误,再分模块系统排查,最后讲几个进阶疑难。带上你的数据,我们一步步对。
第一步:快速排查低级错误
新手翻车,常常栽在这四个地方。
1. 上样体积凭手感。 2 μL样品加198 μL工作液,用普通吸头打2 μL实际可能只有1.4 μL,误差直接30%。换低吸附吸头、贴壁加样、每管换枪头。
2. 标准品没回温没混匀。 从4°C直接取出就加,标准品黏、密度大,沉在管底。室温平衡10 min,涡旋10 s,快速离心5 s再用。
3. 孵育时间不统一。 dsDNA HS要求室温避光5 min,BR只需2 min。样本和标准品必须同一时刻起算,别一批测完再补标准品。
4. 读板孔里有气泡、底板有指纹。 气泡散射光,指纹吸荧光。1000 rpm离心1 min破泡,无尘纸擦干底板再读。
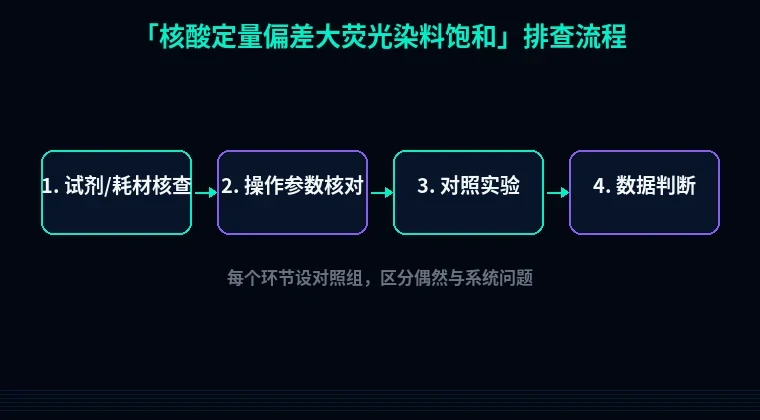
如果这四步都排掉了,读数还是漂,别急着怀疑样本。往下面走。
第二步:分维度系统排查
1. 上样量超出染料线性范围(饱和的头号原因)
现象: 高浓度样本稀释后测值不按比例下降,原液测800 ng/μL、10倍稀释测出120 ng/μL(理论80)。低浓度端正常,高浓度端压平。
原理: 荧光染料与双链DNA按一定化学计量结合。体系内染料分子数有限,当dsDNA总量超过染料的结合容量,多余的DNA没有染料可结合,信号不再随浓度线性上升,曲线在高浓度端走平——这就是饱和。Qubit dsDNA HS的线性上限约100 ng/管(对应2 μL上样时约50 ng/μL),BR约1000 ng/管。PicoGreen在1 μg/mL以上开始偏离线性。
解决步骤:
1. 查浓度区间。gDNA/质粒按10 mM Tris-HCl (pH 8.0) 稀释成1 ng/μL、5 ng/μL、20 ng/μL三个梯度。
2. 每个梯度各取2 μL进样,与198 μL工作液混匀,室温避光5 min。
3. 选读数落在标准曲线中段(约1–50 ng/μL)的那一档作为报告值,乘以稀释倍数。
4. 报告时注明稀释倍数和实测值,别只写最终浓度。
验证方法: 做加标回收。取10 μL样本加10 μL已知浓度的标准DNA(如20 ng/μL),测总量,回收率应在90–110%。低于85%基本可以判定饱和或基质抑制。
2. 标准品浓度选错、标准曲线不覆盖样本
现象: 标准曲线R²漂亮(0.999),但样本读数全部堆在曲线最顶端或最底端。
原理: 荧光定量是相对定量,必须用同类型标准品(dsDNA HS用λDNA标准)。曲线只在其覆盖区间有效,外推就是瞎猜。
解决步骤:
1. 先跑一次粗测,知道样本大概落在哪个数量级。
2. 选覆盖该数量级的试剂盒(0.2–100 ng/管用HS,100 ng–1000 ng/管用BR)。
3. 标准品按说明书梯度稀释,每档至少200 μL,涡旋10 s。
4. 每批实验重做标准曲线,别复用上周的。
验证方法: 曲线斜率正常、空白孔荧光值低于最低标准品的10%。空白偏高说明工作液污染或管子有荧光背景。
3. 染料工作液配制与存放
现象: 整板荧光普遍偏低,标准品和样本同步偏低,重复性差。
原理: 染料工作液按1:200现配,室温避光。反复冻融、见光久置会让染料聚沉或光漂白,有效浓度下降,饱和阈值前移。
解决步骤:
1. 现配现用,配好2 h内用完。
2. 母液分装成10 μL小份,−20°C避光,冻融不超过3次。
3. 配液用低吸附管,涡旋10 s,别用力振荡起泡。
4. 计算好用量:每管200 μL,N个样本加2个标准品再加1个余量。
验证方法: 新配工作液测同一份20 ng/μL标准DNA,读数应在标示值的±10%内。偏差大就换新染料。
4. 样本基质干扰:残盐、去污剂、蛋白
现象: 同一样本Qubit与NanoDrop差2倍以上,或加标回收率只有60%。
原理: SDS、Triton、胍盐、酚红、血红素都会淬灭荧光或改变染料结合;蛋白和RNA会造成非特异结合,读数偏高。
解决步骤:
1. 检查上游裂解液。含SDS或Triton的样本,用0.1×TE或纯水稀释10倍以上再测。
2. 柱纯化样本残留胍盐,多洗一次,或乙醇沉淀后重溶。
3. 做平行对照:一管样本+工作液(不加染料),读背景荧光,超过标准品最低值3倍就要处理样本。
验证方法: 梯度稀释法。样本稀释2、5、10、20倍分别测,若各稀释度换算回原浓度一致(CV<15%),基质干扰可忽略;一路走高说明还在抑制。
5. 仪器与耗材读数误差
现象: 同一管样品换孔测,数值差20%以上。
原理: 荧光仪的光路、孔底材质、边缘孔蒸发都会引入偏差。微量板边缘孔蒸发快,5 min内体积可少5%。
解决步骤:
1. 用黑色不透明板,避免串扰和自发荧光。
2. 样本不要放最外圈孔,外圈加200 μL水做湿度屏障。
3. 每管做2个复孔,取均值,复孔CV>10%重做。
4. 读板前1000 rpm离心1 min,读板时盖膜。
验证方法: 复孔一致性、同一样本不同孔位测值CV<10%。
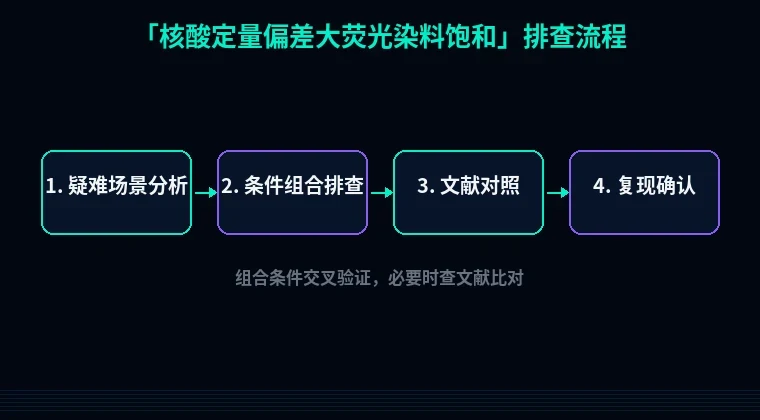
第三步:进阶疑难问题
一、样本自发荧光强,读数虚高却与核酸量无关。 组织裂解液含NADH、黄素、血红素,激发480 nm也有发射。做法:设"样本+无染料缓冲液"对照孔,从样本孔读数中扣掉该背景。若背景占信号30%以上,改走乙醇沉淀或柱纯化。
二、极微量样本(<1 ng/μL)吸附损失。 0.2 mL普通管壁会吸附几纳克DNA,低浓度样本读数随机漂。用低吸附管、加0.05% Tween-20、孵育时间压到3 min内,能明显改善。
三、Qubit与NanoDrop打架,到底信谁? A260受RNA、游离核苷酸、蛋白干扰,Qubit只认双链DNA。差值大时先看A260/A280:1.8左右且Qubit低于NanoDrop,信Qubit;比值1.5以下说明蛋白污染,两个都别全信,先纯化。
避坑总结+实操建议
三条核心结论:
1. 饱和不是样本的问题,是上样量的问题。 读数高于50 ng/μL(HS体系,2 μL上样)就稀释,别硬测。
2. 标准曲线必须和样本同批、同区间。 跨批复用曲线,等于给自己埋雷。
3. 每个可疑结果做一次加标回收。 回收率90–110%以外,先查基质和饱和,别急着报数据。
两个日常好习惯:
- 建一张"定量记录卡":样本名、稀释倍数、实测值、复孔CV、回收率,一栏不缺。出问题时倒查三天就能定位。
- 每批新染料、新试剂盒开启前,先跑一份20 ng/μL标准DNA做"体检",读数偏差超10%全批重配。
顺手把下游也排干净
定量准了,下游才不白干。要克隆表达,先用站内引物设计工具核对Tm和GC,避免二聚体拖垮PCR;做异源表达,用密码子优化工具按宿主偏好调序列;蛋白老是跑进包涵体,就上蛋白可溶性优化工具,从标签、启动子到促溶条件一起调。定量只是起点,工具帮你把后面几步走直。