来源:转录组测序文库QC失败(DNA Lab Space 实验教程)| 编译:DNA Lab Space
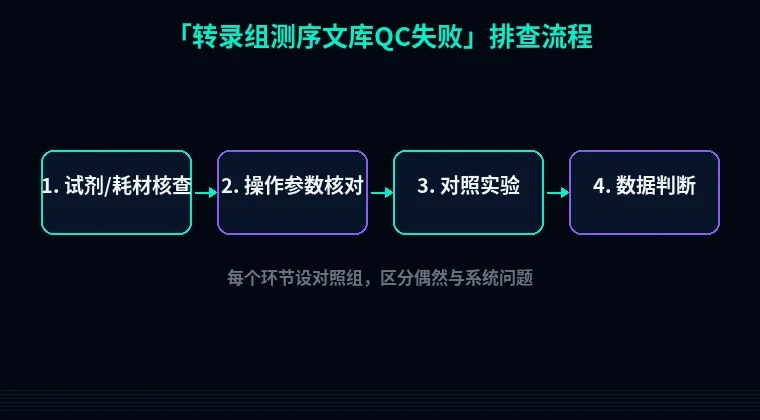
RNA-seq文库QC亮红灯,是不是第一反应想重做?先别急着扔样本。Agilent 2100上出现132 bp杂峰、Qubit浓度0.8 ng/µL、qPCR定量比Qubit低5倍——这些信号背后原因完全不同,处理方式也差得远。本文按"先排低级错误,再拆建库流程,最后攻疑难杂症"三步走,帮你把建库失败定位到具体某一步,少浪费一个月的样本和时间。
第一步:快速排查低级错误
三个新手高频翻车点,五分钟就能排除。
1. Qubit测的是DNA,不是RNA文库。如果你在PCR后测浓度却用了RNA BR试剂盒,读数会虚高2-3倍。换DNA HS试剂盒,2 µL样本+198 µL工作液,室温孵育2分钟再读。
2. 磁珠比例记反了。0.8× AMPure XP留着大片段,1.2×才抓小片段。PCR后纯化想要去掉接头二聚体,用1.0×;如果要保留短插入片段(<200 bp),降到0.6-0.8×。比例错,片段分布全乱。
3. Bioanalyzer芯片上样量过载或不足。DNA HS芯片最佳上样1 ng/µL,你给到10 ng/µL会拖尾,给到0.1 ng/µL出峰不全。用TE稀释到1-2 ng/µL再上样,上样前70°C变性2分钟冰浴。
第二步:分维度系统排查
按建库流程从RNA到最终文库,逐模块查。
1. RNA起始质量不合格(RIN < 7)
现象:文库复杂度低、dup率高、5'/3'偏好严重。取1 µL RNA跑Bioanalyzer,RIN值6.2,28S/18S峰比1.0以下。
原理:降解RNA几乎全是短片段,poly(A)富集时oligo(dT)抓不到完整3'端,反转录出来的cDNA全是截断的。RIN每降1,下游检测到的基因数掉15%-20%。
解决:RNA提取改用柱式法+DNase I柱上消化,别用Trizol上清的 aqueous phase 反复吸。组织样本液氮研磨后立即加裂解液,别等。RIN低于7直接换样本,别硬上。
验证:Agilent 2100看RIN和28S/18S,同时NanoDrop A260/A280在1.9-2.1,A260/A230 > 2.0。
2. poly(A)富集或rRNA去除不彻底
现象:rRNA占比>20%,或mRNA富集后产量<50 ng。Qubit测富集产物只有8 ng,理论应该100-300 ng。
原理:oligo(dT)磁珠结合mRNA的poly(A)尾。如果RNA有大量二级结构或盐浓度高,结合效率暴跌。rRNA去除法则依赖探针杂交,探针量不足会漏掉部分rRNA。
解决:poly(A)富集时,RNA先65°C变性5分钟再冰浴,结合缓冲液NaCl调到0.5 M。磁珠用前室温平衡30分钟,别从4°C直接拿。rRNA去除试剂盒严格按input 100 ng-1 µg,低于100 ng探针比例失衡。
验证:富集后取1 µL跑Qubit,产量应在起始RNA的1%-5%。rRNA去除后用Bioanalyzer看18S/28S峰是否消失。
3. 反转录与二链合成效率低
现象:cDNA产量<10 ng,或片段集中在200-500 bp但缺少全长。qPCR定量显示文库浓度比Qubit低3-8倍。
原理:反转录酶被RNA二级结构卡住,或dNTP浓度不足。二链合成时RNase H切割不充分,导致二链不完整。接头连接效率直接取决于cDNA末端是否平整。
解决:反转录用SuperScript IV,50°C孵育15分钟(别用42°C),加5% DMSO打散二级结构。二链合成后必须用1.8× AMPure XP纯化,去掉酶和dNTP。末端修复用T4 DNA聚合酶+PNK,20°C 30分钟。
验证:取2 µL cDNA跑琼脂糖胶,应有200-2000 bp弥散带。Qubit定量应>20 ng。
4. 接头连接与PCR扩增异常
现象:Bioanalyzer出现132 bp接头二聚体峰,或文库主峰<250 bp。qPCR定量CT值>18,说明文库浓度过低。
原理:接头与cDNA摩尔比失衡。cDNA < 5 ng时,接头过量10倍以上,二聚体大量形成。PCR循环数过多(>12)则引入偏好,循环数过少产量不足。
解决:接头连接前精确Qubit定量cDNA,接头:cDNA摩尔比控制在100:1。连接后必须用0.8× AMPure XP去除未连接接头。PCR循环数按input定:100 ng RNA起始用10-12循环,10 ng起始用13-15循环。别超过15。
验证:连接后取1 µL跑Bioanalyzer,二聚体峰应<5%。PCR后用qPCR定量,CT值在8-14之间合格。
5. 文库片段分布异常
现象:主峰180 bp(接头二聚体),或主峰>1000 bp(插入片段过大),或双峰。
原理:片段化时间/温度不对。RNA片段化用金属浴,94°C 8分钟得300-400 bp插入片段。时间每多1分钟,片段小50-80 bp。
解决:片段化严格计时,94°C预热2分钟后再放样本。片段化后立即冰浴。如果主峰偏小,纯化时用0.6× AMPure XP去掉小片段。偏大则用1.2×磁珠回收。
验证:Bioanalyzer HS DNA芯片,主峰应在300-500 bp(含接头),对应插入片段250-400 bp。
6. qPCR与Qubit定量不一致
现象:Qubit读8 ng/µL,qPCR读1.5 nM,换算后差5倍。
原理:Qubit测总DNA,包括单链、RNA残留、接头二聚体。qPCR只测两端接头完整的可扩增文库。比值<2说明文库质量差,>5说明有大量不可扩增片段。
解决:qPCR用KAPA Library Quantification Kit,标准品做6个稀释点。Qubit/qPCR比值应在2-4之间。如果<2,重新纯化文库;如果>5,检查接头连接效率。
验证:两个定量结果换算成nM后比值在2-4,上机浓度按qPCR结果算。
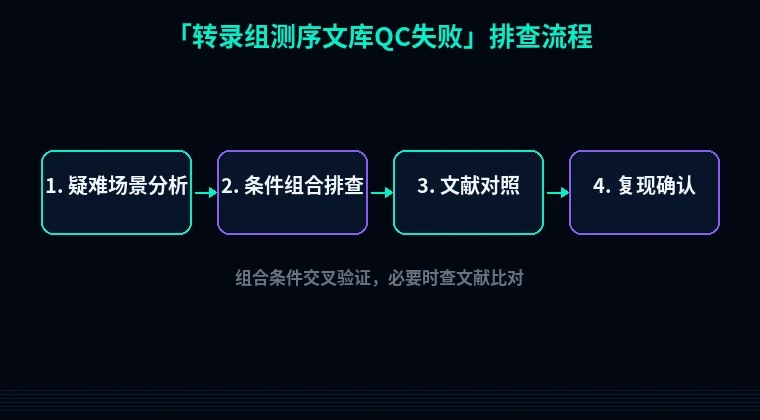
第三步:进阶疑难问题
1. 文库复杂度低但浓度正常
Qubit 15 ng/µL,qPCR 12 nM,看起来能上机。但测序后dup率45%,检测到的基因只有8000个。这种情况大概率是PCR循环数过多,或起始RNA量太低(<10 ng)。建库时PCR循环降到8-10,起始RNA提到100 ng以上。上机前用qPCR测定文库复杂度,别只看浓度。
2. 接头二聚体去除后浓度不够
0.8×磁珠纯化去二聚体,结果文库浓度从10 ng/µL掉到0.5 ng/µL。说明原始文库中二聚体占80%以上。回退到接头连接步骤,减少接头用量至50:1摩尔比,连接时间从15分钟延到30分钟。如果还是不行,换用含独特分子标签(UMI)的接头,连接效率更高。
3. 不同批次文库QC结果波动大
同一RNA样本建两次库,一次主峰350 bp,一次主峰220 bp。查片段化模块温度是否校准,金属浴实际温度可能偏差5°C。用温度计校准,或改用片段化试剂盒(如NEBNext FS)。磁珠使用前充分涡旋30秒,别让磁珠沉降。批次间差异超过20%就要查操作一致性。
避坑总结+实操建议
三条核心结论:
1. RIN < 7的RNA直接换样本,别试图用增加PCR循环数补救,dup率会教你做人。
2. 接头连接前必须Qubit精确定量cDNA,摩尔比算错是二聚体的第一元凶。
3. qPCR定量才是上机依据,Qubit只能参考。两者比值<2就重新纯化,别抱侥幸心理。
两条日常好习惯:
- 每次建库前用同一批RNA跑一次Bioanalyzer,记录RIN和28S/18S,建库后对照。
- 磁珠使用前室温平衡30分钟并涡旋,别从4°C直接吸。
文库QC失败不可怕,可怕的是不知道哪一步出的问题。从RNA质量到qPCR定量,六个模块逐项过,90%的问题能定位。剩下10%的疑难杂症,多半是操作一致性和试剂批次问题,换试剂、校准设备、严格计时,基本能解决。
需要设计测序引物或优化建库接头序列?站内引物设计工具支持批量输入模板,自动输出Tm和二级结构预测。做蛋白表达的话,密码子优化工具能按大肠杆菌、酵母、哺乳动物偏好调整序列。蛋白可溶性优化模块提供标签选择和折叠伴侣推荐。建库前先跑一遍工具,少走弯路。