来源:微量核酸定量偏差荧光染料(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做微量样本的人都有过这种经历:同一管 RNA,NanoDrop 读出来 80 ng/µL,Qubit 却只给 25 ng/µL;或者前一天 R² = 0.999,今天标准曲线直接掉到 0.97。样本就那么点,测一次少一次,重测等于报废。问题多半不在仪器,而在样品状态、染料反应体系和操作细节这三块。下面按"先查低级错误、再按流程分模块、最后啃疑难杂症"的路径走一遍,每一步都给判断方法和验证动作。荧光染料法定量(Qubit、PicoGreen、RiboGreen、OligoGreen 这一类)本质是"染料结合量 → 荧光强度 → 浓度",链路上任何一环被干扰,读数就会漂。往下看,对号入座。
第一步:先查这几个低级错误,别急着怀疑试剂
1. 标准品和样品"不同类"。 拿 λDNA 标准曲线去定量 50 bp 的小片段或质粒,读数偏低 30%–60% 是常事。换与样品同类型、同片段长度的标准品,或者至少做双点校准。
2. 孵育时间和避光没做对。 Qubit 工作液要求室温孵育 2 分钟,PicoGreen 类要避光 5 分钟。孵育 30 秒就读数,荧光还没稳定,读数能差 20%。
3. 样品体积低于有效下限。 加样量少于 1 µL,移液误差直接被放大成浓度误差。低于 0.5 ng/µL 的样品,取 1 µL 已经踩在检测下限上,数据不可信。
4. 枪和吸头。 吸头挂壁、有气泡、枪半年没校准,1 µL 实际吸 0.8 µL。用称重法查一次移液准确度,超差 5% 就送校。
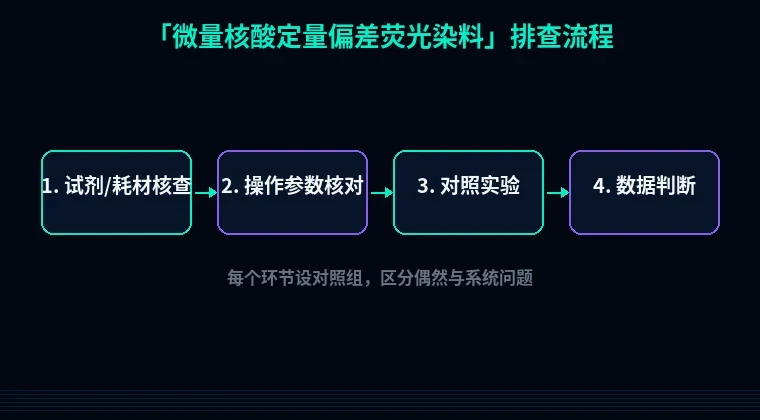
这四个查完,八成的"离奇偏差"就没了。剩下两成,往下走。
第二步:按实验流程分模块系统排查
模块A:样品本身的问题
1. 片段长度与染料偏好不匹配
现象:Qubit 读数系统性低于 NanoDrop 的 A260 换算值,两者差 2 倍以上。
原理:PicoGreen 是嵌入型染料,必须插进双链碱基对之间才发光。小于 50 bp 的片段、单链 DNA、降解成小碎片的 RNA,结合位点少,响应被严重低估。而 A260 只算碱基摩尔数,不管有没有双链结构。
解决:短片段和单链样品改用 OligoGreen 或 Qubit ssDNA 试剂盒;RNA 样品用 RiboGreen 而不是 PicoGreen。
验证:拿一段已知浓度的 50 bp 双链 oligo 掺进待测样品做加标回收,回收率落在 85%–115% 才说明定量准。
2. 残留污染物淬灭荧光
现象:同一样品稀释 10 倍后测,乘以稀释倍数反而比原液读数高——典型的基质干扰。
原理:胍盐(异硫氰酸胍)、酚、SDS、EDTA 都会淬灭荧光或改变染料结合。胍盐浓度超过 10 mM 就开始压信号,而 RNA 提取的洗脱液里胍盐常见几十到上百 mM。
解决:样品基质换成 TE(10 mM Tris-HCl,1 mM EDTA,pH 8.0),或者乙醇沉淀后重溶。实在不能换,至少稀释 10 倍再测。
验证:设"样品 + 缓冲液不加染料"的空白孔,扣除本底荧光;同时做纯水稀释 vs 原基质稀释的平行对比。
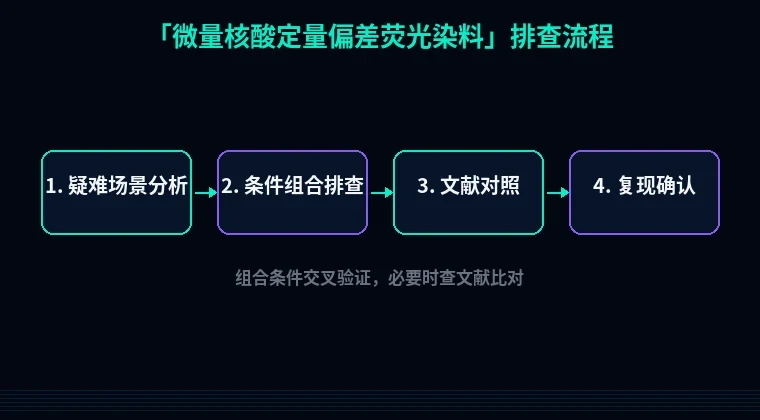
模块B:反应体系配置问题
3. 样品与工作液比例失衡
现象:为了省样品只加 0.5–1 µL,重复测三次读数跳动超过 30%。
原理:Qubit 体系要求样品 1–20 µL 加工作液补足到 200 µL,比例固定,染料浓度才是过量且一致的。样品体积太小,一是取样误差占比大,二是体系染料/核酸比例被改写,标准曲线不再适用。
解决:最低取 5 µL;样品实在太金贵,用低体积专用检测管,或者干脆改用 qPCR 绝对定量。
验证:同一管样品分别取 1、5、10、20 µL 测四个平行,读数换算成浓度后应一致,偏差 >15% 说明取样体积不可靠。
4. 样品 pH 偏酸
现象:样品溶于无缓冲纯水(pH 5.5–6.0),荧光值比溶于 TE 的同样品低一截。
原理:多数荧光染料的最适 pH 在 7.5 左右,酸性条件下染料质子化,结合能力下降。
解决:洗脱和稀释统一用 TE pH 8.0。已经溶于水的样品,加 1/10 体积的 10× TE 调 pH。
验证:同一份样品分装两管,一管加水、一管加 TE,同时测,差值就是 pH 贡献。
模块C:仪器与读值环节
5. 管材和板材质不对
现象:空白孔读数就有 0.5 以上,标准曲线低端点全被顶掉。
原理:普通 PCR 管和聚苯乙烯板自带荧光背景,某些材质在 480 nm 激发下自发荧光明显。
解决:Qubit 用原厂低荧光薄壁管;板式读数用黑色不透明板,孔间不留空孔以防串扰。
验证:加 200 µL 工作液到空管读一次,背景应低于最低标准点的 10%。
6. 样品超出标准曲线范围
现象:高浓度样品读数被"封顶",稀释后才正常。
原理:超出最高标准点后,荧光与浓度不再线性,读数只是平台值。
解决:先估浓度,把样品稀释到曲线中段(比如 0.5–5 ng/µL)再测。高浓度样品(>100 ng/µL)还有内滤效应,激发光被自身吸收,读数反而偏低,必须稀释 10–100 倍。
验证:同一个高浓度样品做 1:10、1:100 两个稀释,换算回原浓度应吻合。
第三步:进阶疑难,专治"怎么测都不对"
1. 单双链混合样品(cDNA 合成产物、体外转录产物)
PicoGreen 只认双链,ssDNA 响应只有双链的 0.1–0.3 倍,你测到的是"双链当量",不是总核酸量。做法:分别用 OligoGreen 和 PicoGreen 各测一遍,差值反推单链量。要绝对准确,就上 qPCR 用已知拷贝数标准品定值。
2. 样品自带荧光物质
酚红、溴酚蓝、残留的 SYBR Green 都会抬高本底。现象:标准曲线正常,但样品孔读数偏高且不随稀释线性下降。解法:每个样品配一个不加染料的自身空白孔,读数相减。如果空白孔就很高,样品必须纯化。
3. 工作液反复冻融导致染料聚集
现象:试剂用了一个月后,标准曲线 R² 从 0.999 掉到 0.97,低端标准点发散。染料聚集后量子产率下降。解法:工作液现配现用,2 小时内用完;母液 4 °C 避光存放不超过一个月,别反复冻融。
避坑总结 + 实操建议
三条核心结论:
1. 标准品必须和样品"同类"——同片段长度、同核酸类型。λDNA 只是妥协方案,别拿它当真。
2. 每批实验做一次加标回收,回收率 85%–115% 才认数据。这一步花 10 分钟,能省掉整批返工。
3. 样品体积不低于 5 µL,浓度落在标准曲线中段。省样品省出来的误差,比样品本身贵。
两个日常好习惯:
- 每天开工先用一个已知浓度质控点(比如 10 ng/µL 的标准品)测一次,偏差超 15% 直接换新试剂,别硬撑。
- 所有核酸样品统一洗脱到 TE pH 8.0,冰上避光存放。基质统一了,偏差自然少一半。
定量是下游实验的地基。浓度测不准,后面 qPCR 加样量错、克隆连接比例错、转染质粒量错,一路错到底。用准确浓度起手,引物设计、密码子优化、蛋白可溶性优化这些环节才有意义——站内的引物设计工具和密码子优化工具都要求你先输入准确的模板量,蛋白可溶性优化平台评估表达构建时同样依赖核酸定量数据。把定量这一关做扎实,后面的优化才不是白忙。