来源:Integrative bioinformatics, machine learning, and molecular docking identify HigBA toxin–antitoxin systems as key mediators of quorum sensing in Acinetobacter baumannii(Computational Biology and Chemistry)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
鲍曼不动杆菌是临床最难缠的耐药病原体之一。群体感应(QS)与毒素-抗毒素(TA)系统分别调控其毒力与持留性,但两者如何联动仍不清楚。本研究以3-oxo-C12-HSL处理的转录组数据(GSE87009)为起点,用WGCNA锁定一个10基因共表达模块,发现其中含两套完整的HigBA系统;LASSO与随机森林一致把它们推为QS预测标志基因;再以分子对接从202个化合物中筛出4个候选配体。研究给出了一条从QS信号到TA系统的机制线索。
研究背景
抗菌药物耐药(AMR)的全球蔓延,把鲍曼不动杆菌推到了公共卫生威胁的前列。世界卫生组织已将其列为需紧急应对的高优先级病原体。该菌对多种抗生素耐药,导致治疗失败、临床处置困难。它能在医院环境中长期存活,形成生物膜,耐受不利条件——住院时间因此延长,全球死亡率随之上升,医疗资源本就紧张的地区受害尤重。
问题之所以顽固,不只是耐药基因的累积,还在于其复杂的调控系统,使细菌能同时应答环境压力与宿主压力。细菌依靠群体感应按种群密度协调基因表达,包括毒力因子、生物膜形成与应激反应。毒素-抗毒素系统则参与持留休眠激活、抗生素耐受等过程。二者之间是否存在机制联系,此前并不清楚。本研究即以转录组、共表达网络、机器学习与分子对接的组合策略,寻找这一联系的具体节点。
研究方法
2.1 数据获取与预处理
数据集GSE87009自基因表达综合数据库(GEO,https://www.ncbi.nlm.nih.gov/geo/)下载。该数据集包含用3-oxo-C12-HSL处理的鲍曼不动杆菌AB105(GSM2318806、GSM2318807)与DMSO对照(GSM2318808、GSM2318809)的基因表达数据。分析中每种条件纳入两个生物学重复,GEO中存档的全部4个样本均纳入分析,未剔除任何样本。数据由Agilent-068651 MCCarmona v1定制微阵列平台(GPL20821)生成。表达数据经log2转换,并使用R语言limma包(v3.50.0)的normalizeBetweenArrays函数进行分位数归一化。与对照特征相关的探针(如BrightCorner、DarkCorner)被识别并标记以供过滤。差异表达分析采用t检验,并以R语言p.adjust函数进行Benjamini-Hochberg错误发现率(FDR)校正。预处理后,最终表达矩阵包含4个样本共15,744个探针。
【数据】数据集:GSE87009;样本:GSM2318806、GSM2318807(3-oxo-C12-HSL处理)、GSM2318808、GSM2318809(DMSO对照);平台:Agilent-068651 MCCarmona v1(GPL20821);生物学重复:每条件2个;探针数:15,744;软件包:limma v3.50.0;归一化方法:log2转换+分位数归一化;校正方法:Benjamini-Hochberg FDR
2.2 差异表达基因(DEGs)鉴定与加权基因共表达网络分析(WGCNA)
处理组与对照组之间的DEGs采用R语言t检验检测。多重假设检验校正采用Benjamini-Hochberg FDR法,计算校正后p值(padj)。差异表达基因定义为|log2 fold change| > 0.5且padj < 0.05者。按绝对倍数变化排序取前100个DEGs用于后续分析。共表达网络分析在R中使用WGCNA包(v1.71)对变异最大的1000个基因进行。邻接矩阵以软阈值功率β = 6构建(依据无标度拓扑准则选定)。邻接矩阵转换为拓扑重叠矩阵(TOM),并采用平均连锁法进行层次聚类。模块以动态树切割算法识别,最小模块大小为30个基因。计算模块特征基因(module eigengene),随后评估其与处理的关系。相关性最高的模块(Module 1,r = −0.996,p = 0.0041)被选作进一步研究对象。Module 1初始包含87个探针。利用平台注释文件(GPL20821)将探针ID映射至对应的基因座标签。去除对照探针后,剩余10个蛋白编码基因。基因位置取自NCBI RefSeq数据库中鲍曼不动杆菌AB105染色体及其质粒的注释。最终基因列表包括NT399_RS08790、NT399_RS08795、NT399_RS08800、NT399_RS08805、NT399_RS08810、NT399_RS08815、NT399_RS18265、NT399_RS18270、NT399_RS18275和NT399_RS18280。
【数据】差异基因阈值:|log2FC| > 0.5且padj < 0.05;前100 DEGs按绝对倍数变化排序;WGCNA输入:变异最大的1000个基因;软阈值功率:β = 6;最小模块大小:30个基因;Module 1:r = −0.996,p = 0.0041;Module 1初始探针数:87;最终蛋白编码基因数:10;基因ID:NT399_RS08790、NT399_RS08795、NT399_RS08800、NT399_RS08805、NT399_RS08810、NT399_RS08815、NT399_RS18265、NT399_RS18270、NT399_RS18275、NT399_RS18280
2.3 序列同源性与功能注释分析
#### 2.3.1 蛋白序列检索与BLAST分析
10个Module 1基因的蛋白序列按其登录号自NCBI Protein数据库检索:WP_000269903.1(HigB1)、WP_002126330.1(HigB2)、WP_001140619.1(HigA1)、WP_002126333.1(HigA2)、WP_049590625.1(IS5)、WP_188198428.1(PepS1)、WP_002124954.1(SerP)、WP_002125445.1(hypothetical)、WP_002124950.1(BrnT)、WP_004836815.1(BrnA)。序列以FASTA格式下载,使用BLASTP(v2.12.0)以1e⁻⁵的e值截断值比对NCBI非冗余(nr)数据库。每条序列保留前10个匹配,记录关键指标(一致性百分比、查询覆盖度、比特分数、e值)。
【数据】序列数:10条;登录号:WP_000269903.1、WP_002126330.1、WP_001140619.1、WP_002126333.1、WP_049590625.1、WP_188198428.1、WP_002124954.1、WP_002125445.1、WP_002124950.1、WP_004836815.1;工具:BLASTP v2.12.0;e值截断:1e⁻⁵;数据库:NCBI nr;保留匹配数:每条序列前10个
#### 2.3.2 基因本体(GO)富集分析
Module 1基因的功能理解通过系统分析完成。首先,通过查阅现有文献与查询UniProt等数据库赋予基因本体条目,重点覆盖分子功能(MF)、生物学过程(BP)和细胞组分(CC)。为可视化Module 1基因与其所赋GO条目之间的关系,构建了GO条目网络。使用KEGG自动注释服务器(KAAS),以双向最佳命中法比对鲍曼不动杆菌参考数据库,为模块基因分配KEGG编号。KO标识符与KEGG Mapper工具(https://www.genome.jp/kegg/tool/map_pathway.html)交叉比对以识别富集通路。基因功能使用BV-BRC数据库(https://www.bv-brc.org/)及文献整理进行注释。
【数据】GO类别:MF、BP、CC;注释数据库:UniProt、KEGG、BV-BRC;KEGG注释工具:KAAS(双向最佳命中法);通路映射工具:KEGG Mapper;原文未详述具体富集p值
2.4 机器学习分析
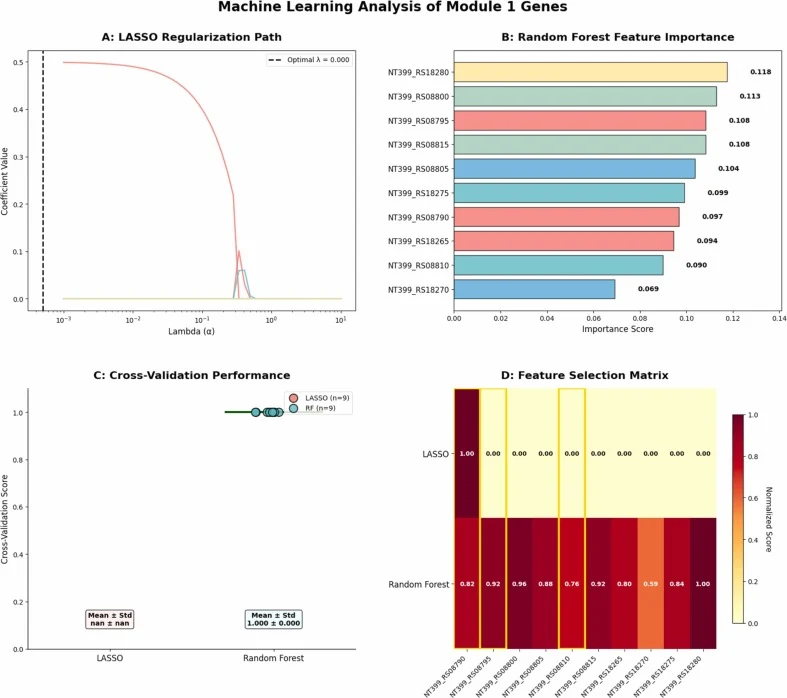
为识别关键预测基因,对10个Module 1基因的表达谱应用了两种机器学习方法。LASSO回归使用glmnet包(v4.1.4)实现,采用3折交叉验证(因样本量有限)。正则化参数λ经优化以最小化平均交叉验证误差;保留系数非零的基因。随机森林分析使用Random Forest包(v4.7.1.1),设置500棵树并采用袋外(OOB)误差估计。特征重要性以Gini不纯度平均下降量衡量。标志基因定义为同时被LASSO与随机森林选中者(取交集)。
【数据】方法:LASSO(glmnet v4.1.4)+随机森林(Random Forest v4.7.1.1);交叉验证折数:3;随机森林树数:500;重要性指标:Gini不纯度平均下降;标志基因定义:两法交集;输入基因数:10
2.5 鲍曼不动杆菌蛋白的分子对接
#### 2.5.1 配体库过滤与准备
自ZINC15数据库(http://zinc15.docking.org/)获得共2162个化合物。这些化合物依据对鲍曼不动杆菌或相关革兰阴性病原体已有报道或预测的活性选取。使用SwissADME网络服务器(http://www.swissadme.ch/)执行Lipinski五规则与Veber规则过滤。保留分子量 < 500 Da、logP < 5、氢键供体 < 5、氢键受体 < 10、TPSA < 140 Ų、可旋转键 < 10的化合物。PAINS及含已知毒性警示结构的化合物被剔除。该过滤策略从原始约15,000个化合物中产出2162个化合物的库。通过全部过滤器的最终化合物集为2162个。该数量是虚拟筛选库的典型规模,在筛选全面性与计算可行性之间取得良好折中。随后基于Lipinski与Veber规则施加更严格的附加过滤,得到最终202个被认为适合分子对接分析的化合物。过滤后的配体库经Open Babel(3.1.1版)准备并转换为PDBQT格式。添加Gasteiger电荷与极性氢以改善对接时的氢键作用。在格式转换或电荷分配中出现问题的配体被剔除,以确保计算一致性。
【数据】初始化合物:2162个(源自约15,000个);过滤服务器:SwissADME;阈值:MW < 500 Da、logP < 5、HBD < 5、HBA < 10、TPSA < 140 Ų、可旋转键 < 10;剔除项:PAINS及毒性警示结构;最终对接化合物:202个;准备工具:Open Babel 3.1.1;格式:PDBQT;电荷:Gasteiger;加氢:极性氢
#### 2.5.2 蛋白准备
蛋白氨基酸序列自NCBI蛋白数据库获得。三维结构利用AlphaFold2的ColabFold实现预测。每个蛋白依据平均预测局部距离差异检验(pLDDT)分数,选择置信度最高的模型,标记为rank_001。每个结构使用Open Babel(v3.1.1)准备:去除水分子、添加极性氢、分配Gasteiger部分电荷、转换为PDBQT格式。准备好的文件作为分子对接的受体。
【数据】结构预测工具:AlphaFold2(ColabFold实现);模型选择:rank_001(最高平均pLDDT);准备工具:Open Babel v3.1.1;处理:去水、加极性氢、Gasteiger电荷、转PDBQT;受体数:4个HigBA蛋白
#### 2.5.3 分子对接
(原文节选至此结束,对接参数、PLIP互作分析细节原文未详述。)
【数据】原文未详述
研究结果
3.1 3-oxo-C12-HSL处理后的差异基因表达
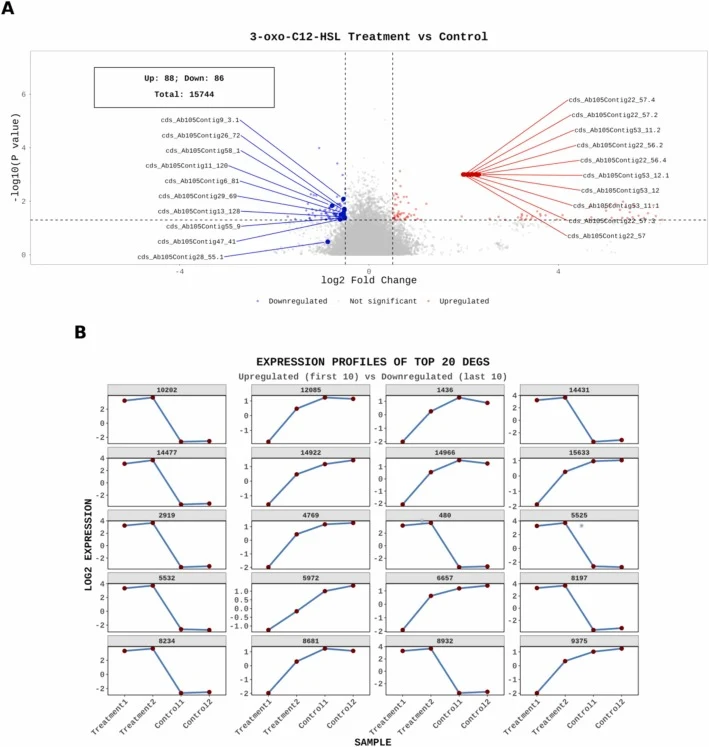
分析纳入15,744个基因,揭示88个上调、86个下调。最显著上调的基因展示于右图,其中最强者为cds_Ab105Contig53_12.1(log2FC=2.32,5.01倍;图1A)。相对地,左侧列出十个上调基因,而cds_Ab105Contig11_120是最显著下调者(log2FC = −0.78,p = 0.0147)。图1B显示,差异表达基因(DEGs)分析揭示鲍曼不动杆菌经3-oxo-C12-HSL处理后出现显著变化。上调类别中前10个最显著基因在Treatment1与Treatment2中的log2表达水平始终高于Control1与Control2。被鉴定为下调的后10个基因在处理样本中表达低于对照样本。这些趋势在生物学重复间一致,提示对该处理的转录应答是稳健的。
【数据】分析基因数:15,744;上调基因:88个;下调基因:86个;最强上调:cds_Ab105Contig53_12.1,log2FC=2.32,5.01倍;最强下调:cds_Ab105Contig11_120,log2FC=−0.78,p=0.0147;上调/下调各展示:10个基因
3.2 鲍曼不动杆菌中群体感应响应基因与模块的识别
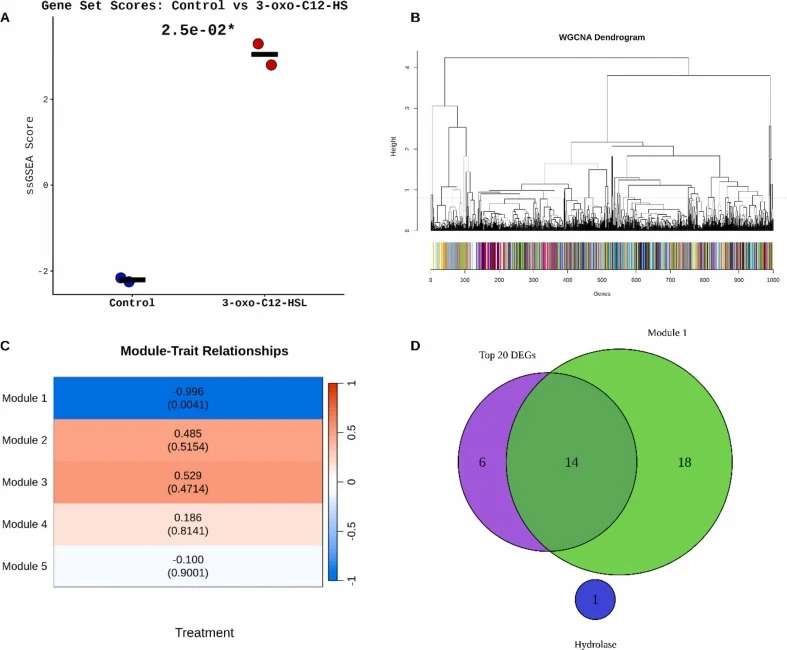
与对照(−2.20 ± 0.07,p = 0.025)相比,3-oxo-C12-HSL处理显著提高基因集分数(3.04 ± 0.35),组间差异达5.24倍;这表明群体感应刺激引起基因表达的强烈激活(图2A)。对变异最大的1000个基因聚类,揭示出彼此分明的共表达模块,模块在树状图下方以颜色编码。绿松石色模块(最大)对应Module 1,与处理的相关性最强(图2B)。Module 1与3-oxo-C12-HSL处理呈强负相关(r = −0.996,p = 0.0041),其他模块未见显著相关。由此确认Module 1是群体感应激活的主要转录响应(图2C)。基因集交集分析显示,在前20个DEGs与Module 1基因之间,有14个基因重叠。前20个DEGs中有6个基因为独有,Module 1独有基因18个,另有1个水解酶基因(cds_Ab105Contig53_12.1)。水解酶相关基因是通过在GPL20821平台基因注释与BV-BRC功能注释中筛查水解酶相关关键词(如"hydrolase""protease""peptidase""esterase""lipase")从前100个差异表达基因中识别出的。α/β水解酶(cds_Ab105Contig53_12.1)被鉴定为最强调控基因(5.01倍)。所识别的水解酶基因与Module 1基因(WGCNA)及AMR相关基因(BV-BRC注释)作了交叉比对。然而,没有水解酶基因与Module 1或AMR基因重叠,该水解酶基因因而成为单例(图2D)。
【数据】处理组基因集分数:3.04 ± 0.35;对照组:−2.20 ± 0.07;p = 0.025;组间倍数:5.24倍;WGCNA输入:变异最大的1000个基因;Module 1:r = −0.996,p = 0.0041;Top 20 DEGs与Module 1重叠基因:14个;Top 20独有:6个;Module 1独有:18个;水解酶基因:cds_Ab105Contig53_12.1,上调5.01倍
3.3 鲍曼不动杆菌Module 1基因的基因组图谱
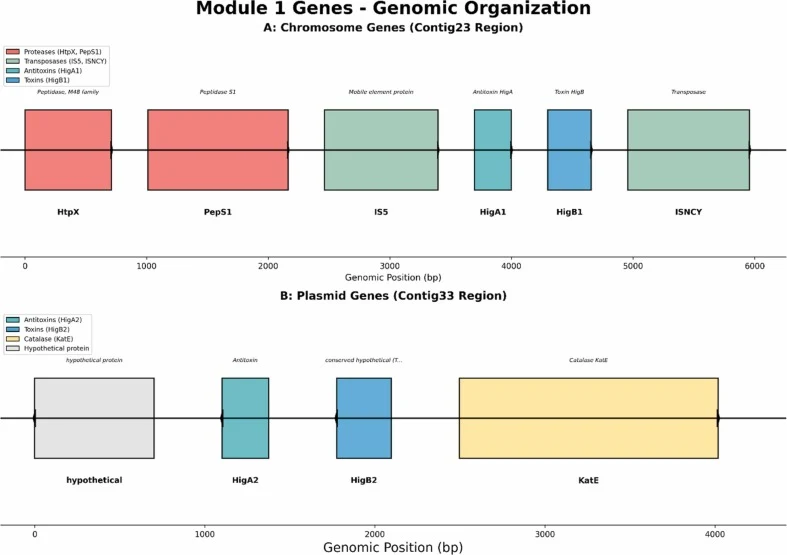
对10个Module 1基因基因组背景的分析显示,它们均为蛋白编码序列,功能注释经BV-BRC基因组注释流程确认,分布于两个不同的复制子:染色体(NZ_CP103338)与质粒unnamed4(NZ_CP103341)。6个基因(60%)位于染色体,4个基因(40%)位于质粒,表明该群体感应响应模块同时包含核心与可移动遗传元件。这些基因涵盖五个功能类别:蛋白酶(2个基因,20%)、毒素(2个基因,20%)、抗毒素(2个基因,20%)、转座酶(2个基因,20%)、过氧化氢酶(1个基因,10%)与假定蛋白(1个基因,10%)。最主要的功能基序由两套完整TA系统(染色体与质粒携带)构成,占该模块的40%(图3)。染色体基因大小从303 bp(HigA1)到1152 bp(pepS1)不等,平均长度743 bp。6个染色体基因以连续方式排列在约5.6 kb范围内(图4A)。基因排列如下:HtpX(肽酶,M48家族)、PepS1(肽酶S1)、IS5(可移动元件蛋白)、HigA1(抗毒素)、HigB1(毒素)与ISNCY(转座酶)。两个转座酶基因紧邻一套完整毒素-抗毒素(TA)系统,提示该区域可能经水平基因转移获得并随后稳定下来。此外,higA1-higB1 TA系统与周围基因转录方向相同,提示其可能属于一个操纵子。质粒基因从273 bp(higA2)到1521 bp(katE)不等,平均长度704 bp。4个质粒携带基因排列在质粒unnamed4上3.6 kb的区域内。基因组织包括HigA2-HigB2 TA系统(分别为抗毒素与毒素)、过氧化氢酶(katE)与一个假定蛋白。HigA2与HigB2基因的转录方向与染色体TA系统相反。
【数据】基因总数:10个;染色体:6个(60%),NZ_CP103338;质粒unnamed4:4个(40%),NZ_CP103341;功能类别:蛋白酶2个(20%)、毒素2个(20%)、抗毒素2个(20%)、转座酶2个(20%)、过氧化氢酶1个(10%)、假定蛋白1个(10%);TA系统占比:40%;染色体基因长度:303 bp(HigA1)–1152 bp(pepS1),平均743 bp;染色体基因簇跨度:约5.6 kb;质粒基因长度:273 bp(higA2)–1521 bp(katE),平均704 bp;质粒基因簇跨度:3.6 kb
3.4 GO富集分析揭示功能多样性
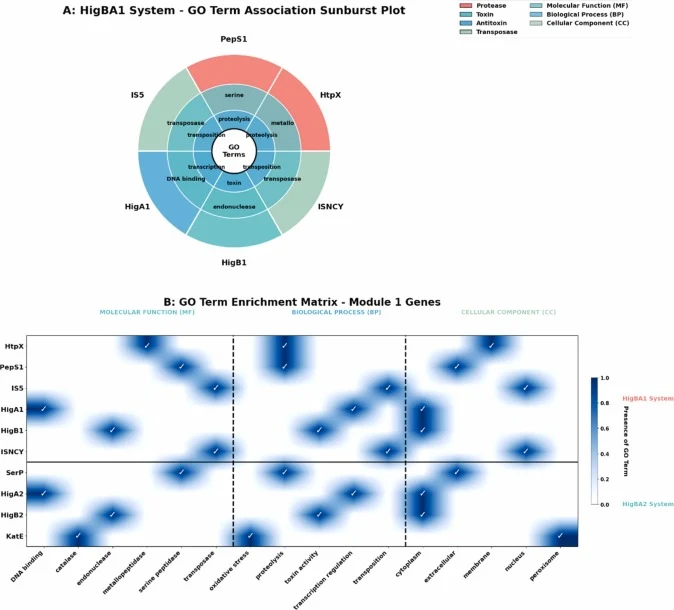
与HigBA1系统基因(HtpX、PepS1、IS5、HigA1、HigB1与ISNCY)相关的GO条目按其蛋白类型(蛋白酶、毒素、抗毒素、转座酶)聚类,如图4A所示。这些基因与其分子功能相关,并连接至蛋白水解、转座、转录调控与毒素活性等更大的生物学过程。该流程图展示各基因对特定功能与过程的贡献。部分基因共享相似功能,另一些则功能独特。GO条目富集矩阵被虚线分为三个纵向部分,分别指示分子功能(MF)、生物学过程(BP)与细胞组分(CC)。MF部分包含6个独特条目(图4B)。丝氨酸肽酶见于PepS1与SerP。转座酶见于IS5与ISNCY。DNA结合见于HigA1与HigA2。核酸内切酶见于HigB1与HigB2。金属肽酶仅见于HtpX,过氧化氢酶仅见于KatE。BP部分包含5个不同条目。蛋白水解在3个基因中检出:HtpX、PepS1与SerP。转座在IS5与ISNCY中检出。HigA1与HigA2显示转录调控。KatE响应氧化应激,而HigB1与HigB2显示毒素活性。CC部分有5个不同条目。细胞质是最常见条目,见于6个基因:HigA1、HigB1、HigA2、HigB2、IS5与ISNCY。胞外见于PepS1与SerP。膜仅见于HtpX。细胞质也见于KatE。
【数据】MF条目数:6个;BP条目数:5个;CC条目数:5个;丝氨酸肽酶:PepS1、SerP;转座酶:IS5、ISNCY;DNA结合:HigA1、HigA2;核酸内切酶:HigB1、HigB2;金属肽酶:HtpX;过氧化氢酶:KatE;蛋白水解:HtpX、PepS1、SerP;细胞质定位:6个基因(HigA1、HigB1、HigA2、HigB2、IS5、ISNCY)
3.5 蛋白序列BLAST分析
10个Module 1蛋白序列对NCBI非冗余数据库的BLAST分析显示出高序列保守性与进化关系信息(图5)。由两两序列相似性构建的系统发育树清晰地将基因分为不同功能簇(图5A)。系统发育聚类表明,4个毒素-抗毒素基因形成两个不同簇:染色体HigBA系统聚为一支,质粒携带HigBA系统形成独立但相关的一簇。这说明染色体与质粒毒素-抗毒素系统演化路径不同。蛋白酶基因与HtpX聚在一起,且与SerP的关系比与PepS1更近。两个转座酶基因形成紧密一簇,确认它们尽管位于不同复制子却共享进化起源。毒素-抗毒素蛋白与已知HigB、HigA家族蛋白一致性达98–99%,蛋白酶基因与已表征肽酶一致性达95–98%,转座酶基因与IS家族转座酶一致性达87–89%。全部基因两两相似性的表示见图5B。对角线轴上显著峰的存在印证了完美的自身匹配,各得100分。位于同类基因之间、得分85至95的抬升平台区提示稳健的保守性(原文节选至此结束)。
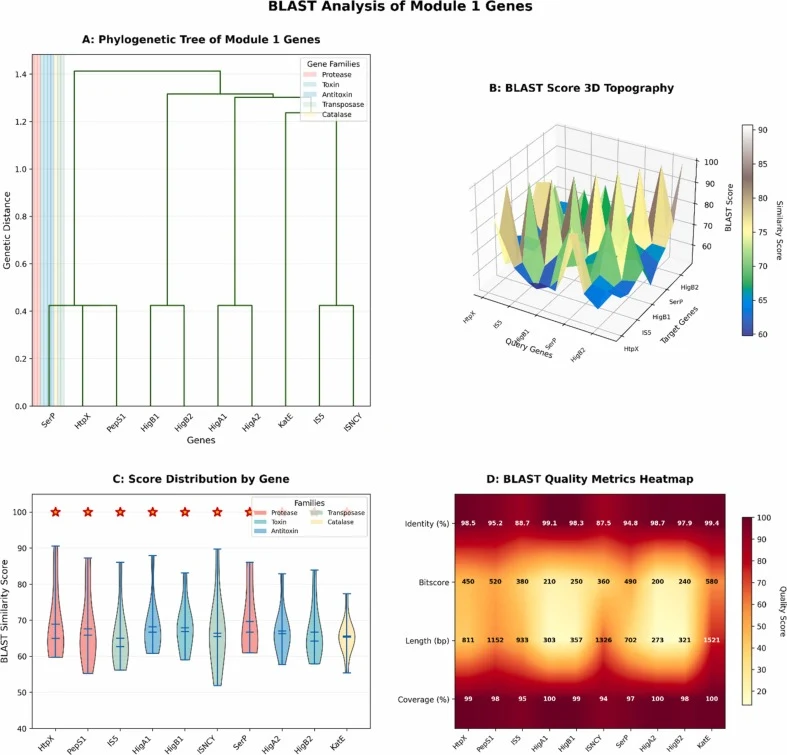
【数据】TA蛋白一致性:98–99%(HigB、HigA家族);蛋白酶一致性:95–98%;转座酶一致性:87–89%(IS家族);自身匹配得分:100;同类基因平台区得分:85–95;分析序列数:10条
3.6 机器学习分析将毒素-抗毒素系统识别为关键标志基因
(原文节选未提供该小节正文,图6对应机器学习分析结果。)
【数据】原文未详述
3.7 分子对接与蛋白-配体互作
(原文节选未提供该小节正文。图7汇总各蛋白最佳配体:HigA1–配体178(亲和力−4.51 kcal/mol)、HigA2–配体147(−6.61 kcal/mol)、HigB1–配体198(−6.79 kcal/mol)、HigB2–配体17(−7.65 kcal/mol)。)
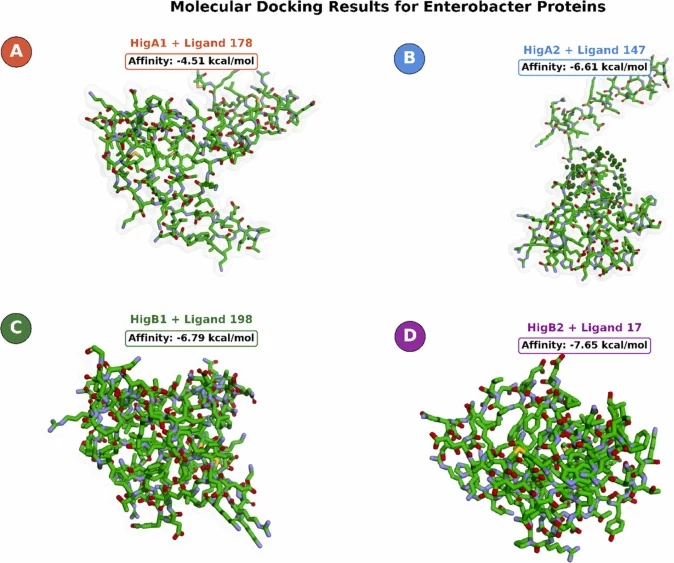
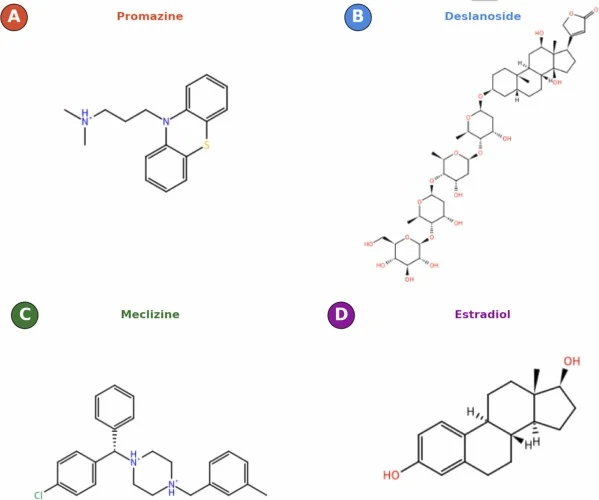
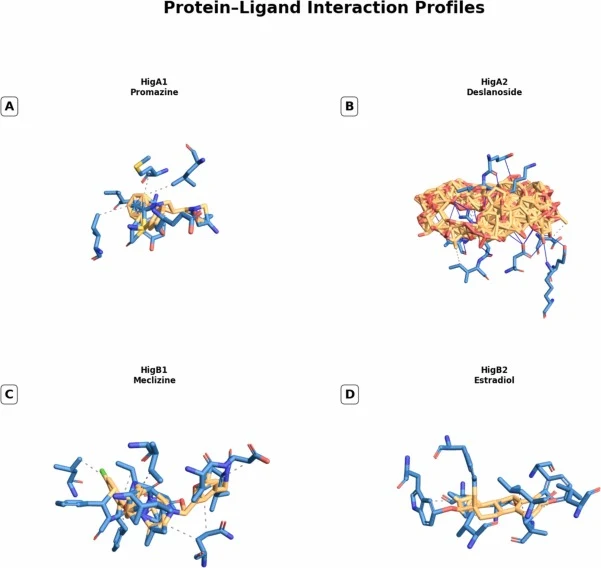
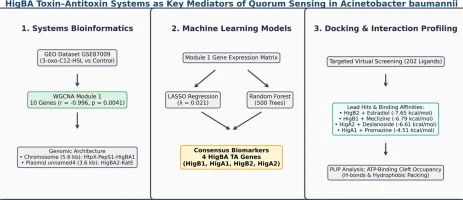
【数据】HigA1–配体178:−4.51 kcal/mol;HigA2–配体147:−6.61 kcal/mol;HigB1–配体198:−6.79 kcal/mol;HigB2–配体17:−7.65 kcal/mol;配体147(Deslanoside)氢键数:23个;配体198(Meclizine)锚定残基:CYS83;配体178(Promazine)与配体17(Estradiol):疏水接触;所有配体占据位点:ATP结合裂隙
讨论与解读
本研究用生物信息学与机器学习工具分析鲍曼不动杆菌对群体感应分子3-oxo-C12-HSL的反应,以识别可能参与该响应的关键基因与生物学过程。结果显示,一个含10个蛋白编码基因的共表达模块(Module 1)是该菌群体感应激活的主要转录响应(图2B)。核心发现是:两套完整的HigBA毒素-抗毒素复合体构成Module 1的关键组分。一套位于染色体(HigB1-HigA1;NT399_RS08810/NT399_RS08805),另一套位于unnamed4质粒(HigB2-HigA2;NT399_RS18275/NT399_RS18270)(图3)。处理属性被编码为二值变量:3-oxo-C12-HSL处理样本(GSM2318806、GSM2318807)编码为1,对照样本(GSM2318808、GSM2318809)编码为0。因此Module 1与处理性状之间的负相关(r = −0.996)表明Module 1基因表达与处理条件负相关。具体而言,模块特征基因(ME1)在处理样本中低于对照,与群体感应激活后Module 1基因下调一致。细菌基因组中含众多毒素-抗毒素系统,使细菌得以耐受压力、构建生物膜并在恶劣环境中存活。HigBA家族尤其如此(原文讨论节选至此结束)。
编译者解读
这是一项纯计算研究:转录组重分析+WGCNA+双机器学习+对接筛选,链条完整但缺湿实验验证。亮点在于用无监督共表达模块把QS信号与两套HigBA系统直接挂钩(r = −0.996),并以LASSO/随机森林交叉确认——这种"网络定位+特征选择"的组合,比单纯差异表达更适合挖掘调控枢纽。局限同样明显:每组仅2个重复,对接依赖AlphaFold预测结构,配体亲和力落在−4.51至−7.65 kcal/mol的弱至中等区间,离先导化合物尚有距离。对合成生物学而言,HigBA启动子可作为QS响应开关的候选元件,但需在体内验证其动态范围与正交性。
参考来源
期刊:Computational Biology and Chemistry, 2026
DOI: 10.1016/j.compbiolchem.2026.109362
DOI: 10.1016/j.compbiolchem.2026.109362