来源:Rational design of chimeric polyhydroxyalkanoate synthases suggests a conserved N-terminal domain-to-LID region network influencing 3HHx incorporation and granule morphology(International Journal of Biological Macromolecules)| 编译:DNA Lab Space | 原文许可:elsevier-subscription
导读
天然PHA合酶底物谱窄,限制了定制共聚物的生产。本研究以两种功能互补的I类PHA合酶——高活性的PhaC Cs与高3HHx掺入能力的PhaCBP-M-CPF4——为亲本,通过生物信息学指导的理性设计构建嵌合酶,16个嵌合体全部具有活性,成功率达100%。部分嵌合体兼具高产率、13.3 mol%的3HHx掺入与单颗粒形态,并提示N端结构域与CAP亚结构域LID区之间存在保守氢键网络,为底物门控机制提供了假设。
研究背景
塑料废弃物造成的微塑料污染已在人体组织中被检出,并与健康风险相关联。聚羟基脂肪酸酯(PHA)是微生物合成的可降解聚酯,因可再生、可堆肥、性能可调而被视为石化塑料的替代品。但PHA的工业应用受限于PHA合酶(PhaC)底物专一性窄、聚合效率低——PhaC正是决定聚合物产量、单体组成、分子量与颗粒形态的关键酶。短链PHA如P(3HB)质脆,中链PHA柔韧却热稳定性差、生物合成效率低。天然PhaC底物选择性严格,难以生产兼顾强度与弹性的P(3HB-co-3HHx)等定制共聚物。PhaC工程因此成为研究热点:随机突变需要大文库与繁重筛选,成功案例有限;理性设计虽能产出有用变体,但仍受结构信息不足制约。
研究方法
2.1 菌株、质粒与基因
本研究使用的所有菌株、质粒与核苷酸序列均收录于表S1–S3。phaC Cs与phaC BP-M-CPF4的编码序列由华大基因(中国)合成,并针对C. necator H16进行密码子优化。所有PhaC变体,包括完整、截短与嵌合形式,均采用标准技术克隆至广宿主范围载体pBBR1MCS2中,宿主为E. coli DH5α。所得质粒构建体随后通过E. coli S17–1介导的接合转移导入PHA缺陷宿主C. necator PHB−4。在C. necator PHB−4转化子中,构建的基因受来自C. necator H16的天然phaC1启动子转录控制而表达。E. coli菌株在37 °C的Luria–Bertani(LB)琼脂上培养,C. necator H16、PHB−4及其转化子则在30 °C的胰酪大豆胨 broth(TSB)琼脂上维持。抗生素补充如下:携带构建质粒的E. coli菌株使用50 μg/mL卡那霉素;野生型C. necator H16与PHB−4突变株不加抗生素;接合筛选期间C. necator PHB−4转化子使用300 μg/mL卡那霉素;维持选定的C. necator PHB−4转化子使用50 μg/mL卡那霉素。
【数据】培养基:LB(E. coli)/TSB(C. necator);温度:37 °C(E. coli)/30 °C(C. necator);卡那霉素:50 μg/mL(E. coli及维持)、300 μg/mL(接合筛选);质粒:pBBR1MCS2;启动子:phaC1
2.2 PhaC的生物信息学分析
PhaC Cs(登录号ADL70203.1)、PhaCBP-M-CPF4(登录号AXB72506.1)、Rhodococcus aetherivorans I24的PhaC2(PhaC2 Ra;登录号AED02507.1)与PhaC1 Cn(登录号WP_011615085.1)的蛋白序列自美国国家生物技术信息中心(NCBI)数据库(https://www.ncbi.nlm.nih.gov/)获取。这些序列及其他研究充分的PhaC的氨基酸序列使用EMBL-EBI Clustal Omega服务器(https://www.ebi.ac.uk/jdispatcher/msa/clustalo)比对,以分析其亲缘关系、序列一致性与两两相似性。所得一致性矩阵用R(v4.4.1)中的Pheatmap函数可视化为热图。PhaC氨基酸序列的系统发育树在Molecular Evolutionary Genetics Analysis 12(MEGA 12)中采用最大似然(ML)算法构建。树拓扑可靠性以1000次bootstrap重复评估,所得树用FigTree软件可视化与最终修饰。为比较PhaC的结构域架构,二级结构用PSIPRED工作台预测,3D模型用Local ColabFold预测。
【数据】序列登录号:ADL70203.1、AXB72506.1、AED02507.1、WP_011615085.1;bootstrap:1000次;软件:MEGA 12、R v4.4.1、PSIPRED、Local ColabFold
2.3 细菌转化子的构建
本研究共使用52株工程菌,其中50株为本研究构建,2株来自先前研究(表S2与S3)。50株新构建菌株中,26株仅含新构建的phaCs基因,另24株含phaCs与来自C. necator H16的phaJ4b Cn基因共表达。本研究所用phaCs包括两个亲本phaCs与25个构建的phaCs,其中9个携带渐进式N端缺失(6个为phaC Cs,3个为phaC BP-M-CPF4),16个为通过互换各亲本酶N端片段创建的嵌合变体。截短与嵌合PhaC设计的详情见3.2节。质粒构建流程见图S1。所有构建质粒均通过E. coli S17–1介导的接合转移导入C. necator PHB−4。转化子经菌落PCR确认,质粒保真性经测序验证。相关菌株与质粒列于表S3,引物序列列于表S4,扩增不同基因或末端区域的引物对列于表S5。
【数据】菌株总数:52株(新构建50株、先前2株);仅含phaCs:26株;共表达phaJ4b Cn:24株;phaCs总数:27个(亲本2个、构建25个);截短变体:9个;嵌合变体:16个
2.4 PHA生物合成
构建的菌株首先在尼罗红琼脂平板上筛选功能性PhaC。尼罗红琼脂的制备见Tan等所述。2.3节构建的产PHA的C. necator转化子(见表S3)首先在250 mL锥形瓶中的50 mL TSB培养基中作预培养。当OD₆₀₀达到4.5–5.0时,以3%(v/v)接种量转接至250 mL锥形瓶中的50 mL无机盐培养基(MM)。MM配方基于Budde等。碳源与氮源于接种前即时补充。尿素作氮源,浓度0.054%(w/v)。果糖(2.0%,w/v)、椰子油(CNO;0.7%,w/v)或棕榈油(PO;0.8%或1.2%,w/v)作为唯一碳源加入。这些浓度依据先前研究与预实验选定,以确保充足碳供应、同时最小化生长抑制并保持可比性。培养基中加入卡那霉素(50 mg/L)以保证质粒维持。培养在30 °C、200 rpm振荡下进行48 h。培养结束后收集细胞并冻干用于后续分析。
【数据】接种量:3%(v/v);OD₆₀₀:4.5–5.0;氮源:尿素0.054%(w/v);碳源:果糖2.0%、CNO 0.7%、PO 0.8%或1.2%(w/v);卡那霉素:50 mg/L;温度:30 °C;转速:200 rpm;时间:48 h
2.5 C. necator转化子合成PHA的表征
为测定PHA含量与单体组成,冻干细胞生物质(15–20 mg)按Braunegg等的方法进行酸催化甲醇解。反应在15%(v/v)硫酸与85%(v/v)甲醇的溶液中于100 °C进行140 min。冷却至25 °C后,加入1 mL蒸馏水,混合物剧烈涡旋60 s以诱导相分离。收集含羟酰基甲酯的有机相,用无水硫酸钠脱水。GC–MS分析(Agilent 7890B/5977 A;Agilent Technologies, Inc., USA)时,取0.5 mL衍生化样品与等体积0.2%(v/v)辛酸甲酯(CME)内标混合。分离在HP-5MS毛细管柱(30 m × 0.25 mm × 0.25 μm;Agilent Technologies, Inc., USA)上进行,氦气为载气(1.0 mL/min)。柱温程序自40 °C开始(保持1 min),以10 °C/min升至120 °C(保持2 min),再以20 °C/min升至240 °C(保持2 min)。采集质谱并与NIST库比对以鉴定化合物。定量时,对每种单体构建外标曲线:3HB用纯化P(3HB)均聚物,3HHx用P(3HB-co-3HHx)共聚物(3HHx含量由1H NMR测定)。标准品经历相同的甲醇解与GC–MS流程。CME用作内标。准确性用选定样品验证,其GC–MS与1H NMR组成偏差在±1 mol%以内。后续分析中,PHA自冻干细胞以氯仿溶剂萃取法提取,浓度1%(w/v),室温持续搅拌72 h。所得溶液经Whatman® 1级滤纸过滤去除细胞碎片,聚合物随后在冰冷甲醇中沉淀纯化。为解析结构,提取的PHA经1H与13C核磁共振(NMR)波谱分析。1H NMR分析时,将10 mg PHA溶于1 mL氘代氯仿(CDCl3)制样;13C NMR则将50 mg聚合物溶于1 mL CDCl3。所有谱图在Bruker AVANCE III HD 500 MHz波谱仪上采集,四甲基硅烷(Me4Si)为内标。1H NMR分析确认两种单体的掺入,并通过特征峰相对面积计算各单体摩尔分数,确定P(3HB-co-3HHx)共聚物的摩尔组成。共聚物单体序列分布依Bartels等的方法由13C NMR谱评估。
【数据】生物质:15–20 mg;甲醇解:15%硫酸/85%甲醇、100 °C、140 min;相分离:1 mL水、涡旋60 s、25 °C;内标:0.2%(v/v)CME;载气:氦气1.0 mL/min;柱温:40 °C→120 °C(10 °C/min)→240 °C(20 °C/min);萃取:氯仿1%(w/v)、室温72 h;NMR:10 mg(1H)/50 mg(13C)、500 MHz;准确性:±1 mol%
2.6 P(3HB)颗粒形态的表征
表达天然或工程PhaC变体的C. necator PHB−4转化子所产P(3HB)颗粒的超微结构特征见原文后续(节选至此)。
【数据】原文未详述
研究结果
3.1 PhaC配对的选择依据
PhaC是PHA生物合成的关键酶,在生产多样聚合物方面具有显著工程潜力。Tan等此前报道了若干特性改良的PhaC嵌合体。本研究进一步支持PhaC嵌合化可作为可靠的工程手段这一观点。为此,我们汇编了来自不同类别、表征充分的PhaC清单(表S6),并基于进化关系、序列同源性、结构相似性与功能特征建立选择标准。此外,PhaC嵌合化有望提供进一步证据并阐明N端与C端结构域的具体作用。用ML算法构建PhaC氨基酸序列系统发育树以确定这些PhaC间的进化关系(图1A)。分析揭示四个对应I至IV类的明显分支。有趣的是,PhaC2 Ra虽依其底物专一性(高产3HB)传统上归为I类PhaC,但我们的系统发育分析将其归入与II类酶相同的分支(图1A),而PhaCBP-M-CPF4则与其他I类PhaC聚为一支。与这一系统发育距离一致,我们先前的研究显示以PhaC2 Ra为C端亲本构建的嵌合体成功率极低,进一步表明PhaC2 Ra与I类PhaC之间结构兼容性差。因此,PhaC2 Ra被认为不适合与PhaCBP-M-CPF4或其他I类PhaC配对,被排除在进一步考虑之外。核苷酸序列一致性分析给出了一致的聚类结果(图S2)。
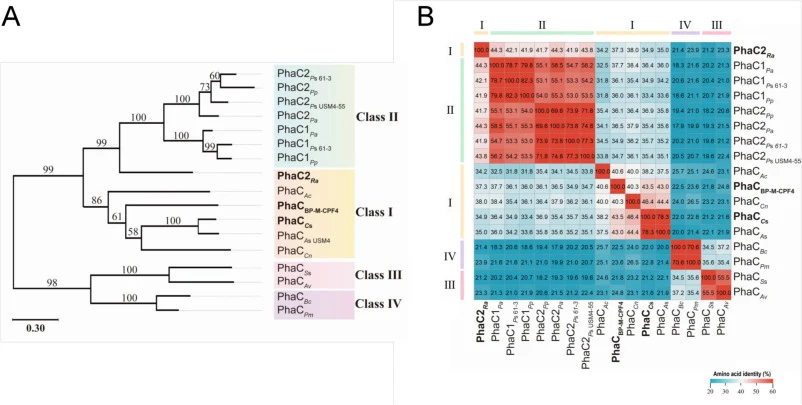
接着我们计算了所有PhaC间的氨基酸序列一致性(图1B)。该分析确认了同样的四组聚类,并为我们的选择提供了定量支持。结构域特异性一致性矩阵见图S3。我们最初假设,PhaC酶的成功嵌合将因高序列同源性而更易实现,尤其是在C端结构域。然而,亲本酶之间的功能差异性同样关键,因为目标是将 divergent 谱系中互补的有益性状结合起来。这些性状包括底物专一性、产量、聚合物分子量与颗粒形态。这种功能反差的要求使高度相似的I类配对PhaC Cs与PhaC As(序列一致性78%,图1B)不适合作为主要搭档。依据现有文献,这两种酶在底物专一性、酶活性、聚合物分子量或颗粒形态上并无实质分化。因此,它们不被期望提供嵌合化所需的功能反差。我们因而聚焦于总体同源性较低但已知具有互补性状的配对。相比之下,其他I类配对仅共享38–46%的一致性(图1B),使78%显著偏高。此外,为能与先前工作直接比较,我们选择PhaCBP-M-CPF4或PhaC2 Ra之一作为亲本。PhaCBP-M-CPF4最终因其与其他I类PhaC更近的进化关系与更高的序列相似性而入选。值得注意的是,先前工作报道保留PhaCBP-M-CPF4 C端结构域的嵌合体表现出更优的单颗粒形态。尽管本研究仅聚焦N端互换,这一先前观察进一步支持选择PhaCBP-M-CPF4作为亲本酶,因为其C端结构域(在我们所有嵌合体中保持完整)可能对颗粒形态有有利贡献。II类PhaC在系统发育上与PhaCBP-M-CPF4距离更远(图1A),故未被视为直接嵌合搭档。III类与IV类PhaC因缺乏I类与II类PhaC所具有的延伸NTD而被排除在嵌合化之外(图S4)。因此,另一亲本从剩余I类PhaC中选择。鉴于PhaCBP-M-CPF4体外酶活性较低但3HHx单体掺入中等偏高,需要一个功能特性相反的搭档。PhaC Cs因其高体外酶活性与低3HHx掺入倾向而满足这一需求。最终,PhaCBP-M-CPF4与PhaC Cs被选为嵌合配对。
【数据】序列一致性:PhaC Cs与PhaC As为78%;其他I类配对38–46%;系统发育树:ML、1000 bootstrap;PhaC2 Ra归入II类分支
3.2 截短与嵌合PhaC酶的设计
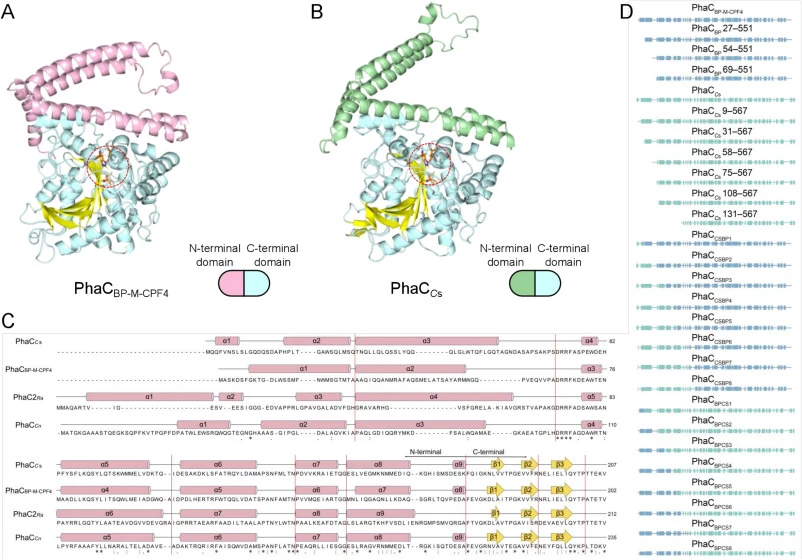
我们以Aeromonas caviae PhaC(PhaC Ac,PDB: 9KNK)晶体结构为模板,用ColabFold对PhaCBP-M-CPF4与PhaC Cs进行二级结构与3D建模。预测模型显示PhaCBP-M-CPF4的NTD含八个螺旋(BPα1–BPα8),而PhaC Cs具九个(CSα1–CSα9)。与已知PhaC Ac结构一致,两个模型的NTD中均未发现β链元件(图2A–C)。PhaC的NTD关键影响底物专一性、聚合物分子量、二聚化与颗粒形成。相反,C端结构域采取紧凑的α/β水解酶折叠,含PHA聚合的必需元件,包括催化三联体与底物通道。两个结构域对活性均不可或缺,删除任一即废除聚合。这种二分架构为工程嵌合PhaC提供了结构基础。我们因而聚焦于互换N端α螺旋区域,同时保持C端α/β水解酶核心结构域完整。避免互换C端片段,是因为先前研究一致产生无功能酶,表明C端结构域的结构完整性对破坏高度敏感。设计的截短与嵌合体示意概览见图2D(简化表示);带α螺旋与β链注释的更详细结构域架构见图S5。总计,我们通过在两亲本酶间互换确定的N端片段,构建了9个截短与16个嵌合PhaC构建体。嵌合体命名为CSBP系列(PhaC Cs N端+PhaCBP-M-CPF4 C端)与BPCS系列(反向)。完整设计策略,包括序列比对、二级结构预测、片段边界定义与基于环连接的理由,见图2并在补充方法中详述(方法描述见图S5)。为生成用于评估N端功能互补的部分受损基线对照,我们构建了PhaC Cs与PhaCBP-M-CPF4的N端截短变体(见图2D与S5)。所有构建体在相同条件下于C. necator中表达。为确保评估3HHx掺入所需的充足单体供应,(R)-特异性烯酰辅酶A水合酶PhaJ4b Cn自同一质粒共表达。
【数据】NTD螺旋数:PhaCBP-M-CPF4为8个(BPα1–BPα8)、PhaC Cs为9个(CSα1–CSα9);模板:PhaC Ac(PDB: 9KNK);构建体:截短9个、嵌合16个;嵌合系列:CSBP、BPCS
3.3 全长PhaCBP-M-CPF4及其N端截短变体的PHA生产
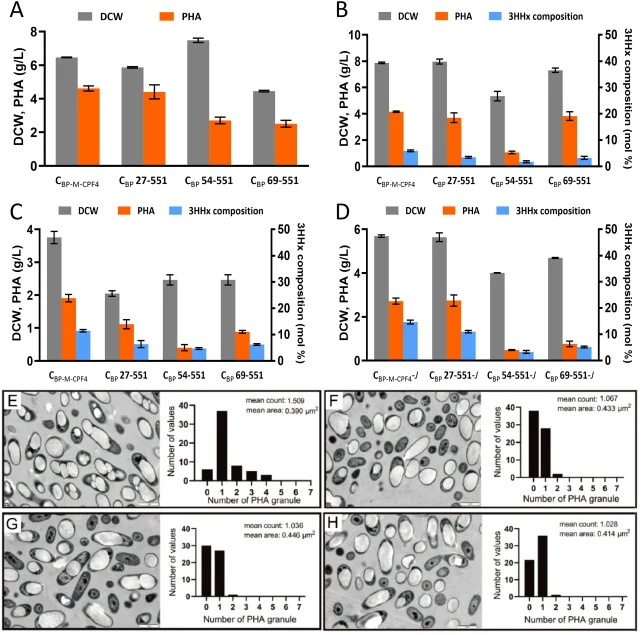
PhaCBP-M-CPF4的三个截短变体(27–551、54–551与69–551)在尼罗红琼脂筛选中保留PHA合成活性(图S6),被选用于体内研究。全长酶用作对照。在所有测试碳源下,全长酶显示最高PHA滴度与最高3HHx分数(图3A–D)。去除第一个N端α螺旋(变体27–551)在以果糖或PO为唯一碳源时未显著降低PHA滴度。然而,以CNO为碳源时观察到显著下降,变体27–551仅保留全长滴度的57.9%(表S7)。CNO含较高比例的短链脂肪酸(如C12),已知会损害C. necator PHB−4的生长。这种受损的细胞适应度似(节选至此)。
【数据】截短变体:27–551、54–551、69–551;CNO条件下27–551滴度:全长的57.9%;碳源:果糖2.0%、PO 1.2%/0.8%、CNO 0.7%(w/v)
讨论与解读
本研究提出并支持一套用于理性设计功能性嵌合PhaC的生物信息学兼容性标准。16个嵌合体100%的活性成功率彰显了该框架的预测力:亲本兼容性越高,直接增加创建兼具杂合有益性状的功能酶的概率。通过结构域互换与截短,我们进一步提示催化结构域主要影响3HHx掺入与颗粒形态,而NTD对二者起调节作用。关键的是,我们提出一个连接NTD与CAP亚结构域LID区的保守氢键网络,该特征为四个远缘相关的I类与II类PhaC所共享。该网络被提出仅由NTD最后三个α螺旋形成,并在二聚化与LID门控的耦合中起作用;其破坏被提出会损害LID移动性、限制底物通道并选择性排除3HHx-CoA等 bulky 单体。由于III类与IV类PhaC缺乏延伸NTD,该模型目前限于I类与II类酶。III类与IV类PhaC是否通过其他亚结构域运行类似的远端互作网络,仍是开放问题,值得未来研究。需注意,本研究仅考察了3HB与3HHx的掺入;所提出的NTD–LID网络是否也支配其他单体的掺入仍有待探索。
编译者解读:该研究的价值在于把"能不能嵌合"从试错变成可计算的配对问题——用进化距离、序列一致性与功能反差三条标准筛亲本,16/16的活性率是硬证据。方法上,仅互换N端α螺旋而保留C端水解酶核心,规避了此前C端互换普遍失活的陷阱。局限也明显:NTD–LID氢键网络目前只是ColabFold模型提出的机制假设,缺乏突变验证与结构解析;且结论仅覆盖I、II类酶与3HB/3HHx两种单体。对合成生物学而言,这提供了一个可移植的嵌合设计流程与一个潜在的变构改造靶点。
参考来源
International Journal of Biological Macromolecules, 2026
DOI: 10.1016/j.ijbiomac.2026.154671
DOI: 10.1016/j.ijbiomac.2026.154671