来源:核酸杂交探针特异性错配Tm计算(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做杂交最难受的不是没信号,而是该亮的亮、不该亮的也亮。你以为是探针设计不行,其实十有八九是Tm算错了,或者压根没用对。错配识别本质是个热力学问题:差了2–3°C,野生型和单碱基突变体就分不开。这篇教程从探针设计、Tm计算模型、缓冲体系到洗脱严谨度,按实验流程一步步拆。看完你能自己定位问题卡在哪个环节,而不是一遍遍换探针烧钱。
第一步:快速排查低级错误
先把这几个坑排掉,我见过太多人在这卡半天。
1. 探针方向搞反了:核对合成单上的5'→3'序列,确认写进计算软件的是靶标互补链而不是靶标本身,反了Tm数值看着正常,实际根本不结合。
2. Tm公式选错:短于14 nt用Wallace规则(4×(G+C)+2×(A+T))还行,20 nt以上的探针必须用最近邻(nearest-neighbor)模型,两者能差15°C以上。
3. 盐浓度用了默认值:计算器默认1 M NaCl,你的杂交液可能只有50 mM,这一项能让Tm虚高10–12°C。
4. 修饰碱基当普通碱基算:探针里有LNA、2'-O-methyl或锁核酸类似物,还按dA/dT算,Tm直接被低估。
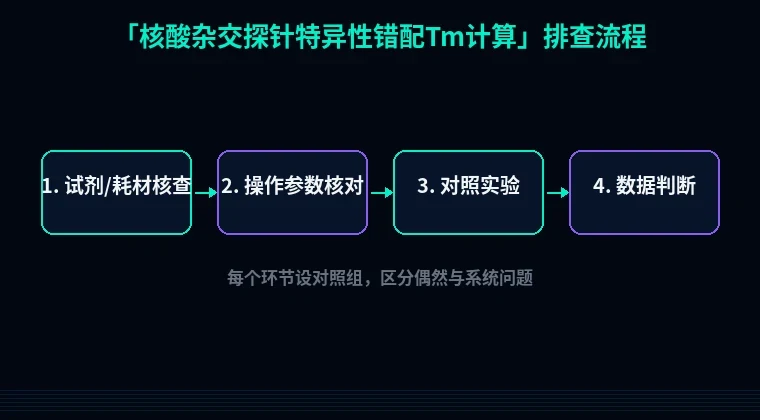
第二步:分维度系统排查
#### 1. 错配位置是否放对了
现象:中心错配能分开,末端错配完全没区分度,杂交信号一样强。
原理:错配去稳定化效应在双链中央最强,越靠两端越弱。末端1–2 nt的错配几乎不影响Tm,ΔTm可能只有0.5–1°C。
解决步骤:把错配位点放探针中央±2 nt范围内;如探针28 nt,突变位点应落在第12–16位;两端各留10 nt以上臂长保证杂交稳定。
验证方法:合成野生型和突变型两条靶标,各做一次熔解曲线,看ΔTm是否≥3°C。低于这个值,别指望洗脱能分开。
#### 2. Tm计算模型与参数是否匹配实际体系
现象:软件算出Tm = 68°C,你62°C杂交,结果信号极弱或者全是非特异条带。
原理:最近邻模型算的是1 M NaCl下的Tm,实际体系要校正。常用近似式Tm = Tm(1M) + 16.6×log10[Na⁺],适用50 mM–1 M;低于50 mM时曲线非线性,这个公式就失效了。
解决步骤:用SantaLucia 1998统一参数计算;输入实际单价阳离子浓度(如杂交液25 mM Tris加50 mM NaCl,按50 mM代入);再加Mg²⁺影响,二价离子按等效Na⁺折算,通常1 mM Mg²⁺约等效于4–5 mM Na⁺。
验证方法:设计一条与靶标完全匹配的探针,实测熔解曲线(260 nm,0.5°C/min升温),把实测Tm与计算值对比。误差超3°C说明参数没输对。
#### 3. 错配ΔTm估算是否过于乐观
现象:你按每个错配降8–10°C设计洗脱温度,实际只降了2–3°C,野生型信号也洗没了。
原理:ΔTm取决于错配类型和邻近碱基。G·T错配最"温和",ΔTm常在1–2°C;C·C、A·G中等;而某些序列环境下(如相邻G·C富集),单错配ΔTm能到5°C以上。平均值按1–3°C估更安全。
解决步骤:先用IDT OligoAnalyzer或Mfold查该错配的预测ΔTm;保守起见按实测优先,不要套平均值;若无实测,初始洗脱温度设为Tm − 5°C,再梯度调整。
验证方法:做洗脱梯度(每档2°C,从Tm − 10°C到Tm),每档取5 μL点膜或跑胶,找出野生型信号保留、突变体信号消失的窗口。窗口宽度常只有2–3°C。
#### 4. 杂交与洗脱温度设定逻辑颠倒
现象:杂交温度定得比Tm还高,或洗脱温度定得比杂交温度低。
原理:杂交温度一般取Tm − 20~25°C(对长探针,>100 nt);对20–30 nt的寡核苷酸探针,杂交温度取Tm − 5~10°C。洗脱严谨度靠温度和盐共同控制,温度升高、盐降低都提高严谨度。
解决步骤:短寡核苷酸探针,杂交温度设Tm − 5°C(如Tm 60°C则55°C杂交),洗脱温度设Tm − 2~5°C;长探针按Tm − 25°C杂交,洗脱用0.1×SSC(约15 mM Na⁺)在Tm − 15°C,即65–68°C。
验证方法:洗脱后用同位素或地高辛抗体检测,看野生型膜片信号是否保留80%以上。
#### 5. 缓冲体系里有个"隐形推手"
现象:把同样的探针换到另一个杂交液里,Tm直接掉了10°C。
原理:甲酰胺每1%(v/v)降低Tm约0.6–0.7°C,DMSO约0.5–0.6°C,尿素(7 M)能降15°C以上。42°C、50%甲酰胺体系里,实际Tm比计算值低约30°C。
解决步骤:把变性剂折算进最终Tm:Tm实际 = Tm计算 − 0.65 × 甲酰胺%(v/v);再决定杂交和洗脱温度。
验证方法:新配一批杂交液,先跑一次熔解曲线确认Tm,再批量用。
#### 6. 探针自身二级结构
现象:探针明明匹配,杂交效率却很低,信号弱且背景干净。
原理:探针自折叠(发夹、二聚体)会占用结合位点,自由能ΔG低于−5 kcal/mol就要警惕。
解决步骤:用Mfold算二级结构,ΔG > −5 kcal/mol可接受;超过就换序列或把发夹碱基换成简并碱基;探针终浓度0.1–1 μM足够,太高反而促二聚体。
验证方法:跑一次非变性PAGE,看是否有前导带(折叠构象)与主带分离。
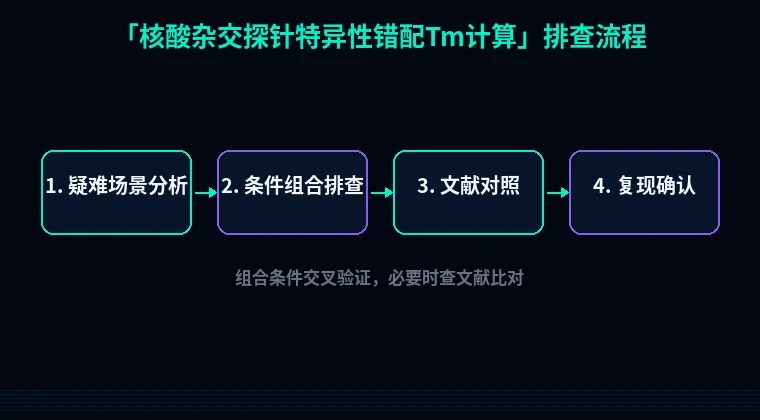
第三步:进阶疑难问题
修饰碱基把ΔTm彻底改写。 LNA每掺一个通常提高Tm 2–8°C(平均3–5°C),这意味着你按DNA算的Tm偏低10°C以上。LNA探针的洗脱温度要单独标定,别复用DNA探针的条件。同理,2'-O-methyl RNA每碱基约+0.5–1°C。
靶标二级结构在跟你抢探针。 提取的RNA或变性不彻底的双链DNA,靶位点本身可能被折叠或双链占据。这时探针浓度再高也没用,因为打不开二级结构。解决:95°C变性5分钟,冰浴2分钟,杂交液里加50%甲酰胺;或改用针对开放区段设计的探针,先用RNAfold看靶位点可及性。
低盐条件下ΔTm出现反转。 当Na⁺低于50 mM,某些错配的ΔTm排序会变,原本能分开的错配反而分不开。所以不要一味追求低盐高严谨度,先把盐锁定在你验证过的条件(如0.1×SSC,约15 mM Na⁺),再调温度。
避坑总结+实操建议
三条核心结论:
1. Tm必须用你的实际盐浓度和变性剂折算,软件默认值直接抄就是给自己挖坑。
2. ΔTm按1–3°C保守估,洗脱窗口只有2–3°C,别按10°C设。
3. 修饰碱基单独标定,LNA、2'-O-methyl不能沿用DNA参数。
两个日常好习惯:每次换杂交液批次,先跑一次熔解曲线确认Tm;探针合成单和计算输入对照着核一遍,序列方向、修饰位点、GC含量三处最容易手滑。
这种位置标完就可以动手了。
算Tm这件事,工具选对能省一半时间。站内的引物设计工具可以顺带算寡核苷酸Tm和二级结构,按最近邻模型输出,直接填盐浓度和甲酰胺比例。探针换成蛋白表达方向的话,密码子优化和蛋白可溶性优化工具也能联动——毕竟探针设计好了,下游验证才跑得顺。