来源:CRISPR脱靶检测全基因组测序(DNA Lab Space 实验教程)| 编译:DNA Lab Space
你花了两个月养细胞、打靶、建库,测完WGS兴冲冲跑完GATK,结果候选脱靶位点列表拉出来三千多个——比sgRNA长度还夸张。这不是CRISPR脱靶率高,大概率是你的检测流程存在系统性假阳性。全基因组测序找脱靶,难点从来不在测序本身,而在从360万个SNV里把真正由Cas9切出来的那十几个位点揪出来。下面按"先查低级错、再分模块深挖、最后攻疑难"的路径,把常见坑一次说透。
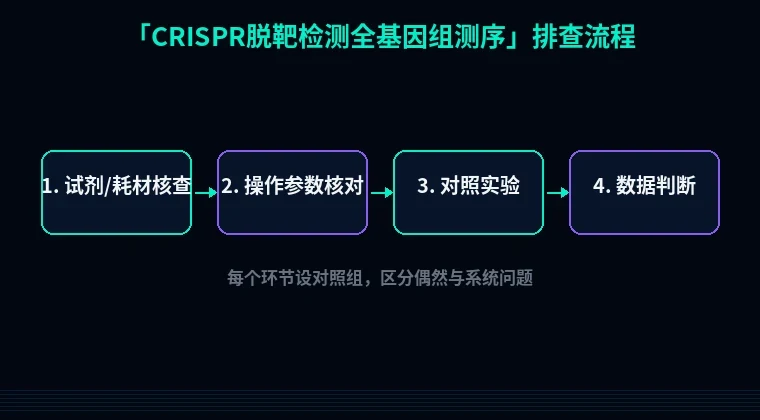
第一步:快速排查低级错误
1. 对照样本拿错了。 你用的"未处理对照"其实是另一批次的细胞,基因组背景差异直接制造出成千上万个假阳性。解决:对照必须和实验组同源、同代次、同批次冻存,最好用同一管细胞分出来。
2. 参考基因组版本不一致。 实验组比对到hg38,对照组用了hg19,坐标系统全乱。解决:所有样本统一bowtie2或BWA比对到同一版本参考基因组,比对前md5校验fasta文件。
3. 没做重复。 单个样本的"脱靶"无法区分技术噪音和真实编辑。解决:每组至少2个生物学重复,候选位点必须在重复间一致出现。
4. 建库批次效应没去。 实验组和对照组不在同一天建库,捕获效率差异被误判为编辑信号。解决:交叉建库,同一天内完成两组文库制备。
第二步:分维度系统排查
按"建库→比对→变异检测→脱靶判定"四段流程逐段排查。
1. 建库与测序深度不达标
现象:候选位点覆盖度只有5×-10×,假阳性率飙到80%以上。
原理:WGS找脱靶依赖足够深度区分真实变异和测序错误。Cas9脱靶位点多为杂合indel,低深度下等位基因比例估计偏差极大。
解决步骤:目标区域平均深度≥50×,候选位点局部≥30×;PE150测序,插入片段350-500 bp。
验证方法:用samtools depth统计候选位点深度,低于20×的直接标记为不可信。
2. 比对参数过于宽松
现象:大量候选位点落在基因组重复区或同源家族区域。
原理:允许过多错配时,reads被错误比对到旁系同源区,产生虚假变异。
解决步骤:BWA-MEM默认参数即可,不要为了"提高比对率"随意调高-m或降低-A。比对后必须去重(Picard MarkDuplicates),MAPQ<30的reads直接过滤。
验证方法:用IGV目视检查候选位点,看是否存在比对堆积异常或clipping。
3. 变异检测流程未针对编辑特点优化
现象:GATK HaplotypeCaller输出大量低质量indel,其中大部分是测序噪音。
原理:标准胚系变异检测假设二倍体、孟德尔遗传,而CRISPR编辑产生的是体细胞嵌合突变,等位比例可能只有5%-20%。
解决步骤:改用针对低频变异的工具如CRISPResso2或BEAN,或手动将GATK的--min-base-quality-score提到20,--standard-min-confidence-threshold-for-calling设为30。候选位点必须满足:支持reads≥8条,等位比例≥5%,且在对照中为0。
验证方法:挑10个候选位点做Sanger测序或靶向深度测序,统计真实阳性率是否>70%。
4. 脱靶预测算法选择不当
现象:纯实验组WGS跑出来几千个候选,无从下手。
原理:全基因组从头找变异噪音太大,必须用预测工具缩小范围再验证。
解决步骤:先用Cas-OFFinder或CRISPOR做序列水平预测(允许3-4个错配,含1个PAM近端错配),得到200-500个候选位点,再在这些位点里查WGS数据。
验证方法:ROC曲线评估——已知脱靶位点是否在预测列表里,假阳性比例是否可接受。
5. 背景变异过滤不彻底
现象:实验组独有的SNV其实是细胞系本身传代积累的漂变。
原理:癌细胞系基因组不稳定,传代20次可积累数百个新SNV。
解决步骤:扩大对照样本量(≥3个),用Mutect2的panel of normals模式,剔除在任一对照中出现的变异。
验证方法:对同一细胞系不同代次做WGS,统计自发突变率,作为背景阈值。
6. 统计阈值没做多重检验校正
现象:p<0.05筛出一大堆"显著"位点。
原理:全基因组做百万次检验,不校正的话假阳性率爆炸。
解决步骤:用Benjamini-Hochberg校正,FDR控制在0.05以下;同时要求候选位点的编辑效率在生物学上合理(通常0.1%-50%)。
验证方法:画QQ图看p值分布是否偏离零假设。
第三步:进阶疑难问题
1. 大片段缺失/结构变异漏检
标准SNV检测流程会漏掉Cas9造成的数百bp到kb级缺失。现象是候选列表干净,但表型异常。解决:用GRIDSS或Manta做SV检测,或直接在候选位点两侧设计引物做长片段PCR。别只盯着small indel。
2. 单细胞克隆扩增引入的假阳性
如果你用单细胞分选后扩增再测序,MDA扩增偏倚会产生大量假变异。现象是脱靶位点在克隆间完全不重叠。解决:改用MALBAC或PicoPLEX,或者直接放弃单细胞路线,用bulk群体测序。
3. 表观遗传修饰干扰变异判定
某些区域存在等位基因特异性甲基化,导致比对和变异检测系统性偏差。解决:对候选位点做Bisulfite测序交叉验证,排除甲基化导致的假象。
避坑总结+实操建议
三条核心结论:
- 对照样本的质量决定整个实验的天花板,宁可多花一周养细胞,也别凑合用一个不同批次的对照。
- 测序深度不到50×,任何脱靶分析都是空中楼阁,先补测再说。
- 预测算法缩范围+WGS验证+靶向测序确认,三步缺一不可,别指望WGS一步到位。
两个日常好习惯:
- 每次实验前用同一管细胞分装出实验组和对照组,冻存备份,避免批次效应。
- 建库当天做一份qPCR定量,确保两组文库的摩尔浓度差异不超过20%。
跑完WGS只是开始。拿到候选位点后,你还需要设计验证引物、优化扩增条件。站内的引物设计工具可以帮你按候选位点上下游200-300 bp直接生成特异性引物,密码子优化工具则能在你做后续回补实验时,把脱靶位点附近的序列改掉而不影响蛋白表达。真要做功能验证,蛋白可溶性优化工具也能帮你把Cas9变体表达量提上去,降低因为蛋白量不足导致的假阴性。工具都在手边,别自己硬扛。