来源:无细胞合成重复性差改善(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做无细胞蛋白合成(CFPS)的人都有过这种体验:同一批裂解物、同一个质粒,周一表达量1.2 mg/mL,周三再做就掉到0.3 mg/mL,荧光读数直接腰斩。你怀疑手法,怀疑试剂,怀疑人生。其实CFPS是个多组分耦合体系,任何一环漂移都会被放大成两三倍的差异。下面这套排查路径覆盖从裂解物制备到检测读数的全流程,照着走一遍,大概率能把重复性拉回±15%以内。
第一步:先查这几个低级错误
别急着怀疑体系,先看这几个新手高频翻车点。
1. 裂解物反复冻融超过3次。S30提取物冻融两次以上,某些批次的活性就掉30%。分装成20–50 μL小管,−80°C一次一管,别拿一整管反复取。
2. 试剂没回温就直接加样。镁离子、NTP、氨基酸母液从−20°C拿出来直接配液,混合后局部浓度不均,孔间CV能飙到25%以上。所有组分冰上解冻后,室温平衡10分钟再配主混液。
3. 96孔板边缘孔做样。边缘孔蒸发快,4小时反应下来体积能少8–10 μL。只用中间孔,边缘孔加PBS封边。
4. 移液器半年没校准,1 μL加样误差>10%。用称重法自检,或者把1 μL母液先稀释10倍再取,别硬刚小体积。
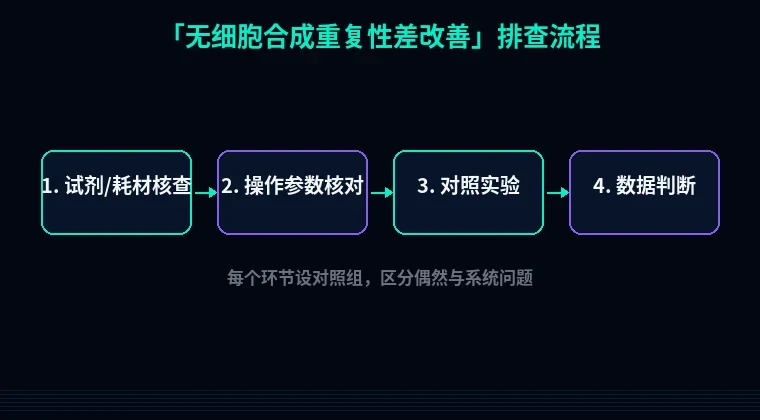
第二步:分维度系统排查
模块A:裂解物批次——这是重灾区
现象:换新批次裂解物后,表达量整体下移,但趋势一致。
原理:大肠杆菌BL21 Star (DE3)的收获时机直接决定S30中核糖体、tRNA和内源能量代谢酶的丰度。OD600到0.6和到1.2收获,抽提物活性差得远。
解决步骤:菌液OD600控制在0.6–0.8时立即冰浴终止,4°C、5000×g离心10分钟收菌;洗涤缓冲液洗两遍;高压破碎后12000×g、4°C离心30分钟去碎片,上清再18000×g离心60分钟;上清加终浓度1 mM DTT,分装−80°C。
验证方法:同一天做三批平行裂解物,用同一个标准质粒(如pET-GFP)测表达量,批间CV<20%才算合格。不合格就固定单一批次,全程用这一批做完所有对比实验。
模块B:镁离子与能量再生体系
现象:反应前1小时正常,2小时后曲线平掉,重复性忽好忽坏。
原理:Mg²⁺既被核糖体需要,又被NTP和磷酸基团螯合。镁离子低了核糖体解离,高了抑制翻译。醋酸镁比氯化镁更温和,常用终浓度12–16 mM,但要随NTP浓度联动调整。
解决步骤:固定Mg-谷氨酸终浓度14 mM敲一版梯度(10、12、14、16、18 mM),选曲线最高点的那一档。能量再生用磷酸肌酸/肌酸激酶体系(各25 mM / 0.1 mg/mL)比PEP体系批间波动小。
验证方法:每批实验同步做Mg梯度板,观察最优值是否漂移。如果最优值从14 mM漂到18 mM,说明你的NTP母液pH变了,重新调pH到7.0。
模块C:反应条件与容器
现象:同配方在不同板/管里结果差一倍。
原理:CFPS是耗氧过程,反应体积越小、比表面越大,氧传递越好,但蒸发也越狠。
解决步骤:统一用低吸附96孔板,反应体积20 μL;30°C、600 rpm振荡孵育4小时;板上加盖透气封膜。
验证方法:同一主混液分装到三种容器(PCR管、普通板、低吸附板)平行做,孔间CV<10%的容器定为标准。
模块D:检测端的隐性偏差
现象:荧光读数重复性差,但目测产量差不多。
原理:GFP荧光受pH和成熟时间影响,pH 7.0和7.5读数差15%。
解决步骤:统一测定时间点(如4小时和20小时各读一次),统一缓冲液pH。做标准曲线时用同批次纯化蛋白。
验证方法:同一反应液分成两管,一管加已知量标准GFP做内标,回收率在85–115%之间说明检测端可信。
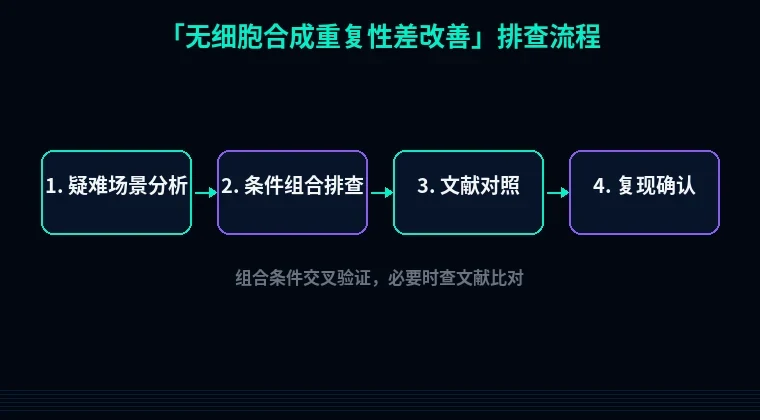
第三步:进阶疑难问题
1. 同批裂解物、同一天做,两次差2倍。 查内源核酸酶。抽提时加终浓度1 mM PMSF和1×蛋白酶抑制剂,破碎后全程冰上操作。跑一版0.8%琼脂糖凝胶,把质粒模板和反应液孵育30分钟,模板降解说明核酸酶没压住。
2. 质粒模板本身出问题。 超螺旋比例低于70%,或者内毒素残留高,翻译效率就崩。用无内毒素质粒抽提试剂盒,A260/A280卡在1.8–1.9,跑胶确认超螺旋带为主。
3. 表达量高但可溶性差,重复性看着差其实是聚集。 加终浓度0.5 M山梨醇或2% PEG8000,降低新生肽链聚集速率;温度降到25°C孵育6小时。上清和沉淀分别跑SDS-PAGE,可溶性比例才是你该盯的指标,不是总荧光。
避坑总结与实操建议
三条核心结论:裂解物批次决定上限,固定一批做完一整个课题;镁离子和能量体系决定曲线的形状,必须每批校一次;容器和检测端决定下限,统一耗材和读数时间是底线。
两条日常好习惯:所有母液分装到单次用量,贴标签写日期和批号,用了就扔;每次实验留一管"标准反应"作内对照,跟新样品一起做,它的读数波动就是你的系统误差。
工具都在手边
配方定下来之后,剩下的变量就是序列本身。模板密码子不适应大肠杆菌,表达量低且批次不稳,先用密码子优化工具把CAI调到0.8以上,再检查5'端二级结构。引物设计用引物设计工具一次配好,避免反复换引物引入新变量。如果目标是可溶性蛋白,上蛋白可溶性优化工具扫一遍序列里的聚集倾向区段,提前改掉几个疏水残基,比事后加PEG8000省事得多。把这些工具的结果固化进你的SOP,重复性自然就稳了。