来源:qPCR标准曲线斜率扩增效率(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做qPCR的人都有过这种时刻:板子跑完,R²=0.998,看着挺美,一点开斜率是-3.9,效率80%。样品Ct倒是齐整,可你心里清楚,这板数据拿去定量,低表达基因的差异全得打折。斜率-3.32才是100%效率,-3.6到-3.1(90%–110%)算能接受,跑出-4.0以上基本就别用了。下面按"先查手误、再拆流程、最后啃硬骨头"三层走,把标准曲线斜率这件事一次说透。
第一步:先别急着怀疑试剂,这4个低级错误最常见
1. 标准品梯度不是独立稀释的。很多人从上一个稀释管里取2 μL加到18 μL,枪头带出的残留让高浓度点被污染,斜率整体偏平。改成每个梯度独立配制:取原液分别稀释,别串葫芦。
2. 只做3个点就敢画曲线。至少5个点,最好6个,每个点3个复孔,覆盖3–4个数量级。点数太少,斜率完全被两端误差绑架。
3. 阈值线用手拖的。自动阈值一旦碰上引物二聚体就会往上跑,Ct整体偏移。改成手动阈值,统一设在指数期扩增曲线上升段的同一位置,所有板子保持一致。
4. 基线终点设在扩增已经起来的位置。基线终点必须在指数期之前,通常取第3–15个循环,设晚了基线被抬高,低浓度点Ct被压缩。
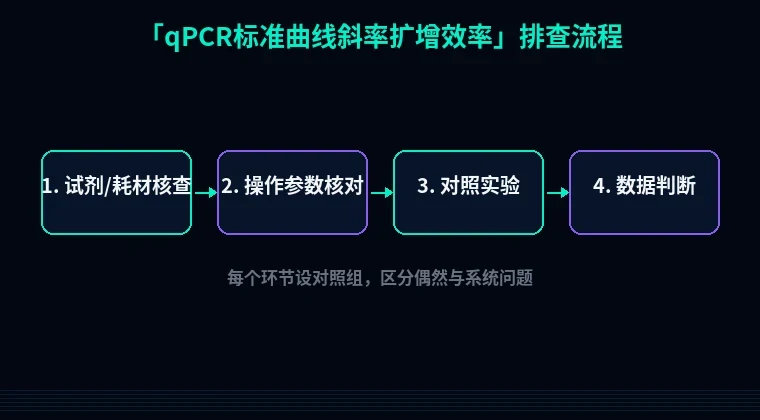
第二步:按流程拆——从模板到数据的9个排查点
1. 稀释液和样品基质不匹配
现象:高浓度点线性很好,最低两个点Ct明显偏高,曲线尾端上翘,斜率变陡(效率掉到80%以下)。
原理:标准品用ddH₂O稀释,而实际样品在TE、裂解液或含EDTA的缓冲液里,离子强度和pH不同,Taq的活性在低浓度模板时被抑制得更明显。
解决:稀释液换成与样品基质一致的缓冲液,或者统一用含10 mM Tris-HCl(pH 8.0)、0.05% Tween-20的稀释液。验证方法:把最低浓度点用两种稀释液各做3个复孔,比Ct,差0.5以上就说明基质在捣乱。
2. 小体积移液误差被放大
现象:只有最低浓度点漂,复孔之间Ct标准差超过0.5。
原理:1 μL的枪打10次,实际体积可能在0.85–1.15 μL之间晃,10倍稀释时这个误差被直接带进浓度。
解决:稀释时用≥5 μL的转移体积,比如5 μL + 45 μL;上样体积提到2 μL以上。枪每年校准一次,低吸附枪头别省。验证方法:用天平称水,10次1 μL取样的重量CV应小于3%。
3. 标准品拓扑结构和长度不一致
现象:效率一直压在85%左右,换模板来源后斜率突变。
原理:质粒标准品是超螺旋,线性化后扩增效率不一样;基因组DNA黏度高,稀释时不容易混匀。
解决:标准品统一用同一种形式,质粒建议单酶切线性化后定量,浓度用Qubit测,别只信NanoDrop的260/280。验证方法:同一浓度线性化与超螺旋质粒各跑一板,Ct差1以上就要统一处理。
4. 引物二聚体偷走了体系资源
现象:NTC在30个循环后起峰,熔解曲线在75°C附近多一个小峰,低浓度标准品Ct推迟。
原理:SYBR Green体系里,二聚体先消耗dNTP和酶,低模板孔最先受影响,斜率因此变陡。
解决:重新设计引物,3'端避开连续3个以上G/C,引物长度控制在18–22 nt,Tm 58–62°C且两条相差不超过2°C。验证方法:跑一板不含模板的NTC,40个循环内起峰就说明有二聚体。
5. 扩增子太长或GC含量过高
现象:效率偏低但重复性好,熔解曲线是单峰。
原理:扩增子超过200 bp,延伸时间不足时短产物优先扩增,长产物积累慢,整体效率下降。
解决:qPCR扩增子控制在70–150 bp,GC含量40%–60%。跨外显子-外显子连接处设计,顺便避开基因组污染。验证方法:跑2%琼脂糖凝胶,条带单一且大小与预期一致。
6. 退火温度偏低
现象:Ct偏早但熔解曲线出现杂峰,斜率不稳。
原理:退火温度低于引物Tm 5°C以上,非特异结合增多,有效引物浓度下降。
解决:从引物Tm减3°C开始做梯度,每档2°C,选Ct最小且熔解曲线单峰的那一档。常用值56–60°C。
7. Master mix反复冻融
现象:同一样品隔天跑,Ct整体差1–2个循环,效率跟着漂。
原理:Taq酶和dNTP反复冻融活性下降,低浓度模板受影响更大。
解决:mix分装成单次用量,-20°C保存,避免反复取用;用前冰上融化、轻弹混匀,别涡旋。
8. 反应体积太小
现象:10 μL体系复孔离散度大。
原理:体积越小,蒸发和移液误差的相对占比越大。
解决:用20 μL体系;96孔板配光学封膜,离心300 ×g、1分钟把液体甩到孔底。
9. 阈值和基线设置不一致
现象:同一批数据换个人分析,斜率差0.2。
原理:阈值决定每个孔的Ct,阈值一动斜率就动。
解决:同一批实验所有板子用同一个阈值设定规则,手动设定在指数期扩增曲线斜率的同一高度;基线取自动但检查每孔基线是否平直。验证方法:把阈值上下调0.02,看斜率变化是否小于0.1。
第三步:三个进阶疑难,能卡住80%的人
1. 效率大于110%,R²还很好
这不是好事。常见原因是低浓度点被抑制物抬高Ct更多,或者有非特异产物在低浓度时占主导。先看熔解曲线有没有双峰,再看NTC。如果曲线干净,把标准品稀释液换成含0.1 mg/mL BSA的TE再跑一次。抑制物来源通常是RNA提取残留的乙醇或胍盐,重新做柱子洗涤就行。
2. 低浓度端曲线明显弯曲
最后两个点偏离直线,不是移液问题就是DNA吸附。DNA在低浓度(<100 copies/μL)时会吸附到管壁和枪头表面。解决:稀释液里加0.05% Tween-20或10 μg/mL tRNA做carrier,稀释后立即上样。也可以把最低点浓度提高,把线性范围缩到3个数量级,别硬撑4个。
3. 多重qPCR里单个靶点斜率偏移
引物之间竞争模板和酶,丰度高的靶点会把低丰度靶点的效率拖下来。解决:把各对引物浓度从900 nM降到200–300 nM分别优化,或者拆成单重反应分别做标准曲线,再折算回多重条件。
避坑总结:3条结论 + 2个日常习惯
- 斜率必须落在-3.6到-3.1之间,对应90%–110%效率,R²≥0.99才好拿去定量。超出范围,先别改数据,先去查移液和稀释。
- 标准品曲线就是一面镜子,它照出的不是模板,是你的移液、你的mix、你的引物设计。哪一环松,斜率就朝哪边歪。
- 每个新引物对都要先跑标准曲线再上样品。跳过这一步,后面所有相对定量都是猜的。
日常好习惯一:每次配稀释系列,先把稀释液分装到八连管,再用同一支枪依次加模板,加完立刻换枪头、封膜、离心。
日常好习惯二:每板必带NTC和至少一个已知浓度的阳性对照,NTC 35个循环内起峰,整板作废重跑。
工具在手,排查更快
引物设计这一步做扎实,后面能省一半麻烦。用站内的引物设计工具,把Tm、GC含量、3'端稳定性、发夹和二聚体一次筛完,直接导出符合qPCR条件的候选对;做跨外显子设计时也可以顺手检查是否覆盖基因组序列。如果你后面还要把qPCR结果接上克隆表达,密码子优化和蛋白可溶性优化工具能接着帮你把下游做完——从定量到表达,一条线走通,不用来回换平台。