来源:核酸定量不准染料选择(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做了一下午的逆转录,Qubit测出来800 ng/μL,兴冲冲跑qPCR,Ct值却比上次高了4个循环。你怀疑RNA降解,怀疑引物二聚体,有没有想过——问题可能出在定量那一步?核酸定量不准,十有八九跟染料选择或使用方式有关。今天这篇,从低级错误到进阶疑难,一次帮你把账算清楚。
第一步:快速排查低级错误
先别怀疑试剂盒,看看这三件事你做了没有。
1. 比色皿搞混了。NanoDrop的基座和微量比色皿测的是不同光程,样品体积不足1 μL时直接读,A260会偏低30%以上。解决:NanoDrop测核酸至少1.5 μL,用0.5 mm光程基座时更要注意液滴是否完整。
2. 空白对照用错了缓冲液。用TE测的空白,样品却溶在无核酸酶水里,背景吸光值不匹配。解决:空白和样品必须用同一种缓冲液,体积也要一致。
3. Qubit工作液配好放了太久。Qubit染料稀释后2小时内稳定,放一上午荧光就淬灭了。解决:工作液现配现用,避光保存,30分钟内上机。
4. 标准品稀释梯度算错了。标准品母液反复冻融,浓度已经不准,曲线R²看着不错,实际斜率偏了。解决:标准品分装-20°C保存,避免反复冻融,每次新开一管。
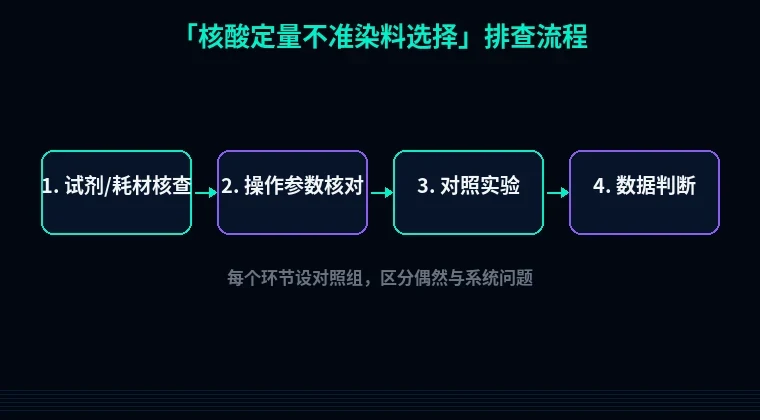
第二步:分维度系统排查
1. 先分清你到底要测什么
荧光染料法测的是“染料能结合到的核酸”,紫外法测的是“所有在260 nm有吸收的东西”。如果你的样本里混了蛋白质、苯酚、胍盐,A260/A280比值好看不代表浓度准确。苯酚在270 nm有吸收,胍盐在260 nm附近也有贡献,直接拉高表观浓度。
怎么判断:跑一个已知浓度的标准品加标回收。取10 μL 100 ng/μL标准品,加90 μL你的样品缓冲液,Qubit测值如果偏离100 ng/μL超过15%,说明缓冲液本身有干扰。
解决:换用对污染物不敏感的染料体系。Qubit dsDNA HS对盐和蛋白质耐受性远好于PicoGreen,而PicoGreen在低浓度dsDNA(0.2-100 ng/mL)线性更好。
2. 染料和核酸类型匹配了吗
这是翻车重灾区。用Qubit dsDNA HS去测RNA,染料几乎不结合,读数直接掉到零头。用RiboGreen测DNA,同样无效。有些染料号称“广谱”,实际对ssDNA和RNA的量子产率只有dsDNA的1/10。
怎么判断:拿同一份样本,分两管,一管加RNase A(10 mg/mL,37°C 30分钟),一管不加,分别用你的染料测。如果两管读数差异小于10%,说明你的染料不区分DNA和RNA。
解决:测dsDNA用Qubit dsDNA HS或PicoGreen;测RNA用Qubit RNA HS或RiboGreen;测ssDNA用Qubit ssDNA。别混用。
3. 染料/样品比例对了吗
Qubit标准流程是1:199(样品:工作液),有人为了省样品只加1 μL样品到199 μL工作液,移液器误差被放大10倍。更常见的是样品浓度超过染料线性上限,荧光信号饱和,读数偏低。
怎么判断:把样品稀释10倍再测,如果测值×10和原值差异超过20%,说明原浓度超出线性范围。
解决:Qubit dsDNA HS线性范围0.2-100 ng/μL(原液),超出就稀释。RNA HS线性范围1-100 ng/μL。每次测之前估计一下浓度,落在范围中段最准。
4. 孵育时间和温度控制住了吗
Qubit室温孵育2分钟是下限,5分钟更稳。但有人孵育30分钟,荧光反而下降——染料光漂白。温度低于20°C时,结合动力学变慢,2分钟根本不够。
怎么判断:同一管样品,孵育2分钟和5分钟各读一次。差异超过10%,说明你的条件没稳。
解决:室温25°C左右孵育5分钟,避光。冬天实验室温度低,水浴或培养箱调到25°C再孵育。
5. 仪器校准和读值方式
Qubit出厂校准一次,后面用标准品做两点校准。如果你跳过校准直接测,或者标准品过期,读数可能偏50%以上。NanoDrop的基座残留上次样品,也会拉高背景。
怎么判断:用同一标准品连续测三次,CV超过5%说明仪器状态不稳。
解决:Qubit每次开机用标准品做校准;NanoDrop每次测样前用ddH₂O清洗基座,擦干再上样。测完一批样品,回头再测一次标准品,偏差超过10%要重做。
6. 样品本身的降解和抑制剂
RNA样本里残留的乙醇、异丙醇会抑制染料结合。DNA样本里的EDTA浓度超过10 mM,会螯合Mg²⁺影响某些荧光染料。反复冻融的核酸,片段化后染料结合位点减少,Qubit读数比实际低。
怎么判断:跑一个琼脂糖凝胶,看条带是否完整。RNA的28S/18S比值低于1.5,说明降解严重。
解决:RNA用70%乙醇洗两次,风干后溶在无核酸酶水里。DNA样本EDTA浓度控制在1 mM以下。降解严重的样本重新提取,别硬测。
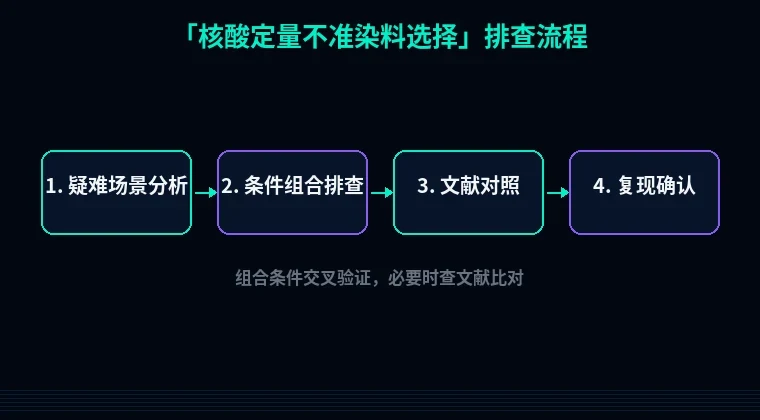
第三步:进阶疑难问题
问题一:染料饱和导致的“假低值”
高浓度dsDNA样本(>200 ng/μL)用Qubit HS测,染料结合位点饱和,荧光信号不再线性增加。你读出来150 ng/μL,实际可能是400 ng/μL。这时候需要换用BR(Broad Range)染料,线性范围扩展到1000 ng/μL。判断方法:稀释5倍和10倍各测一次,计算原浓度,两个值差异超过30%就是饱和了。
问题二:GC含量偏好性
PicoGreen对高GC含量的dsDNA结合效率比AT-rich低15-20%。如果你测的是高GC的基因组DNA或PCR产物,Qubit读数可能偏低。解决办法:用与样本GC含量接近的标准品做曲线,或者换用Qubit dsDNA BR,它对GC偏好性小一些。
问题三:微量样本的吸附损失
浓度低于0.5 ng/μL的样本,DNA会吸附在管壁上。Qubit测出来比实际低50%以上。加0.01% Tween-20或直接用低吸附管,能减少损失。测cfDNA或单细胞扩增产物时,这一步不能省。
避坑总结+实操建议
三条核心结论:
1. 先确认核酸类型,再选染料。dsDNA、RNA、ssDNA的染料不能混用。
2. 荧光法测的是“染料结合量”,污染物和降解都会拉低读数。A260/A280比值只能看纯度,不能用来算浓度。
3. 每次测样前做标准品校准,测完再测一次标准品验证。偏差超过10%整批重做。
两条日常好习惯:
- 标准品分装成单次用量,-20°C保存,用一管扔一管,别反复冻融。
- Qubit工作液现配现用,配好后避光,30分钟内上机。剩的别留着下次用。
工具推荐
定量准了,后面才顺。如果你正在做qPCR引物设计,直接用站内的引物设计工具,输入序列自动出引物,Tm和GC含量都帮你算好。做蛋白表达的,密码子优化工具能按你的宿主偏好优化序列,蛋白可溶性优化工具帮你提前规避包涵体。定量是第一步,后面的每一步都别踩坑。