来源:RNA-seq链特异性差建库方向排查(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做完RNA-seq,跑infer_experiment.py一看,两个方向的reads各占一半,链特异性直接判failed。建库重复一遍、测序重来一轮,钱花了,问题还在。其实链特异性差很少是单一环节崩掉,多数时候是某个酶、某个参数、某个文件版本被忽略。这篇按建库流程逐段拆,从RNA投入到数据判读,把能踩的点一次说清。
第一步:先查4个新手最常犯的低级错误
1. 试剂盒根本没选链特异性类型。普通RNA-seq建库试剂盒不保留链信息,跑完就是50:50。看说明书第一页,确认是否标注"strand-specific"或"dUTP method"。不是的话换试剂盒,别怀疑数据。
2. 分析时BED文件用错版本。参考基因组是GRCh38,BED却用了GRCh37的注释,染色体坐标全错位。直接看`head`比对文件里的染色体名是"chr1"还是"1",跟BED保持一致。
3. 比对参数没开链特异性。HISAT2要加`--rna-strandness RF`(dUTP法),STAR要加`--outSAMstrandField intronMotif`。漏掉参数,下游infer_experiment的结果必然塌掉。
4. aualysis命令调错。infer_experiment.py核心是`-r 100000`,少于这个数统计波动大,判读极不稳定。样本量少就直接把`-r`设成全部reads。
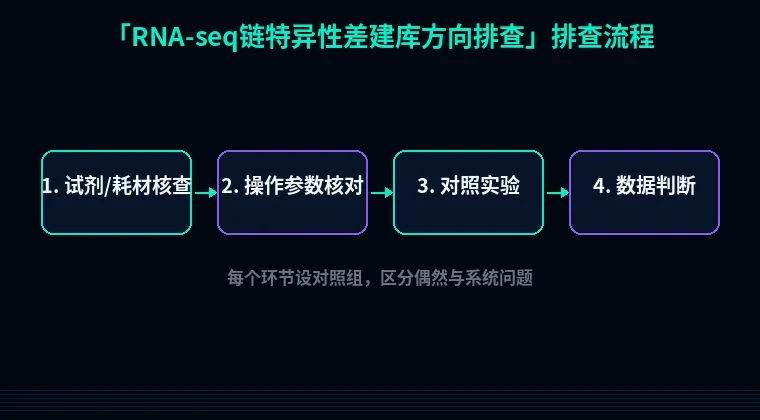
第二步:分维度系统排查(按实验流程)
环节一:RNA投入与片段化
1. RNA降解严重。 现象:RIN值低于6,片段化后小片段扎堆200 bp以下。原理:降解的RNA富集短片段,反转录时第一链合成不完整,第二链更容易被误合成。解决:RIN≥7再进库,投入量控制在100 ng–1 µg总RNA。验证:Agilent 2100跑一次,看28S/18S比值是否≥1.5。
2. 片段化时间过头。 现象:插入片段集中在150–180 bp,接头二聚体明显。原理:片段太短,第一链和第二链长度接近,链区分度降低。解决:94°C片段化时间降到5–6分钟(NEBNext体系)。验证:Bioanalyzer High Sensitivity芯片跑一轮,主峰落在250–300 bp为佳。
环节二:反转录与第二链合成(核心环节)
3. 反转录酶活性不足。 现象:cDNA产量低,PCR要跑到18个循环以上。原理:第一链没合成完,残留的RNA在第二链合成时被当成模板,方向信息混乱。解决:换SuperScript IV或ProtoScript II,42°C孵育15 min后70°C灭活15 min。验证:qPCR测cDNA产量,Ct值应比RNA对照低8个循环以上。
4. dUTP掺入比例不对。 现象:infer_experiment两个方向都接近0.5。原理:第二链合成时dUTP替代dTTP,USER酶才能特异切掉第二链;掺入不足,第二链被保留下来双向信号叠加。解决:第二链buffer里dTTP必须换成dUTP,10 mM each dNTP中,dUTP与dATP/dGTP/dCTP等摩尔。验证:取2 µL第二链产物跑2%琼脂糖凝胶,条带应集中在300–500 bp。
5. Actinomycin D漏加。 现象:链特异性从0.85掉到0.6附近。原理:放线菌素D抑制DNA依赖的DNA合成,阻断第二链以第一链为模板的副反应。解决:第一链反应体系里加0.5 µg/µL放线菌素D,终浓度别超1 µg/µL,否则抑制反转录酶本身。验证:对照组加/不加放线菌素D,跑infer_experiment对比方向比例。
环节三:USER酶消化
6. USER酶加量或时间不够。 现象:第二链残留,链特异性信号被稀释。原理:USER酶(尿嘧啶DNA糖基化酶+核酸内切酶VIII)切含dUTP的第二链,37°C 15 min是标准条件。解决:每管加1 µL USER酶(NEB M5505),37°C孵育15 min,别超20 min。验证:消化后取5 µL跑胶,第二链条带消失即成功。
7. 消化后没纯化干净。 现象:下游PCR出现非特异条带。原理:USER酶残留会切后续PCR产物中的尿嘧啶。解决:消化后用1.0×AMPure XP磁珠纯化,洗脱15 µL。验证:NanoDrop测浓度,A260/A280在1.8–2.0之间。
环节四:PCR扩增与接头连接
8. PCR循环数过高。 现象:文库复杂度低,链特异性统计波动。原理:循环数越多,错误掺入越多,方向信号被噪声淹没。解决:起始cDNA 1 ng以上,PCR循环控制在12–15个。验证:qPCR监控扩增曲线,荧光到平台期前2个循环就停。
9. 接头连接效率低。 现象:需要更多PCR循环补量。原理:接头没连上,文库有效浓度低,被迫加循环。解决:连接体系20°C孵育15 min,接头:插入片段摩尔比10:1。验证:连接后取2 µL跑胶,出现约320 bp的接头-插入片段产物。
环节五:数据分析判读
10. infer_experiment参数设置。 现象:结果在两个方向间跳动。原理:读段数太少,统计不稳定。解决:`-r 200000`,BAM文件用排序后的。验证:看输出里"Fraction of reads explained by"两个数值,dUTP法应一个>0.85,另一个<0.15。
11. 注释文件与比对参考不匹配。 现象:结果明显偏低但建库没问题。原理:GTF/BED染色体命名或版本不一致,读段被随机分配。解决:用`grep "^chr"`核对BED和BAM的染色体名,统一用GENCODE或Ensembl同一版本。验证:`samtools view -H`看@SQ行,与BED的chrom列表逐一对照。
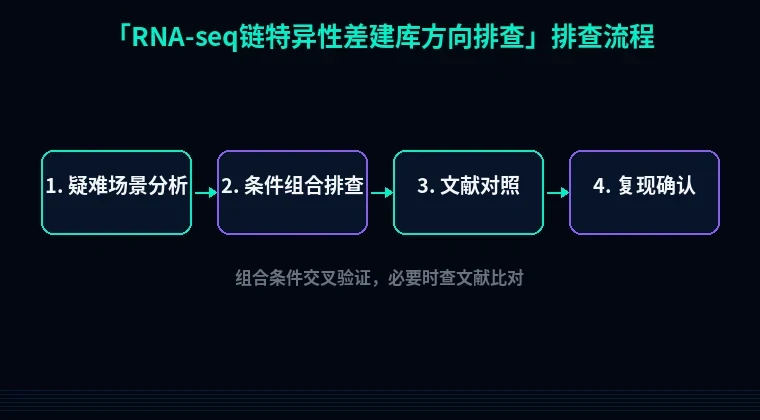
第三步:进阶疑难问题
12. 样本本身有大量反义转录本。 现象:链特异性比例正常,但某个基因的反义信号异常高。原理:部分基因(如印记基因、Xist)天然存在反义转录本,不是建库问题。解决:先跑`featureCounts -s 2`看反义计数分布,全基因组层面正常就放心。验证:看整体strandness,不要盯着单个基因。
13. 多个文库混合上机。 现象:同一lane里链特异性结果有的好有的差。原理:index hopping或pooling比例失衡,导致reads错配。解决:每个文库加不同index,pooling前用Qubit定量,等摩尔混样。验证:拆分后单独跑infer_experiment,每个样本分开判读。
14. 降解样本混入DNA污染。 现象:基因组DNA残留导致背景信号。原理:gDNA没有链特异性,会拉低整体比例。解决:DNase I消化,37°C 10 min,然后加EDTA灭活。验证:跑`-s 1`和`-s 2`对比,如果两者结果接近,说明有双链污染。
避坑总结+实操建议
三条核心结论:
- 链特异性差,九成出在第二链合成和USER消化环节,别一上来就怀疑测序。
- dUTP掺入比例和放线菌素D是关键变量,缺一个方向就乱。
- 数据分析前先核对BED、BAM、GTF三者版本,版本不对,后面全白费。
两条日常好习惯:
- 每批次建库留一个阳性对照(已知链特异性的RNA),跑完先测对照再上样本。
- 建库完成后立刻跑Bioanalyzer,主峰位置和浓度一起记录,别等测序完再回头找问题。
工具上,如果你在建库前需要设计链特异性引物,可以直接用站内的引物设计工具,自动避开反向互补区的干扰。做原核样本的,密码子优化工具能顺手把表达框调整到适合dUTP法的反转录偏好。蛋白表达验证阶段,蛋白可溶性优化工具帮你判断表达产物是不是可溶,避免因为样本本身质量拖垮建库。这几步串起来,链特异性问题基本不会再反复。