来源:蛋白翻译后修饰质谱鉴定丢失保护(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做PTM质谱的人,多少都栽过这个坑:富集前WB上磷酸化条带清清楚楚,富集完上机,搜出来的磷酸肽还没背景肽多。更气人的是,非修饰肽段鉴定上千,磷酸化位点个位数。别急着怪质谱仪。问题大概率出在样品制备、富集和搜库参数这三段路里。这篇把从裂解到搜库的全链条拆成可执行动作,每步都给判断标准和验证方法,照着走,能把“修饰丢失”压缩到最小。
第一步:先排掉这几个新手级错误
1. 裂解液里没加磷酸酶抑制剂——细胞一破,内源磷酸酶几分钟就把信号啃干净。解决:裂解液现配现加10 mM NaF、1 mM Na₃VO₄、1×磷酸酶抑制剂cocktail,全程冰上。
2. 烷基化忘了避光或时间不够——半胱氨酸氧化让肽段质量飘+16 Da,修饰肽段匹配全乱。解决:55 mM IAA室温避光30 min,最后加DTT至终浓度10 mM淬灭15 min。
3. 除盐上样液有机相太高或洗脱太猛——磷酸肽直接流穿。解决:StageTip用0.1% FA上样,0.1% FA/50% ACN洗脱,别图快。
4. 搜库没勾可变修饰——磷酸化S/T/Y一个没选,软件当然“鉴定不到”。解决:MaxQuant里Phospho (STY)设为可变修饰,位点定位概率阈值定在0.75以上。
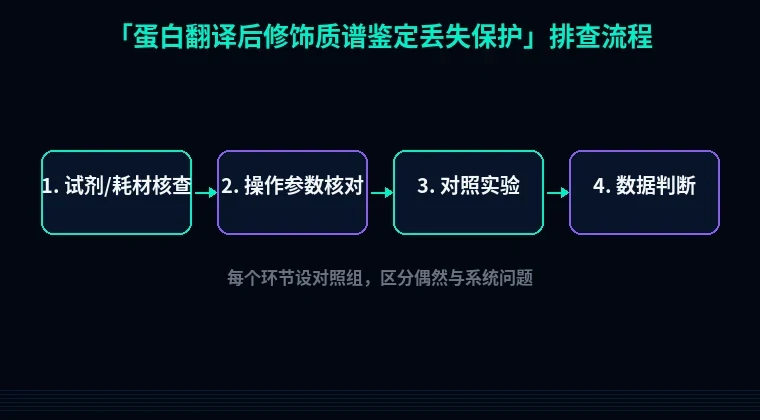
第二步:按流程分模块系统排查
模块A:裂解与变性——修饰是被酶“拆掉”的
1. 裂解速度太慢
现象:磷酸肽比例忽高忽低,同批次重复性差。
原理:磷酸酶、去乙酰化酶在裂解瞬间释放,4°C下仍保留活性。
解决:细胞用预冷PBS洗两遍,直接加8 M urea裂解液(含抑制剂)刮下,冰上超声3×10 s,功率20%,全程不超过5 min。组织样本液氮研磨后再加裂解液。
验证:平行做一份不加抑制剂的对照,若磷酸肽数掉一半以上,说明抑制剂方案必须固定。
2. 变性不彻底
现象:酶切效率低,长肽段多,修饰位点被漏切肽段“包住”。
原理:尿素浓度低于6 M时部分蛋白复性,酶切位点被遮蔽。
解决:裂解液尿素终浓度保持8 M,蛋白浓度控制在1–2 μg/μL,别为了省料稀释过度。
模块B:还原烷基化与酶切——修饰肽段被“切碎”或“切不动”
3. 酶切漏切率过高
现象:修饰肽段长度集中在25–40 aa,MS/MS碎片不足,位点定位概率低于0.75。
原理:修饰位点两侧若漏切,前体离子电荷分布变差,碎裂效率下降。
解决:Trypsin按1:50(w/w)加,37°C孵育16 h;补加1:100酶再消化4 h。尿素稀释到2 M以下再酶切。
验证:搜库看漏切率,控制在15%以内算合格。
4. 过度酶切
现象:肽段普遍短于7 aa,修饰肽段在C18柱上保留差。
解决:酶量别超过1:20,时间不超18 h,酶切后立刻加FA至0.5%终止。
模块C:富集——大多数“丢失”发生在这里
5. TiO₂/IMAC富集条件跑偏
现象:富集后非修饰肽段占比超过70%,磷酸肽 enrichment efficiency 低于50%。
原理:TiO₂在pH<2.5时对磷酸基团有选择性,有机相比例不够会竞争结合。
解决:TiO₂上样液配80% ACN/2% TFA/饱和谷氨酸(250 mg/mL),pH调至2.0–2.5;肽段与beads按1:4(w/w)4°C旋转30 min;洗脱用5% NH₄OH(pH 10.5),洗两次合并。
验证:取1/10富集产物做MS,看磷酸肽占比;低于50%就重调pH和ACN比例。
6. 富集后肽段吸附损失
现象:富集前肽段总量50 μg,洗脱后回收不到20%。
解决:全程用低吸附管(LoBind),洗脱液加0.01% DDM,离心20000 g 10 min取上清,别碰管壁。
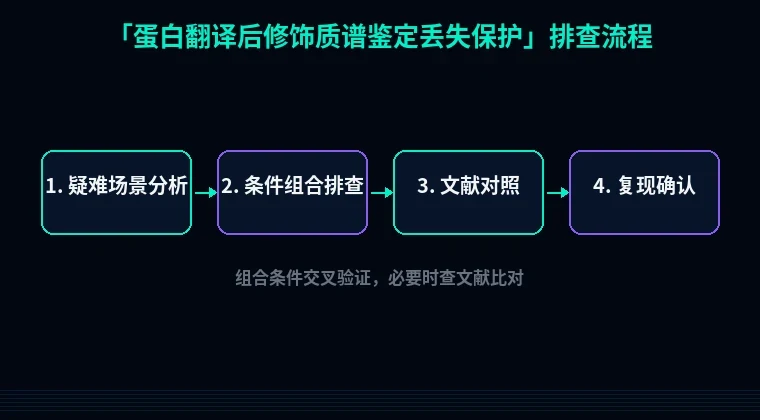
模块D:LC-MS/MS——修饰肽段“信号被压制”
7. 磷酸肽电离效率低
现象:非修饰肽段TIC很强,磷酸肽提取离子色谱图几乎平。
原理:磷酸基团带负电,正离子模式下信号抑制明显。
解决:上样液加20% ACN提高保留;流速降到300 nL/min;DDA top20,动态排除30 s;HCD用阶梯碰撞能量25/30/35%。
验证:跑一针合成磷酸肽标准品(如100 fmol),看信噪比是否大于10。
模块E:搜库参数——鉴定结果“被过滤掉”
8. 修饰位点定位阈值过严
现象:原始文件里能看到磷酸肽前体,但结果表里没位点。
解决:MaxQuant里PTM localization probability阈值先放宽到0.5看趋势,再收紧到0.75出终稿;磷酸化肽段FDR单独统计,别和总肽段混在一起。
第三步:进阶疑难问题
9. 低丰度修饰肽段被高丰度蛋白“淹没”
起始量低于200 μg时,高丰度结构蛋白占掉大量柱容量。做法:起始蛋白提到500 μg–1 mg;或用Top12/Top14去高峰度蛋白柱先扫一遍,再富集。别在低起始量上硬堆富集次数,越富集损失越大。
10. 多位点修饰的位点定位“打架”
一个肽段上两个磷酸化位点,HCD碎片里中性丢失严重,定位概率卡在0.6。换ETD或EThcD碎裂,或合成同位素标记标准肽做内标,用保留时间对齐确认。这一步别省,审稿人最爱问位点可信度。
11. “假丢失”:修饰本来就不在样品里
刺激时间太短、抑制剂加错靶点、细胞代次太老,都会让修饰水平本身很低。先做WB或Phos-tag胶确认修饰存在,再上质谱。质谱不是用来“找”修饰的,是用来“定位”修饰的。
避坑总结与实操建议
三条核心结论:
- 磷酸化鉴定丢失,七成出在富集前的裂解和富集时的pH/有机相,不在质谱仪。
- 每一步都要留“验证取样点”:裂解后、酶切后、富集后各留1/10,出问题能立刻定位到段。
- 搜库参数先放宽再收紧,别一上来就用严阈值把真信号筛掉。
两个日常好习惯:
- 裂解液现配现用,抑制剂单独分装冻存,别反复冻融。
- 每批实验带一个合成磷酸肽标准品做阳性对照,回收率低于40%就停手查富集。
工具推荐
排查完实验端,别忘了序列端也可能埋雷。做定点突变验证修饰位点时,用站内引物设计工具一次生成带磷酸化位点突变的引物,省得手动算Tm。做重组蛋白表达验证修饰功能,密码子优化工具能按宿主调 codon usage,蛋白可溶性优化工具帮你避开包涵体——毕竟修饰酶表达不出来,下游质谱再灵敏也白搭。