来源:CRISPR编辑脱靶检测全基因组测序(DNA Lab Space 实验教程)| 编译:DNA Lab Space
脱靶检测做完,GUIDE-seq或WGS跑出来几百个候选位点,真正可信的没几个。这种痛做过编辑的都懂。问题多半不在测序仪,而在实验设计和生信过滤这两头。下面按排查顺序拆开讲:从低级失误、建库捕获、生信阈值一路捋到嵌合体和结构变异,最后给几条避坑实话。照着走,大概率能找到你那份“假阳性清单”的来源。
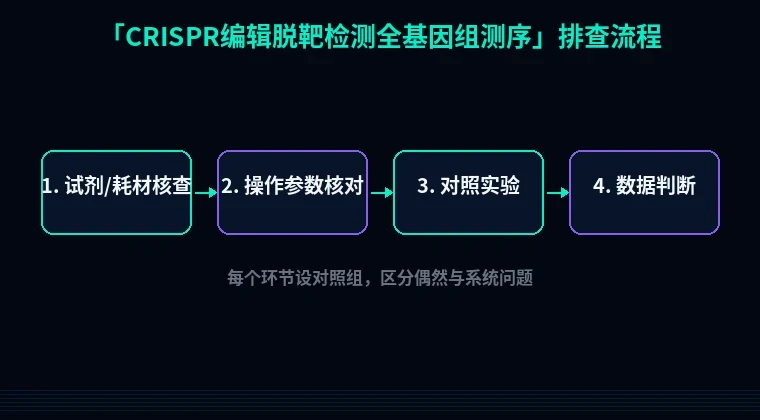
第一步:先查这几个低级错误
1. 参考基因组版本对不上。编辑用的是GRCh38,比对却拿GRCh37的fa,候选位点坐标全错位。解决:确认编辑质粒、细胞系、参考基因组三者版本一致,重跑比对。
2. sgRNA序列录错一个碱基。 spacer里U/T写反或末尾多写一个G,体外预测的脱靶位点从源头就是错的。解决:回查原始订单和质粒测序峰图。
3. 样本标签搞混。编辑组和对照组的index写反,结果“脱靶”全是组间差异。解决:先看对照组候选位点数量,正常应远少于编辑组。
4. PCR扩增循环数太高。35个循环以上,嵌合PCR错误直接进了候选清单。解决:降到25–28个循环,高保真酶扩增。
第二步:分维度系统排查
1. 建库与捕获环节:候选位点为什么“虚高”
现象:WGS报出上千个候选脱靶位点,远超同类实验报道的几十到几百量级。
原理:全基因组测序靠深度覆盖区分真实编辑事件和背景噪音。30×以下深度时,杂合脱靶位点的支持reads数可能只有2–3条,落在测序错误率区间内。
解决步骤:编辑组样本测到≥60×,对照组≥30×;建库起始DNA提到500 ng–1 μg,别用100 ng硬撑;打断片段主峰控制在350–450 bp。
验证:用IGV抽查10个候选位点,看编辑组是否≥5条独立reads支持、对照组是否为0。
2. 比对与变异 calling:假阳性最爱藏的地方
现象:候选位点集中在基因组重复区和同源基因家族。
原理:二代测序100–150 bp读长跨不过重复序列,比对歧义直接产生假SNV。CRISPR脱靶本身又偏好种子序列匹配,同源家族天然高危。
解决步骤:比对用BWA-MEM,加-M标记split reads;变异calling加`-q 30 -Q 20`过滤;对候选位点做50 bp侧翼序列BLAT,同源性>90%的直接标为低置信。
验证:把候选位点用Sanger测序在编辑组和对照组各扩一遍,200–300 bp产物,真阳性应只在编辑组出现双峰。
3. 脱靶位点的独立验证:别只信一套方法
现象:WGS候选清单和GUIDE-seq结果对不上,交集不到三成。
原理:WGS灵敏度受深度限制,GUIDE-seq受细胞摄取和DNA末端捕获效率限制。两者互补,单一方法必漏。
解决步骤:取WGS top 50候选位点,设计扩增子做amplicon-seq,每个位点≥1000×;同时用T7E1或TIDE做快速初筛,T7E1酶切37°C孵育30分钟,2%琼脂糖跑胶。
验证:三种方法交集≥2种支持的位点才算高置信;单一方法命中的进“观察名单”。
4. 对照设置:没有它,一切都是空谈
现象:未编辑对照组也报出一批“脱靶位点”。
原理:细胞传代、克隆扩增、建库PCR都会引入背景突变,没有对照就无法扣除。
解决步骤:同批次、同代次、同培养条件的未编辑细胞做对照,建库同一天完成;生信端做对照组减除,只保留编辑组特有且对照为0的位点。
验证:统计对照组候选位点数,若超过编辑组的20%,先怀疑建库或比对问题,别急着下结论。
第三步:进阶疑难问题
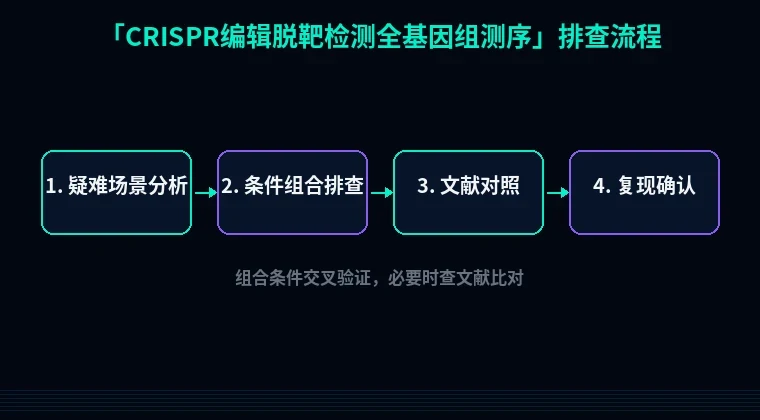
1. 大片段缺失和结构变异被漏掉
短读长WGS对>100 bp的缺失、倒位、易位基本无感。CRISPR切割后非同源末端连接常产生大片段缺失,常规calling直接漏检。换用长读长测序(Nanopore/PacBio)或做靶向ddPCR定量,才能看见这类事件。
2. 嵌合体和克隆异质性
混合细胞群测序,一个脱靶位点可能只在10%细胞里存在,reads支持数被稀释到阈值以下。做单克隆分离,每个克隆单独测序,或把细胞群体分成亚群分别建库,才能分清“真低频脱靶”和“测序噪音”。
3. 生信阈值定太死
把VAF阈值卡在5%,低频真脱靶全被筛掉;放到1%,假阳性又爆炸。建议分两档:≥5%进高置信清单,1%–5%进待验证清单,用amplicon-seq逐个确认。
避坑总结与实操建议
三条核心结论:
1. 深度不够,一切白搭。编辑组60×是底线,重复区再加20%。
2. 对照组不是摆设。没有同批次对照,候选清单的可信度打对折。
3. 两种方法起步,三种方法定论。WGS加GUIDE-seq打底,amplicon-seq收尾。
两个日常好习惯:
- 每次实验前把sgRNA序列、参考基因组版本、样本index写进一张实验记录表,跑完对照一遍。
- 建库PCR循环数、酶批次、DNA起始量全部记录,出问题时能回溯到具体环节。
工具层面也别硬扛。sgRNA设计阶段先用站内CRISPR sgRNA设计工具把候选位点的脱靶评分拉出来,优先选特异性评分高的spacer;做碱基编辑或需要表达融合蛋白的,用密码子优化工具调序列;如果后续要做脱靶位点的蛋白水平验证,蛋白可溶性优化工具能帮你把表达构建体一次做对。设计端少留坑,检测端才不用反复补。