来源:DNA适配体筛选富集轮次PCR偏倚(DNA Lab Space 实验教程)| 编译:DNA Lab Space
做SELEX的人都懂,前几轮筛得很顺利,CT值稳步提升,结合率也涨得不错。可到了第6到第8轮,富集曲线却突然变得平缓。测序一查,文库多样性也减少了,同一序列家族占据的比例远远超出预期。问题很可能不在筛选本身,而在每一轮富集之后那次看似简单的PCR扩增。下面讲的全是PCR偏倚:它怎么发生、怎么判断、怎么修,从模板量到单链分离,一步步说清。
第一步:先排除这4个新手错误,大多问题都出在这里
1. 上一轮洗脱的模板投得太多。 洗脱液取5 μL直接进50 μL PCR,模板拷贝数可能已经冲到10^11以上。此时模板会聚成团,取1-2 μL就够,或者先做10倍稀释。
2. 循环数凭习惯固定为20个。 模板量一变,所需循环数也得变。先跑一个小体积qPCR看看Ct,再确定终产物PCR的循环数。
3. 引物工作液配错。 有人把100 μM母液当10 μM直接加1 μL,导致终浓度变成10倍;也有人反复冻融导致引物降解。新配一支10 μM工作液,分装成小管。
4. 上一轮回收后忘了换缓冲液,或者乙醇残留。 磁珠或胶回收产物里带乙醇或高盐,会直接抑制聚合酶活性。
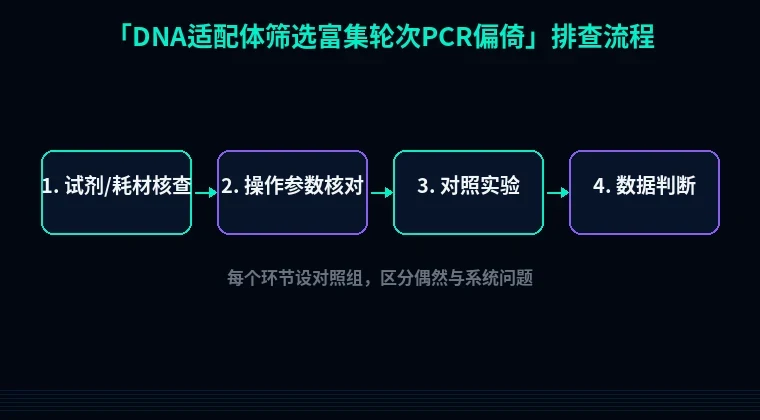
这四条花20分钟就能过一遍。如果接下来还不行,再往下看。
第二步:按流程分维度系统排查
1. 模板投入量与循环数的匹配(最常见)
现象:PCR产物条带很亮,但测序结果显示多样性骤降;或者产物跑胶能看到明显的高分子量弥散带和下方小片段。
原理:PCR在指数期扩增,各序列的扩增效率差异会被放大。进入平台期后,扩增效率高的短序列、低GC序列会占据绝对优势。这就是偏倚的核心来源。10^8个模板分子和10^12个模板分子对同一个循环数的反应完全不同。
解决步骤:① 洗脱产物先取1 μL做10倍梯度稀释(10^-1到10^-3);② 每个梯度用SYBR Green qPCR跑一遍,体系为20 μL:2× Mix 10 μL、10 μM引物各0.4 μL、模板2 μL,95°C 3 min,然后95°C 15 s / 58°C 30 s / 72°C 30 s,共40循环;③ 取Ct值落在15-22之间的稀释度做制备型PCR;④ 循环数=该稀释度Ct值对应的循环数+2,通常落在10-14个循环。
验证方法:制备型PCR只跑12个循环,上8%非变性PAGE,目标条带单一且无下方弥散,说明偏倚可控。
2. GC含量与二级结构造成的扩增偏好
现象:某些已知的高GC家族在高通量测序中从第5轮起就消失了,或者反过来说,低GC家族异常爆发。
原理:随机文库的GC含量呈正态分布,极端GC序列的熔解温度差可达15°C以上。统一用58°C退火时,高GC模板解链不充分,扩增效率被压低三到五倍。
解决步骤:① 退火温度降到55°C,延伸时间从30 s延长到45 s;② 加入终浓度1 M甜菜碱或者3% DMSO,50 μL体系加5 μL DMSO;③ 换用Q5或Pfu高保真酶,它们对二级结构的耐受性更好;④ 预变性改成98°C 30 s,前5个循环用touchdown:65°C降到58°C,每循环降1.5°C。
验证方法:拿第0轮的原始文库做对照扩增,跑胶看产物量。野生型条件下原始文库的产物量应明显高于富集文库,否则说明你的体系本身就在筛GC。
3. 引物区突变导致的"扩增失联"
现象:某一轮之后,不论怎么优化PCR条件,产物量就是起不来。
原理:随机文库两端各有18-22 nt固定引物区。筛选压力下,个别序列在引物区发生点突变或缺失,与引物3'端错配。聚合酶对3'端错配极其敏感,效率掉到百分之一以下。这类序列直接"退出"了后续轮次。
解决步骤:① 每3轮取一份PCR产物做NGS,专门比对两端引物区,统计错配频率;② 如果错配率>15%,换用简并引物:在引物3'端倒数第2、3位引入简并碱基(如N或次黄嘌呤);③ 或者设计巢式引物,把结合位点向文库内部移动3-5 nt。
验证方法:用新引物扩增同一批模板,比较产物量;同时用NGS确认新引物没有引入额外偏好。
4. 单链分离这一步的隐性偏倚
现象:双链PCR产物量正常,但下一轮结合实验的回收率莫名下降。
原理:链霉亲和素磁珠法、不对称PCR、λ外切酶消化,这三条路各有偏好。不对称PCR中,两条链的扩增效率本来就不对称;磁珠法受生物素化效率影响,短链更容易被洗掉。
解决步骤:① 不对称PCR时,把正向引物降到0.2 μM、反向引物保持1 μM,循环数控制在15个以内;② 磁珠法用0.2 mg磁珠/100 μL体系,结合15 min,洗两次后加0.15 M NaOH室温孵育5 min洗脱;③ 无论哪种方法,单链产物上8%变性尿素PAGE确认条带位置。
验证方法:单链产物取100 pmol做下一轮结合,回收率应稳定在0.5-2%;如果波动超过三倍,说明单链制备不稳定。
5. 非特异产物与小片段堆积
现象:跑胶底部出现引物二聚体条带,或出现比目标片段短20-30 bp的杂带。
原理:富集后期模板复杂度下降,引物二聚体容易占据主导,消耗dNTP和酶,进一步压低真实模板的扩增。
解决步骤:① 引物浓度降到0.2 μM;② 循环数控制在12个以内;③ 产物切胶回收目标条带,8% PAGE切80-100 bp区间;④ 加2% DMSO抑制二聚体。
验证方法:切胶回收后再扩增一轮,杂带不复现就算解决。
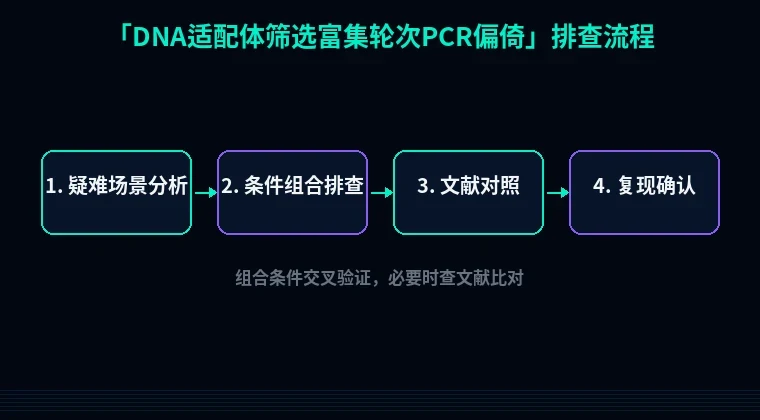
第三步:进阶疑难,这些问题往往藏得深
① Jackpot效应与管间偏倚。 同样的模板、同样的条件,10管平行PCR的产物测序结果居然不一样。这是早期循环中某个模板分子偶然提前扩增造成的。对策是把一个反应拆成10管,每管25 μL,条件完全一致,跑完合并。这招能把管间标准差压到15%以下。
② NGS数据里的"假富集"。 某个家族从第4轮到第6轮占比从0.3%跳到40%,你以为是真靶标。先别激动。回头查一下该序列的GC含量和引物区匹配度,如果GC中等偏低、引物区完全匹配,那十有八九是PCR偏好而非真结合。做一次不加靶标的负筛对照轮,看它是否同样涨。
③ 文库长度异质性。 有的序列中间缺失一段,变成60 bp的短链,扩增效率天然高一截。用变性PAGE每轮监控长度分布,一旦出现短链比例上升,立刻切胶纯化目标长度区间。
避坑总结与两条日常习惯
三条核心结论:模板量宁少勿多,10^9拷贝起步;循环数跟着Ct走,永远不打到平台期;每3轮做一次NGS和PAGE双重监控,不要只盯结合率。偏倚是累积的,第8轮才发现就晚了。
两个习惯值得坚持:每次PCR都留一份"原始文库对照管"一起跑,比对产物量,能第一时间发现体系偏好;所有引物、缓冲液分装成单次用量,-20°C保存,避免反复冻融带来的批次漂移。
把设计端的问题也一并解决
筛选端排查完了,很多时候根源在设计端。文库两端引物如果和随机区有二级结构互补,扩增偏倚从第0轮就埋下了。这时候可以用站内的引物设计工具,把两端固定区与随机区一起输入,检查二聚体和发夹结构。如果下游要表达适配体或做蛋白融合,密码子优化工具和蛋白可溶性优化工具能帮你提前避掉表达端的坑。毕竟筛出来的序列,最终是要用的。